 wehub-resource-sync
28 KiB
Note
本文档由 WeHub 基于上游 README 翻译整理,属于社区翻译,非官方中文文档。
English · 原始项目 · 上游 README
原作者、版权与许可证归属以原始项目及本仓库 LICENSE 文件为准。


Burn 既是张量库,也是深度学习框架,针对
数值计算、训练与推理进行了优化。
训练与推理通常分属两个世界。模型一般在 Python 中训练,再导出为 ONNX 等开放格式,或针对 vLLM、ONNX Runtime、TensorRT 等生产引擎进行优化。这一导出步骤往往脆弱且会有信息损失,从而排除复杂架构与高级部署场景。
Burn 将二者统一起来。通过单一统一 API 执行跨平台张量运算,用于训练的代码与生产环境运行的代码完全一致。这使得端侧个性化、联邦学习(federated learning)等工作负载变得简单,同时让团队能在同一代码库中从原型走向部署。
Burn 保留了 PyTorch 直观易用的体验,支持动态形状与计算图,但会对张量运算流进行 JIT 编译,并自动进行内核融合(kernel fusion)。你既能获得动态图的灵活性,又不必承受性能下降。
Rust 适合科研吗?
Rust 过去在科研领域并不讨喜:漫长的编译时间会打断研究人员青睐 Python 的快速编辑-编译-运行循环。Burn 改变了这一范式。围绕增量编译设计,修改模型代码后即使在 release 模式下也能在 5 秒内完成重编译。这带来了类似 Python 的反馈循环,同时具备 Rust 的速度与安全性。
生态系统
Burn 是一个不断成长的、完全开源的 Rust AI 生态系统的核心。你采用的不只是单一库,而是加入涵盖 GPU 计算、模型互操作与领域工具包的整套技术栈,并有充足空间参与塑造下一步发展方向。
| Category | Project | Description |
|---|---|---|
| Compute | CubeCL | Burn 加速后端背后的 GPU 计算语言与编译器。用 Rust 编写内核一次,即可在 CUDA、ROCm、Metal、Vulkan 和 WebGPU 上运行。可独立使用。 |
| Model interop | burn-onnx | 将 ONNX 模型导入 Burn,生成为原生 Rust 代码 |
burn-store |
保存、加载并导入模型权重,包括 PyTorch 与 Safetensors | |
| Domains | burn-vision |
计算机视觉算子与构建模块 |
burn-rl |
强化学习构建模块 | |
burn-dataset |
数据集加载、变换与开箱即用的数据源 | |
| Models | models | 基于 Burn 构建的精选预训练模型与示例 |
| Tooling | burn-bench | 对后端进行基准测试与对比,并跟踪性能随时间的变化 |
Burn 的 CubeCL 后端(CUDA、ROCm、Metal、Vulkan、WebGPU、
CPU)可与 autodiff、fusion 与 remote-execution 装饰器组合;而外部及更简单的
后端(LibTorch 与纯 Rust CPU/no_std)仅与 autodiff 组合。完整矩阵见下方
Supported Backends。
此处的每个项目均为开源并持续开发。想参与共建 Rust AI 生态? good first issues 是很好的起点, Contributing 指南可帮助你完成环境配置。
社区 crate 🌱
这些 crate 不由 Tracel 维护,但同属 Rust AI 故事的一部分。任何有助于加载数据、构建环境或交付模型的项目都可列入此处。有合适作品?提交 PR 将其加入!
| Category | Crate | Description |
|---|---|---|
| Data & loading | polars | 面向表格数据的快速 DataFrame |
| arrow-rs | Apache Arrow 列式内存格式 | |
| image | 图像解码、编码与处理 | |
| hf-hub | 从 Hugging Face Hub 下载模型与数据集 | |
| Tokenization & NLP | tokenizers | 快速、可用于生产的分词器 |
| rust-bert | 开箱即用的 NLP 流水线与 Transformer 模型 | |
| Numerical & linear algebra | ndarray | N 维数组 |
| nalgebra | 线性代数 | |
| Classical ML | linfa | 经典机器学习工具包,理念类似 scikit-learn |
| smartcore | 经典机器学习算法,无需 BLAS/LAPACK | |
| Inference & runtimes | candle | 极简 ML 框架,侧重 LLM 推理 |
| mistral.rs | 快速、多模态 LLM 推理引擎 | |
| ort | 面向硬件加速推理的 ONNX Runtime 绑定 | |
| tract | 面向 ONNX 与 NNEF 模型的纯 Rust 推理 | |
| wonnx | 100% Rust、WebGPU 加速的 ONNX 运行时,适用于原生与 Web | |
| LLM apps & RAG | rig | 构建模块化 LLM 应用与智能体 |
| langchain-rust | LangChain 风格的链式编排 | |
| Embeddings & vector search | fastembed | 在本地生成文本嵌入与重排序 |
| qdrant | 用 Rust 编写的向量搜索引擎 | |
| lancedb | 嵌入式、对开发者友好的向量数据库 | |
| Computer vision | kornia-rs | 底层 3D 计算机视觉库 |
| Simulation & environments | rapier | 面向机器人与 RL 环境的物理引擎 |
| Visualization | rerun | 多模态数据与 CV/机器人可视化 |
| plotters | 绘图与图表 |
Backend
Burn 致力于在尽可能多的硬件上尽可能快地运行,并提供健壮的实现。我们相信,这种灵活性对现代需求至关重要——你或许在云端训练模型,随后在客户的各类硬件上部署,而每台设备的配置都不尽相同。
Supported Backends
大多数后端支持所有操作系统,因此我们不在下表中逐一列出。
GPU Backends:
| CUDA | ROCm | Metal | Vulkan | WebGPU | LibTorch | |
|---|---|---|---|---|---|---|
| Nvidia | ☑️ | - | - | ☑️ | ☑️ | ☑️ |
| AMD | - | ☑️ | - | ☑️ | ☑️ | ☑️ |
| Apple | - | - | ☑️ | - | ☑️ | ☑️ |
| Intel | - | - | - | ☑️ | ☑️ | - |
| Qualcom | - | - | - | ☑️ | ☑️ | - |
| Wasm | - | - | - | - | ☑️ | - |
CPU Backends:
| Cpu (CubeCL) | Flex | LibTorch | |
|---|---|---|---|
| X86 | ☑️ | ☑️ | ☑️ |
| Arm | ☑️ | ☑️ | ☑️ |
| Wasm | - | ☑️ | - |
| no-std | - | ☑️ | - |
与其他框架相比,Burn 在支持多种后端方面采用了截然不同的方法。从设计上讲,大部分代码都针对 Backend trait 泛型化,这使我们能够构建可替换后端的 Burn。这使得组合后端成为可能,并可用自动微分(autodifferentiation)和自动 kernel 融合(automatic kernel fusion)等附加功能对其进行增强。
Autodiff:为任意后端带来反向传播的 Backend 装饰器 🔄
与上述后端不同,Autodiff 实际上是一个后端_装饰器_。这意味着它不能独立存在;必须封装另一个后端。
只需用 Autodiff 包装一个基础后端,即可透明地为其配备自动微分支持,从而能够对模型调用 backward。
use burn::backend::{Autodiff, Wgpu};
use burn::tensor::{Distribution, Tensor};

fn main() {
    type Backend = Autodiff<Wgpu>;

    let device = Default::default();

    let x: Tensor<Backend, 2> = Tensor::random([32, 32], Distribution::Default, &device);
    let y: Tensor<Backend, 2> = Tensor::random([32, 32], Distribution::Default, &device).require_grad();

    let tmp = x.clone() + y.clone();
    let tmp = tmp.matmul(x);
    let tmp = tmp.exp();

    let grads = tmp.backward();
    let y_grad = y.grad(&grads).unwrap();
    println!("{y_grad}");
}
值得注意的是,你不可能在运行于不支持 autodiff(用于推理)的后端上的模型上误调用 backward,因为该方法仅由 Autodiff 后端提供。
更多细节请参阅 Autodiff Backend README。
Fusion:为所有第一方后端带来 kernel 融合的 Backend 装饰器
该后端装饰器可为后端增强 kernel 融合能力,前提是内部后端支持该功能。请注意,你可以将此后端与其他后端装饰器(例如 Autodiff)组合使用。所有第一方加速后端(如 WGPU 和 CUDA)默认使用 Fusion(burn/fusion feature flag),因此通常无需手动应用。
#[cfg(not(feature = "fusion"))]
pub type Cuda<F = f32, I = i32> = CubeBackend<CudaRuntime, F, I, u8>;

#[cfg(feature = "fusion")]
pub type Cuda<F = f32, I = i32> = burn_fusion::Fusion<CubeBackend<CudaRuntime, F, I, u8>>;
值得注意的是,我们计划基于计算密集型(compute bound)和内存密集型(memory bound)操作实现自动梯度检查点(automatic gradient checkpointing),它将能与 fusion 后端良好配合,使训练期间的代码运行得更快;详见 this issue.
更多细节请参阅 Fusion Backend README。
Remote(Beta):用于远程后端执行的后端装饰器,适用于分布式计算
该后端包含两部分:一个客户端和一个服务端。客户端通过网络将张量运算发送至远程计算后端。你只需一行代码即可将任意第一方后端用作服务端:
fn main_server() {
    // Start a server on port 3000.
    burn::server::start::<burn::backend::Cuda>(Default::default(), 3000);
}

fn main_client() {
    // Create a client that communicate with the server on port 3000.
    use burn::backend::{Autodiff, RemoteBackend};

    type Backend = Autodiff<RemoteDevice>;

    let device = RemoteDevice::new("ws://localhost:3000");
    let tensor_gpu =
        Tensor::<Backend, 2>::random([3, 3], Distribution::Default, &device);
}
Training & Inference
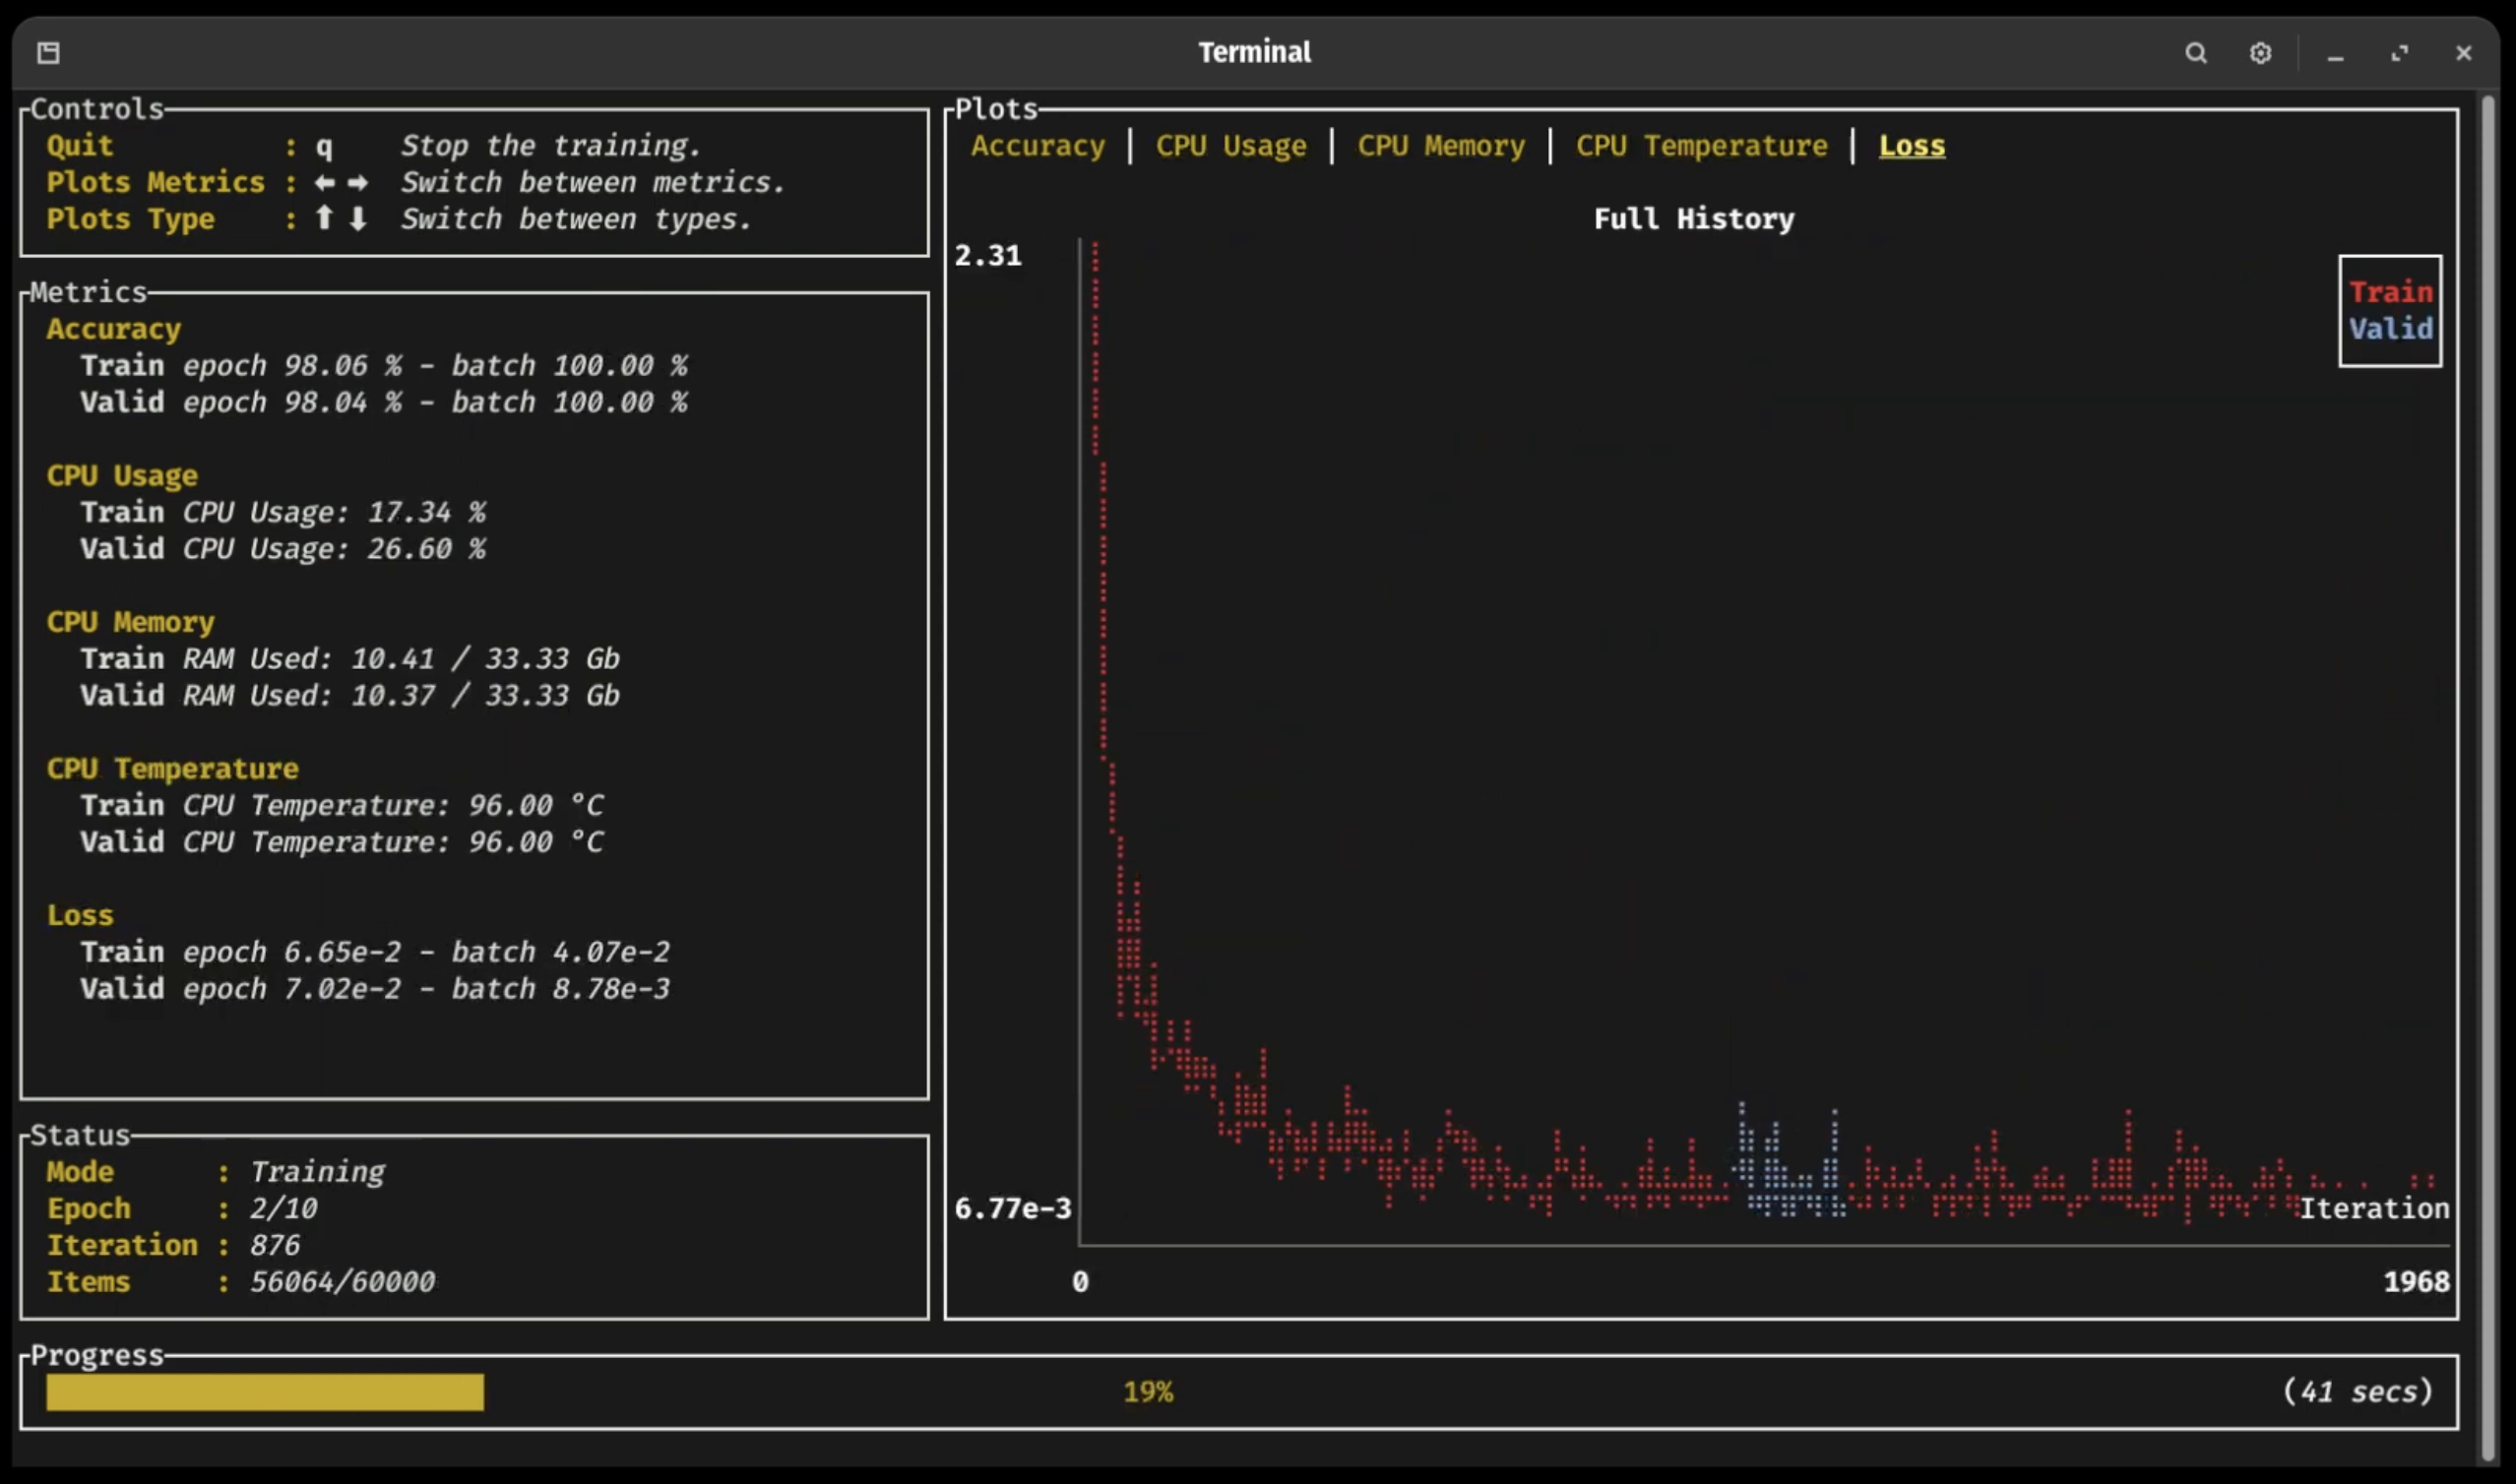
借助 Burn,整个深度学习工作流变得更加轻松:你可以通过符合人体工学的仪表盘监控训练进度,并在从嵌入式设备到大型 GPU 集群的各类环境中运行推理。
Burn 从设计之初就兼顾训练与推理。同样值得一提的是,与 PyTorch 等框架相比,Burn 简化了从训练到部署的过渡,无需修改代码。
点击以下章节展开 👇
Training Dashboard 📈
如你在上一段视频中(点击图片!)所见,基于 Ratatui crate 的全新终端 UI 仪表盘让用户无需连接任何外部应用,即可轻松跟踪训练过程。
你可以实时查看训练与验证指标的更新,并仅使用方向键分析任意已注册指标的长期走势或近期历史。可在不导致崩溃的情况下跳出训练循环,从而让潜在的检查点完整写入,或让重要代码片段不受干扰地完成 🛡
ONNX Support 🐫
Burn 支持通过 burn-onnx crate 导入 ONNX(Open Neural Network Exchange)模型,让你能够轻松将 TensorFlow 或 PyTorch 模型迁移到 Burn。ONNX 模型会被转换为使用 Burn 原生 API 的 Rust 代码,使导入的模型可在任意 Burn 后端(CPU、GPU、WebAssembly)上运行,并受益于 Burn 的全部优化,例如自动 kernel 融合。
我们的 ONNX 支持在 Burn Book 的 this section of the Burn Book 🔥. 中有进一步说明。
Note
: 该 crate 正在积极开发中,目前仅支持 limited set of ONNX operators.
Importing PyTorch or Safetensors Models 🚚
你可以将 PyTorch 或 Safetensors 格式的权重直接加载到 Burn 定义的模型中。这样既能复用现有模型,又能享受 Burn 的性能与部署特性。
更多信息请参阅 Burn Book 的 Saving & Loading Models 章节。
Inference in the Browser 🌐
我们的多个后端可在 WebAssembly 环境中运行:Flex 用于 CPU 执行,WGPU 通过 WebGPU 提供 GPU 加速。这意味着你可以直接在浏览器内运行推理。我们提供了多个相关示例:
嵌入式:no_std 支持 ⚙️
Burn 的核心组件支持 no_std.。这意味着它可以在裸机(bare metal)环境(例如没有操作系统的嵌入式设备)中运行。
截至目前,只有 Flex 后端可以在 no_std 环境中使用。
基准测试
为了评估不同后端的性能并跟踪随时间的改进,我们提供了专用的基准测试套件。
使用 burn-bench. 运行并比较基准测试
⚠️ 警告 使用
wgpu后端之一时,你可能会遇到与递归类型求值相关的编译错误。这是由于wgpu依赖链中存在复杂的类型嵌套。要解决此问题,请在main.rs或lib.rs文件顶部添加以下行:#![recursion_limit = "256"]由于深度嵌套的关联类型(associated types)和 trait 约束,默认递归限制(128)通常刚好低于所需深度(通常为 130-150)。
入门指南
刚听说 Burn?你来对地方了!继续阅读本节,我们希望你能很快上手。
The Burn Book 🔥
要高效使用 Burn,理解其核心组件与设计理念至关重要。因此我们强烈建议新用户阅读 The Burn Book 🔥. 的前几节。书中提供详细示例与说明,涵盖框架的方方面面,从张量(tensors)、模块(modules)、优化器(optimizers)等构建块,到进阶用法(例如编写自己的 GPU 内核)。
项目仍在持续演进,我们会尽可能让书籍与新增内容保持同步。但有时可能遗漏一些细节,若发现异常请告诉我们!我们也欢迎 Pull Request 😄
示例 🙏
先看一段代码片段,感受框架使用的直观性!下面,我们声明一个带若干参数的神经网络模块及其前向传播(forward pass)。
use burn::nn;
use burn::module::Module;
use burn::tensor::backend::Backend;

#[derive(Module, Debug)]
pub struct PositionWiseFeedForward<B: Backend> {
    linear_inner: nn::Linear<B>,
    linear_outer: nn::Linear<B>,
    dropout: nn::Dropout,
    gelu: nn::Gelu,
}

impl<B: Backend> PositionWiseFeedForward<B> {
    pub fn forward<const D: usize>(&self, input: Tensor<B, D>) -> Tensor<B, D> {
        let x = self.linear_inner.forward(input);
        let x = self.gelu.forward(x);
        let x = self.dropout.forward(x);

        self.linear_outer.forward(x)
    }
}
仓库中有相当数量的 示例,展示如何在不同场景下使用该框架。
按照 书籍:
- Basic Workflow :创建自定义 CNN
Module,在 MNIST 数据集上训练并用于推理。 - Custom Training Loop :实现基础训练循环,而非使用
Learner。 - Custom WGPU Kernel :学习如何使用 WGPU 后端创建自己的自定义算子。
更多示例:
- Custom CSV Dataset :实现用于解析 CSV 数据的数据集,以完成回归任务。
- Regression :在 California Housing 数据集上训练简单 MLP,预测各街区房屋价格中位数。
- Custom Image Dataset :按简单文件夹结构,在自定义图像数据集上训练简单 CNN。
- Custom Renderer :实现自定义渲染器以显示
Learner进度。 - Image Classification Web :使用 Burn、WGPU 与 WebAssembly 的图像分类浏览器演示。
- MNIST Inference on Web :浏览器中的交互式 MNIST 推理演示。该演示可 在线. 体验
- MNIST Training :演示如何训练自定义
Module(MLP),并配置Learner以记录指标并保存训练检查点。 - PyTorch Import Inference :导入在 MNIST 上预训练的 PyTorch 模型,使用 Burn 对样本图像进行推理。
- Text Classification :在 AG News 或 DbPedia 数据集上训练文本分类 Transformer 模型。训练后的模型可用于对文本样本进行分类。
- Text Generation :在 DbPedia 数据集上训练文本生成 Transformer 模型。
- Wasserstein GAN MNIST :训练 WGAN 模型,基于 MNIST 生成新的手写数字。
若想获得更实用的体验,可克隆仓库并在你的计算机上直接运行其中任意示例!
预训练模型 🤖
我们维护一份持续更新、精选的 Burn 构建模型与示例列表,详见 tracel-ai/models 仓库。
找不到想要的模型?欢迎提交 issue,我们可能会优先安排。你用 Burn 构建了模型并想分享?也可以提交 Pull Request,将模型添加到社区栏目!
为何用 Rust 做 AI?🦀
深度学习是一种特殊的软件形态:既需要高层抽象,又需要极快的执行速度。Rust 正是这一场景的理想选择——它提供零成本抽象,便于构建神经网络模块,并对内存进行细粒度控制以优化每一个细节。至今,主流方案仍以 Python 提供 API,却依赖对 C/C++ 等底层语言的绑定。这会降低可移植性、增加复杂度,并在研究人员与工程师之间制造摩擦。Rust 的抽象方式足够灵活,可应对这种「双语言」割裂;而 Cargo 让在任何环境中构建、测试与部署都变得简单——这在 Python 中往往是痛点。
Rust 的 AI 生态仍年轻,但真实存在且增长迅速。基础组件已就位:Burn 与 CubeCL 用于训练与计算,candle 用于推理,Hugging Face 的 tokenizers 与 safetensors,以及 polars 与 ndarray 用于数据。今天押注 Rust,意味着押注一个仍在成长、贡献者仍能塑造方向的技术栈。尚未存在的组件是机遇而非死胡同(参见 贡献)。
Rust 还让「一套技术栈,处处可用」成为可能:无需附带 Python 运行时,只需一个自包含二进制文件,即可从服务器运行到 no_std 嵌入式目标。
弃用说明
自0.14.0起,张量数据的内部结构已变更。原先的Data结构体已被弃用,并自0.17.0起正式移除,改用新的TensorData结构体;后者将底层数据以字节形式存储,并将数据类型作为字段保存,从而更灵活。若代码中仍在使用Data,请务必迁移至TensorData。
从先前版本加载模型记录 ⚠️
如果你正在尝试加载在早于 0.14.0 的版本中保存的模型记录,请
确保使用兼容版本(0.14、0.15 或 0.16),并启用 record-backward-compat
功能标志。
features = [..., "record-backward-compat"]
否则,该记录将无法被正确反序列化,你会收到一条错误消息。该错误 消息也会指向向后兼容的功能标志。
在加载记录时,反序列化方面保持了向后兼容性。因此, 一旦你重新保存该记录,它将按新结构保存,你就可以 升级回当前版本
请注意,二进制格式不向后兼容。因此,你需要在旧版本中加载记录,
并将其保存为其他任一自描述记录格式(例如,使用
NamedMpkFileRecorder),然后再使用兼容版本(如前所述)并启用
record-backward-compat 功能标志。
Community
如果你对这个项目感兴趣,欢迎加入我们的 Discord! 我们尽力欢迎来自 任何背景的人。你可以向社区提问,并分享你的成果!
Contributing
在贡献代码之前,请阅读 Contributing Guidelines 和我们的 Code of Conduct。Contributor Book 涵盖架构、环境搭建以及常见任务的指南。
Status
Burn 目前处于积极开发中,可能会有破坏性变更(breaking changes)。虽然由此产生的问题 通常较容易修复,但现阶段无法提供任何保证。
License
Burn 根据 MIT 许可证和 Apache License(Version 2.0)的条款进行分发。 详见 LICENSE-APACHE 和 LICENSE-MIT。提交 pull request 即视为同意这些许可条款。