> [!NOTE]
> 本文档由 WeHub 基于上游 README 翻译整理,属于社区翻译,非官方中文文档。
> [English](./README.en.md) · [原始项目](https://github.com/tashfeenahmed/freellmapi) · [上游 README](https://github.com/tashfeenahmed/freellmapi/blob/HEAD/README.md)
> 原作者、版权与许可证归属以原始项目及本仓库 LICENSE 文件为准。
# FreeLLMAPI
**一个 OpenAI 兼容端点。18 家免费 LLM 提供商。161 个免费模型。每月约 17 亿 token。**
将 Google、Groq、Cerebras、NVIDIA、Mistral、OpenRouter、GitHub Models、Cohere、Cloudflare、HuggingFace、Z.ai(智谱)、Ollama、Kilo、Pollinations、LLM7、OVH AI Endpoints、OpenCode Zen 和 AI Horde 的免费套餐,以及自定义 OpenAI 兼容的聊天、嵌入、图像和音频端点,聚合到单一 `/v1` API 之后。密钥加密存储。路由器为每个请求选择当前最佳可用模型,在某家提供商触发速率限制时自动故障转移到下一家,并跟踪每个密钥的用量,确保你始终不超出各家免费套餐上限。
[](https://github.com/tashfeenahmed/freellmapi/actions/workflows/ci.yml)
[](https://github.com/tashfeenahmed/freellmapi/stargazers)
[](./LICENSE)
[](#contributing)
[](https://github.com/tashfeenahmed/freellmapi/pkgs/container/freellmapi)
[](https://deepwiki.com/tashfeenahmed/freellmapi)
**[freellmapi.co](https://freellmapi.co)** · 在实时目录中浏览全部 161 个免费模型
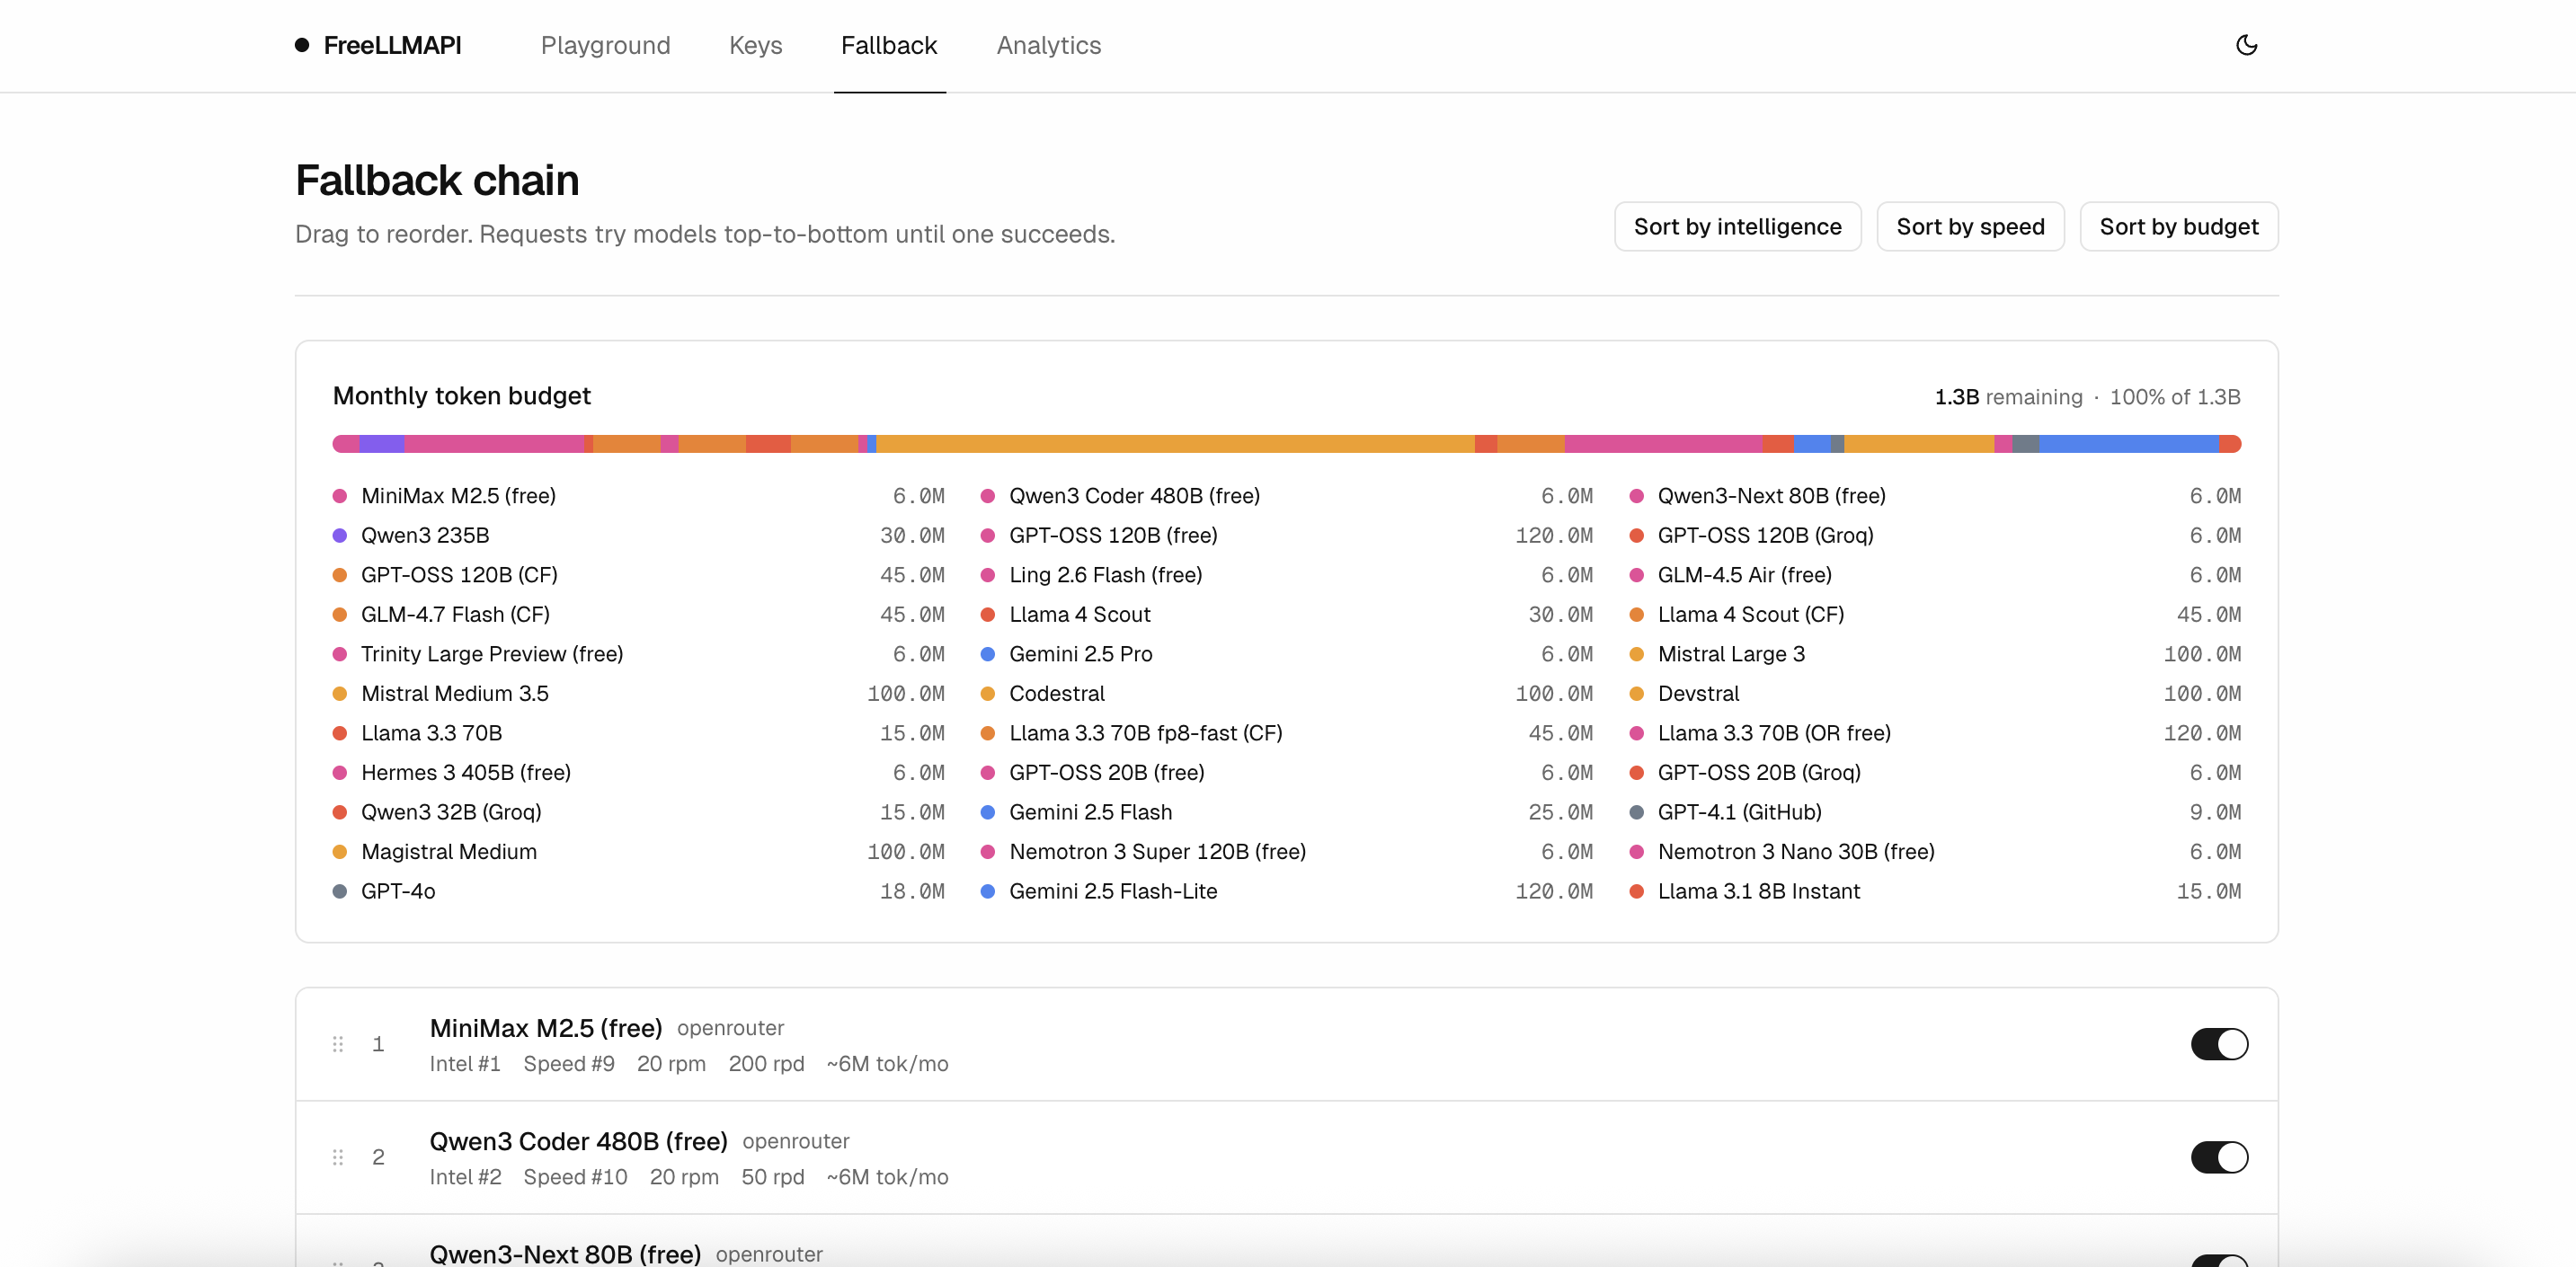
你的路由器会自动更新模型目录。免费安装在新模型上线 30 天后才能获得;
**[Premium 在模型上线的当天即可获得,目前领先 79 个模型](https://freellmapi.co/?utm_source=github&utm_medium=readme#pricing)**($19/年,随时可取消)。
---
## 目录
- [为何存在](#why-this-exists)
- [支持的提供商](#supported-providers)
- [功能](#features)
- [尚不支持](#not-yet-supported)
- [快速开始](#quick-start)
- [与 OB-1 及其他客户端配合使用](#works-with-ob-1-and-other-clients)
- [Docker](#docker)
- [桌面应用](#desktop-app)
- [语言](#languages)
- [Premium(实时目录)](#premium-live-catalog)
- [使用 API](#using-the-api)
- [截图](#screenshots)
- [工作原理](#how-it-works)
- [上下文交接](#context-handoff)
- [限制](#limitations)
- [贡献](#contributing)
- [服务条款审查](#terms-of-service-review)
- [免责声明](#disclaimer)
## 为何存在
如今每家严肃的 AI 实验室都提供免费套餐——每月数百万 token、每天数千次请求。单独看,每个套餐都像是玩具;叠加在一起,它们合计可提供约 **每月 17 亿 token** 的可用推理容量,涵盖 160+ 个模型,从小而快到能力尚可。
问题在于手动叠加很痛苦:二十一套不同的 SDK、二十一套不同的速率限制、二十一个请求可能失败的地方。FreeLLMAPI 将这一切收敛为一个 OpenAI 兼容端点。将任意 OpenAI 客户端库指向你的本地服务器,它会在你已添加密钥的各提供商之间透明路由。
而且免费套餐格局每周都在变化:提供商上线模型、下线模型、悄悄调整配额。FreeLLMAPI 会替你跟踪这一切。路由器会自行从 [freellmapi.co](https://freellmapi.co) 拉取签名的模型目录,因此你的安装无需 `git pull` 也能保持同步。更新速度详见 [Premium(实时目录)](#premium-live-catalog)。
## 支持的提供商
此外还有 **custom**(自定义)提供商——在 Keys 页面可将聊天、嵌入、图像或音频模型指向任意 OpenAI 兼容端点(llama.cpp、LM Studio、vLLM、本地 Ollama 或远程网关)。
另有六项集成——**Agnes AI、Reka、SiliconFlow、Routeway、BazaarLink 和 AINative**——通过 [live catalog](#premium-live-catalog) 提供模型:Premium 路由器在模型上线的当天即可使用,免费安装则通过标准的 30 天门槛获得。
完整且始终最新的列表见 **[freellmapi.co/models](https://freellmapi.co/models.html)**,包含每个模型的速率限制、上下文窗口和免费 token 预算。
## 功能
- **OpenAI 兼容** — `POST /v1/chat/completions` 和 `GET /v1/models` 可与官方 OpenAI SDK 及任意 OpenAI 兼容客户端(LangChain、LlamaIndex、Continue、Hermes 等)配合使用。只需修改 `base_url`。
- **Responses API** — `POST /v1/responses`(当前 Codex CLI 版本所需的线路格式)作为同一路由器之上的翻译垫片实现,支持完整流式事件和工具调用。
- **编辑器自动补全** — `POST /v1/completions` 将旧版 prompt/suffix 请求转换为同一路由器,因此 VS Code 幽灵文本客户端(如 Continue)可使用 FreeLLMAPI 进行行内建议。
- **Anthropic Messages API** — `POST /v1/messages`(以及 `/v1/messages/count_tokens`)在同一路由器上以 Anthropic 线路格式通信,因此 **Claude Code** 和官方 Anthropic SDK 可针对你的免费资源池运行。`GET /v1/models` 通过内容协商(客户端发送 `anthropic-version` 时为 Anthropic 形态,否则为 OpenAI 形态),Claude 系列(`opus` / `sonnet` / `haiku` / `default`)映射到 `auto` 或在 Keys 页面固定的模型。详见 [Anthropic / Claude clients](#anthropic--claude-clients)。
- **Fusion(多模型综合)** — 请求虚拟 `fusion` 模型时,路由器会将你的提示并行分发给一组多样化的免费模型,再由评判模型从草稿中综合出一个答案。面板、评判模型和策略可在仪表板的 **Fusion** 页面配置,或通过 `fusion` 字段按请求配置;每个子调用都走正常的路由、配额和分析流程。
- **图像生成与文字转语音** — `POST /v1/images/generations` 和 `POST /v1/audio/speech` 在提供媒体模型的提供商之间路由,包括自定义 OpenAI 兼容媒体端点。可在仪表板的 **Models → Image / Audio** 标签页浏览并启用。
- **自更新模型目录** — 路由器每天两次从 freellmapi.co 同步签名目录:新模型、配额变更和提供商怪癖修复会自动进入你的安装。详见 [Premium(实时目录)](#premium-live-catalog)。
- **流式与非流式** — `stream: true` 使用 Server-Sent Events,否则返回 JSON 响应。每个提供商适配器均实现两者。
- **工具调用** — OpenAI 风格的 `tools` / `tool_choice` 请求会透传,assistant `tool_calls` + `tool` 角色后续消息在各提供商之间往返。将工具调用以纯文本而非结构化 JSON 输出的模型会自动修复为真正的 `tool_calls`,且工具请求仅路由到实际支持它们的模型。
- **结构化输出与完整采样透传** — `response_format`(`json_object` / `json_schema`,翻译为 Gemini 原生 `responseSchema`),以及 `seed`、`top_k`、`min_p`、presence/frequency/repetition penalties、`logit_bias`、`logprobs` 和 `max_completion_tokens` 别名。已知会被某提供商拒绝的参数会按平台丢弃(Mistral 的严格 API、Groq 的 logprobs 系列……),每个模型在 `/v1/models` `supported_parameters` 中公布其真实支持列表。
- **Embeddings(嵌入)** — `/v1/embeddings` 支持基于模型族的 routing,包括自定义 OpenAI 兼容嵌入端点:故障转移仅在提供*同一*模型的提供商之间发生(不同模型的向量不兼容),绝不会跨模型转移。详见 [Embeddings](#embeddings)。
- **自动故障转移** — 若所选提供商返回 429、5xx 或超时,路由器会跳过它,将密钥置于短暂冷却期,并在你的故障转移链中重试下一个模型(最多 20 次尝试,受墙钟重试预算限制)。失效密钥会轮换到其兄弟密钥,而不是让整个请求失败;耗尽错误会携带完整尝试轨迹,便于你确切看到尝试过什么。
- **智能路由,六种策略** — 链按可选策略排序:`priority`(你的手动顺序)、`balanced`、`smartest`、`fastest`、`reliable`,或 `custom` 配合你自己的权重组合。分数来自实时逐模型测量(速度、能力、速率限制余量、近期错误),底层采用 Thompson-sampling bandit;一键排序预设可从仪表板重排链。
- **统一模型** — 由多家提供商提供的同一逻辑模型(例如 Cloudflare 和 Z.ai 上的 GLM-4.7)合并为一条目:`/v1/models` 中一个名称、组内严格故障转移,以及分组猜测错误时的合并/拆分覆盖。
- **模型配置** — 保存命名的故障转移链配置(编码链、长上下文链、视觉链),并从仪表板切换当前激活项。
- **按密钥速率跟踪** — 每个 `(platform, model, key)` 的 RPM、RPD、TPM 和 TPD 计数器,使路由器始终选择未超限的密钥。账本还会学习:提供商在错误正文或配额头中报告的上限(例如 Groq 413 指明其 TPM 限制)会自动收紧路由器自身的限制。
- **粘性会话** — 多轮对话在 30 分钟内持续使用同一模型,以避免对话中途切换模型带来的幻觉激增。
- **响应缓存(可选)** — 对相同非流式请求的精确匹配内存 LRU:对完整请求做规范化 SHA-256 键、TTL 与 temperature 门控、按请求 `X-FreeLLM-Cache: on|off` 覆盖,以及仪表板上的节省 token 统计。默认关闭;缓存命中不消耗任何提供商配额。
- **加密密钥存储** — API 密钥在写入 SQLite 前以 AES-256-GCM 加密;解密仅在请求前于内存中进行。
- **密钥导入与导出** — 通过粘贴 `.env` 文件批量导入密钥(含预览和逐密钥选择),可导出为 JSON、`.env` 或 CSV。
- **统一 API 密钥** — 客户端使用单一 `freellmapi-…` bearer token 向你的代理认证。你永远不会向上游应用暴露提供商密钥。
- **仪表板登录** — 管理 UI 及所有 `/api/*` 路由由邮箱 + 密码账户保护(scrypt 哈希、session-token 认证),首次运行时设置。`/v1` 代理为应用保留自己的统一密钥认证。
- **健康检查** — 定期探测将密钥标记为 `healthy`、`rate_limited`、`invalid` 或 `error`,路由器会自动跳过失效项。
- **管理仪表板** — React + Vite UI,用于管理密钥、重排故障转移链、查看分析并在 playground 中运行提示。包含深色模式。
- **分析** — 按请求记录延迟(p50 / p95 及流式的首 token 时间)、token 计数、成功率、预估节省成本,以及 24 小时至 90 天窗口内按提供商 / 按模型 / 按密钥的细分。
- **交互式 API 文档** — `GET /v1/docs` 提供无依赖的 OpenAPI 查看器,覆盖每个代理端点;规范本身位于 `GET /v1/openapi.json`。
- **MCP 服务器** — `POST /mcp` 使用 Model Context Protocol(Streamable HTTP),因此支持 MCP 的代理可询问路由器当前哪些免费模型可用(含每个模型的 `supported_parameters`)、检查提供商/密钥健康与冷却、读取用量与缓存统计,并在会话中途切换路由策略。详见 [Coding agents](#coding-agents)。
- **加密数据库备份** — 可选的 SQLite 数据库定期加密快照到本地路径或 HTTP 目标,全新启动时自动恢复(`FREEAPI_DB_BACKUP_*` 环境变量)。
- **模型切换时的上下文交接** — 可选。当会话故障转移到不同模型时,注入一条紧凑的系统消息,让新模型知道它正在继续现有任务。默认关闭;使用 `FREELLMAPI_CONTEXT_HANDOFF=on_model_switch` 启用。详见 [Context Handoff](#context-handoff)。
- **可在任何运行 Node 20+ 的环境运行** — Windows、macOS、Linux 服务器或小型 ARM SBC(包括 Raspberry Pi)。在 PM2 / systemd / 你偏好的任意进程管理器下空闲时约 40 MB RSS。
## 尚未支持
功能范围有意保持精简。若某功能既不在此列表中,也不在下文提及,请默认尚未实现。
- **内容审核**(Moderation,`/v1/moderations`)
- **`n > 1`**(单次请求多次补全,multiple completions per request)
- **按用户计费 / 多租户认证** — 设计上为单用户
欢迎提交 PR 实现上述任一功能。详见 [贡献指南](#contributing)。
## 快速开始
**一行命令**(需要 Docker — 会配置 `~/freellmapi`、生成加密密钥、拉取镜像并启动容器):
```bash
curl -fsSL https://freellmapi.co/install.sh | bash
```
想在 pipe 到 bash 之前先读一遍?[脚本在此](https://freellmapi.co/install.sh). 重复运行是安全的:你的 `.env`(及加密密钥)会被保留,容器会更新到 `:latest`。可用 `FREELLMAPI_DIR`、`PORT` 或 `HOST_BIND` 环境变量覆盖默认值。
在 Windows 上,最省事的方式是使用桌面端 **[Releases 中的 `.exe` 安装包](https://github.com/tashfeenahmed/freellmapi/releases/latest)**(见下文);Docker 步骤可在 WSL 或任意 bash shell 中执行。
**或使用 Docker Compose 手动部署。** 它会在 3001 端口同时运行 API 和仪表盘,并将 SQLite 数据持久化到命名卷中。
**前置条件:** Docker、Docker Compose、OpenSSL。
*在 macOS / Linux(Bash)上:*
```bash
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi
# Generate an encryption key for at-rest key storage
ENCRYPTION_KEY="$(openssl rand -hex 32)"
printf "ENCRYPTION_KEY=%s\nPORT=3001\n" "$ENCRYPTION_KEY" > .env
docker compose up -d
```
*在 Windows(PowerShell)上:*
```powershell
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi
$Bytes = New-Object Byte[] 32
[Security.Cryptography.RandomNumberGenerator]::Create().GetBytes($Bytes)
$ENCRYPTION_KEY = -join ($Bytes | ForEach-Object { "{0:x2}" -f $_ })
"ENCRYPTION_KEY=$ENCRYPTION_KEY`nPORT=3001" | Out-File -Encoding utf8 .env
docker compose up -d
```
打开 http://localhost:3001,,在 **Keys** 页面添加你的 provider 密钥,按需调整 **Fallback Chain** 顺序,并从 **Keys** 页面顶部获取统一 API 密钥。将该统一密钥配置给你的 OpenAI SDK 即可。
全新安装自带免费目录快照(目前 82 个模型),并会从此自动保持更新。实时 feed 额外添加的内容均列于 [freellmapi.co/models](https://freellmapi.co/models.html).
> **从另一台机器访问?** 默认情况下容器仅发布在 `127.0.0.1` 上,因此 `http://:3001` 无法从其他设备加载(页面会一直挂起)。若要在局域网暴露服务 — 例如在 `http://192.168.1.x:3001` 的 Raspberry Pi 上 — 请使用 `HOST_BIND=0.0.0.0` 启动:
>
> ```bash
> HOST_BIND=0.0.0.0 docker compose up -d
> ```
>
> 仅在可信网络上这样做:该代理为单用户模式,仅靠统一 API 密钥保护。
### 本地开发
**前置条件:** Node.js 20+、npm。
*在 macOS / Linux(Bash)上:*
```bash
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi
npm install
ENCRYPTION_KEY="$(node -e 'console.log(require("crypto").randomBytes(32).toString("hex"))')"
printf "ENCRYPTION_KEY=%s\nPORT=3001\n" "$ENCRYPTION_KEY" > .env
npm run dev
```
*在 Windows(PowerShell)上:*
```powershell
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi
npm install
$ENCRYPTION_KEY = node -e "console.log(require('crypto').randomBytes(32).toString('hex'))"
"ENCRYPTION_KEY=$ENCRYPTION_KEY`nPORT=3001" | Out-File -Encoding utf8 .env
npm run dev
```
启动需要 `ENCRYPTION_KEY`。当 `NODE_ENV` 不是 `production` 且未设置时,服务器会自动生成开发密钥并保存到 SQLite 数据库旁的 `.encryption-key` 文件(权限 0600),而非存入数据库。旧版将密钥保存在数据库中的安装会在首次启动时迁移到该文件。使用真实 provider 密钥时不要依赖此回退;请设置 `ENCRYPTION_KEY`。
请求分析数据默认保留 90 天或 100000 条请求记录,以先触达的限制为准进行清理。在 `.env` 中设置 `REQUEST_ANALYTICS_RETENTION_DAYS=0` 或 `REQUEST_ANALYTICS_MAX_ROWS=0` 可禁用相应保留限制。
打开 http://localhost:5173(Vite 开发 UI),在 **Keys** 页面添加你的 provider 密钥,按需调整 **Fallback Chain** 顺序,并从 **Keys** 页面顶部获取统一 API 密钥。将该统一密钥配置给你的 OpenAI SDK 即可。
### 声明式启动配置
对于可重复的 Docker/服务器安装,FreeLLMAPI 可在每次启动时应用 JSON 配置。设置 `FREEAPI_CONFIG_PATH=/path/to/freellmapi.config.json`,或将相同 JSON 放入 `FREEAPI_CONFIG_JSON`。该配置具有幂等性:现有密钥、自定义 provider、模型编辑、fallback 行和路由设置会被更新而非重复创建。
```json
{
"keys": [
{ "platform": "groq", "key": "gsk_...", "label": "main" },
{ "platform": "google", "key": "AIza...", "enabled": true }
],
"customProviders": [
{
"baseUrl": "http://host.docker.internal:11434/v1",
"label": "Ollama",
"models": [
{ "model": "llama3.1:8b", "displayName": "Local Llama", "supportsTools": true }
]
}
],
"models": [
{
"platform": "groq",
"modelId": "llama-3.3-70b-versatile",
"displayName": "Llama 3.3 70B",
"supportsTools": true,
"fallbackEnabled": true
}
],
"routing": { "strategy": "balanced" }
}
```
> **从局域网另一台设备访问开发 UI?** 使用 `npm run dev:lan` — 它会将 `--host` 传递给 Vite,Vite 随后会打印一个 `Network: http://:5173` URL,可在手机或其他机器上打开。(此处 plain `npm run dev -- --host` *不*适用:根目录 `dev` 脚本是 `concurrently` 包装器,标志无法传递到 Vite。)API 调用经 Vite 开发代理转发,无需额外服务器配置。
若不使用 Docker 进行生产构建:
```bash
npm run build
node server/dist/index.js # server + dashboard both served on :3001
```
## Docker
FreeLLMAPI 发布单一生产镜像,内含 Express 服务器和已构建的 React 仪表盘:
```bash
docker pull ghcr.io/tashfeenahmed/freellmapi:latest # or pin a release, e.g. :v1.2.3
```
镜像为多架构(`linux/amd64` + `linux/arm64`,因此可在 Raspberry Pi 上运行)。已发布标签:`latest`(默认分支)、`v*.*.*`(git 发布标签)和 `sha-`。
推荐的安装方式是使用附带的 `docker-compose.yml`:
```bash
docker compose up -d
docker compose logs -f freellmapi
```
默认情况下容器端口绑定到 `127.0.0.1`(仅 localhost)。若要从网络上另一台机器访问仪表盘/API,请使用 `HOST_BIND=0.0.0.0 docker compose up -d` 在所有接口上发布 — 仅限可信局域网,因为该代理为单用户模式。
SQLite 数据存储在 `freellmapi-data` 卷中的 `/app/server/data`。升级时请保留相同的 `.env` `ENCRYPTION_KEY` 和卷,因为 provider 密钥在静态存储时会被加密。若主机仅持久化特定目录,请设置 `FREEAPI_DB_PATH=/that/path/freellmapi.db`。
在具有临时磁盘的主机上,请配置加密备份目标:
```env
FREEAPI_DB_BACKUP_PATH=/app/server/data/freellmapi.db.backup
# or:
FREEAPI_DB_BACKUP_URL=https://example.com/freellmapi.db.backup
FREEAPI_DB_BACKUP_TOKEN=optional-bearer-token
FREEAPI_DB_BACKUP_KEY=64-char-hex-backup-key
FREEAPI_DB_BACKUP_INTERVAL_MS=300000
```
启动时若数据库文件缺失,FreeLLMAPI 会在迁移运行前恢复备份。服务器运行期间会定期上传新的加密备份。若省略 `FREEAPI_DB_BACKUP_KEY`,应用也会使用 `ENCRYPTION_KEY` 作为备份信封。
更多 Docker 操作与示例见 [docker/README.md](./docker/README.md)。
## 桌面应用
原生菜单栏应用位于 [`desktop/`](./desktop):整个 router + dashboard 从系统托盘本地运行,带有展示实时请求统计的毛玻璃弹出窗口。
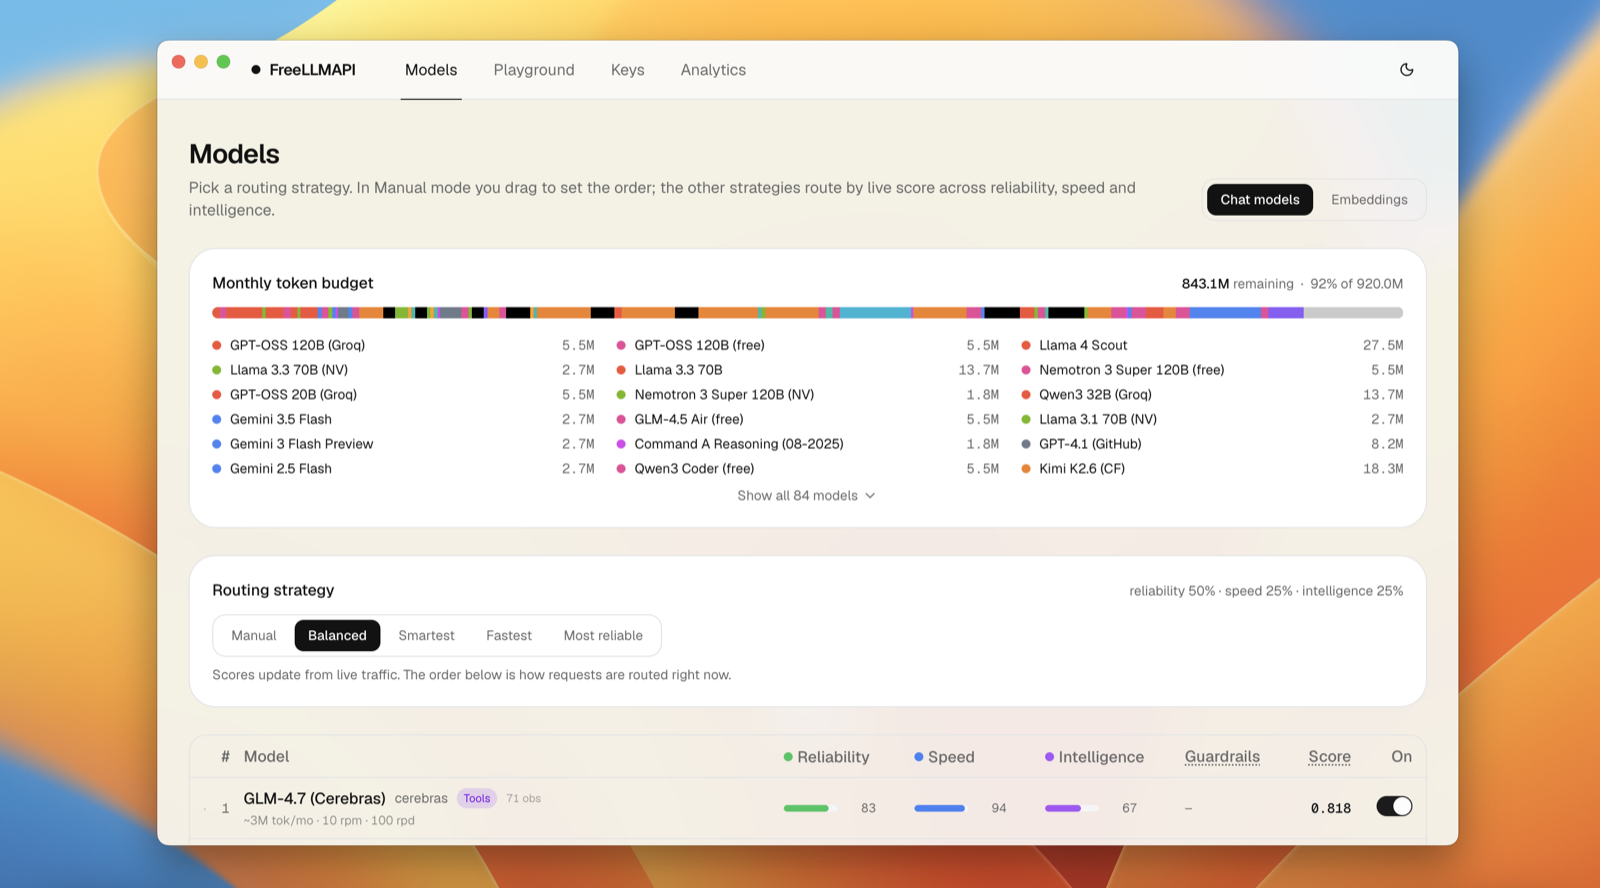
**[从 Releases 下载](https://github.com/tashfeenahmed/freellmapi/releases/latest)** — macOS 版 `.dmg` 与 Windows 版 `.exe` 安装包由 [`desktop-release`](.github/workflows/desktop-release.yml) 工作流构建并随每次发布附上。也可在本仓库几分钟内自行构建:
> **从源码构建的 Windows 用户请注意:** 构建桌面应用需要为 Electron 编译原生 SQLite 模块。在运行 `npm install` 之前,你必须已安装 [Visual Studio Build Tools](https://visualstudio.microsoft.com/visual-cpp-build-tools/)(具体为「使用 C++ 的桌面开发」工作负载)和 Python。
```bash
npm install
npm install --prefix desktop # install desktop dependencies
npm run desktop:dist # macOS → desktop/dist-electron/FreeLLMAPI-…-arm64.dmg
npm run desktop:dist:win # Windows → "desktop/dist-electron/FreeLLMAPI Setup ….exe"
```
> 本地构建的应用未经签名,因此 Windows SmartScreen 可能在首次运行时发出警告
> (「更多信息」→「仍要运行」);macOS 构建版启动时不会触发 Gatekeeper 提示。
> 完整说明请参阅 [desktop/README.md](./desktop/README.md)。
### 凭据与数据存放位置
桌面应用**无需设置用户名或密码**。与服务端不同
(其仪表板需通过邮箱 + 密码账户访问),桌面版
会使用隐藏的本地账户自动登录仪表板,因此
你永远不会被要求输入凭据,也无需准备任何凭据。
你唯一需要的凭据是**统一 API 密钥**——即
你的 OpenAI/Anthropic 客户端所指向的 `freellmapi-…` 令牌。可通过以下方式获取:
- 托盘弹出菜单——点击托盘图标,然后选择 **Copy Key**,或
- 仪表板 **Keys** 页面页眉(托盘 → **Open Dashboard**)。
你无需手动打开或编辑 `freeapi.db`。
你的设置和数据按操作系统存放在各自的文件夹中(复制该文件夹即可迁移到
另一台机器或容器中):
| OS | 位置 |
|----|----------|
| Windows | `%APPDATA%\FreeLLMAPI\`(例如 `C:\Users\\AppData\Roaming\FreeLLMAPI\`) |
| macOS | `~/Library/Application Support/FreeLLMAPI/` |
| Linux | `~/.config/FreeLLMAPI/` |
该文件夹包含 `freeapi.db`(所有密钥、模型、设置,静态加密存储)
以及 `config.json`(窗口/主题/端口/LAN 偏好设置)。迁移安装时请一并复制两者。对于服务端(非桌面版)部署,等效状态位于
`.env` 文件及 `server/data/freeapi.db` 处的 SQLite 数据库(或
`FREEAPI_DB_PATH` 所指向的位置)。
## 语言
仪表板与桌面托盘内置 6 种语言。UI 在首次加载时会自动检测你的
浏览器/系统语言,你可随时通过 **⋯**
菜单切换;所选语言会被记住。
| 语言 | 区域设置 |
| --- | --- |
| English | `en` |
| 中文 (简体) | `zh-CN` |
| Français | `fr` |
| Español | `es` |
| Português (Brasil) | `pt-BR` |
| Italiano | `it` |
翻译文件位于 [`client/src/i18n/locales/`](./client/src/i18n/locales),以
扁平 JSON 文件形式存放。要添加新语言,请复制 `en.json`,翻译其中的值,并在
`client/src/i18n/I18nProvider.tsx`(以及
托盘字符串对应的 `desktop/src/i18n.ts`)中注册该区域设置 — 欢迎提交 PR。
## 与 OB-1 及其他客户端配合使用
FreeLLMAPI 是 **[OB-1](https://github.com/Overbrilliant/ob-1)**: 的免费层级;
OB-1 CLI 可以自动克隆、配置、启动、健康检查并将此代理接入
其设置。新 OB-1 用户可选择 **Start free**,在创建任何托管账户之前
即可使用可用的 OpenAI 兼容端点。
它也可单独使用。任何能将目标指向 OpenAI 兼容
基础 URL 的客户端均可使用 FreeLLMAPI:
- **OB-1**:由 CLI 自动管理,包括匿名提供商。
- **LangChain、LlamaIndex、官方 OpenAI SDK**:将 `base_url` 设置为
`http://localhost:3001/v1`,并使用仪表板中的统一密钥。
- **本地 GPU 主机**:为 Ollama、
llama.cpp、LM Studio、vLLM 或内部网关添加自定义 OpenAI 兼容端点。
### 编程代理(Coding agents)
以下每种配置方案本质相同,只是写在不同的配置文件中:基础 URL
`http://localhost:3001/v1`、来自仪表板 Keys 页面的统一密钥,以及
一个模型(`auto` 可让路由器自动选择)。
| 代理 | 配置 |
| --- | --- |
| **Claude Code** | `ANTHROPIC_BASE_URL=http://localhost:3001` + `ANTHROPIC_AUTH_TOKEN=` — 完整步骤见 [Anthropic / Claude clients](#anthropic--claude-clients) |
| **Codex CLI** | 在 `~/.codex/config.toml` 中添加提供商,将 `base_url = "http://localhost:3001/v1"` 及其 `env_key` 指向统一密钥 — 所需的 `/v1/responses` 接口已实现 |
| **Cline / Roo Code** | 提供商类型为 "OpenAI Compatible",基础 URL `http://localhost:3001/v1`,统一密钥,模型 `auto`(或 `/v1/models` 中的任意 id) |
| **Continue** | 在其配置中使用 `apiBase: http://localhost:3001/v1`;通过旧版 `/v1/completions` 接口也可实现行内自动补全 |
| **Aider** | `OPENAI_API_BASE=http://localhost:3001/v1` + `OPENAI_API_KEY=`,然后 `aider --model openai/auto` |
| **opencode** | 使用相同基础 URL 和密钥的 OpenAI 兼容提供商 |
| **Cursor** | 在自定义 OpenAI 基础 URL 下粘贴统一密钥 — 但请注意,Cursor 会**从其服务器**验证并调用 API,因此你的路由器必须可从互联网访问(通过隧道或具有公网地址的主机),而不仅仅是 `localhost` |
除推理外,该路由器还是一个 **MCP 服务器**:代理可在会话中途对其进行自省
(可用模型及各模型支持的参数、提供商健康状态、用量与缓存统计、
路由策略)。对于 Claude Code:
```bash
claude mcp add --transport http freellmapi http://localhost:3001/mcp \
--header "Authorization: Bearer freellmapi-your-unified-key"
```
任何支持 Streamable HTTP 的 MCP 客户端用法相同:将其指向 `/mcp`,并以
统一密钥作为 Bearer 令牌。
FreeLLMAPI 从设计上即本地优先且面向单用户。你的提供商密钥保存在
SQLite 数据库中,静态加密存储,请求从你的机器发向你已启用的
上游提供商。
## Premium(实时目录)
路由器会自动保持模型目录更新:每天两次从 [freellmapi.co](https://freellmapi.co) 拉取已签名的目录,
并将新模型、配额变更和提供商特殊修复应用到本地数据库。你自己的
启用/禁用选择与自定义提供商永远不会被修改,且每次
下载在应用前都会使用固定的 Ed25519 密钥进行验证。
目录分为两个订阅源:
| | Free | Premium |
|---|---|---|
| 价格 | $0,永久免费 | **$19/年** 或 **$49 终身** |
| 当前提供的模型(2026 年 7 月) | 82 | **161** |
| 新增免费模型 | 每个模型发布后 30 天 | **发布当天** |
| 配额变更与特殊修复 | 同样延迟 30 天 | 2-3 天内 |
| 激活 | 无需操作 | 一个密钥,覆盖所有设备 |
差距并非假设。目前实时订阅源比
免费安装版**领先 79 个模型**,包括 Kimi K2.7 Code、GLM-5.2、MiniMax M3、Qwen3.5 397B,以及
支持 100 万 token 上下文窗口的 Nemotron 3 Ultra 550B。其中每个模型在发布后约一个月才会进入免费
安装版;而 Premium 路由器在发布当天就已提供
这些模型。可在
**[freellmapi.co/models](https://freellmapi.co/models.html)**. 精确查看你所缺失的内容。
在这个市场里,三十天已是漫长时间。当提供商推出强劲的
新免费模型、悄然收紧配额或破坏某种 wire format 时,实时订阅
路由器会在数天内完成修补,而免费安装版只能等待模型「到期」
后才能获得更新。如果你每天都使用路由器,Premium 的差别就在于你是亲身赶上
免费层浪潮,还是事后才读到相关消息。
**[Go live at freellmapi.co →](https://freellmapi.co/?utm_source=github&utm_medium=readme#pricing)**
- $19/年或一次性 $49,终身有效。Stripe 结账;可随时取消,自助管理。
- 一个 `fla_` 密钥覆盖你运行的所有路由器:桌面版、家庭实验室、树莓派。
- 在仪表板的 **Premium** 下激活;可在 [freellmapi.co/manage](https://freellmapi.co/manage). 自助取消或管理账单。
- 路由器本身始终保持 MIT 许可且完全免费,永久如此。Premium 仅
提供实时订阅源,正是它资助了每日模型测试与目录
维护工作,使两个层级都能正常运转。
目录服务器永远不会看到你的提示词、补全内容或提供商密钥 — 无论哪种方式,
路由器都保持完全自托管。
## 使用 API
任何兼容 OpenAI 的客户端均可使用(Anthropic / Claude 客户端也可以 — 见 [Anthropic / Claude 客户端](#anthropic--claude-clients))。示例:
**Python**
```python
from openai import OpenAI
client = OpenAI(
base_url="http://localhost:3001/v1",
api_key="freellmapi-your-unified-key",
)
resp = client.chat.completions.create(
model="auto", # let the router pick; or specify e.g. "gemini-2.5-flash"
messages=[{"role": "user", "content": "Summarise the fall of Rome in one sentence."}],
)
print(resp.choices[0].message.content)
print("Routed via:", resp.headers.get("x-routed-via"))
```
**curl**
```bash
curl http://localhost:3001/v1/chat/completions \
-H "Authorization: Bearer freellmapi-your-unified-key" \
-H "Content-Type: application/json" \
-d '{
"model": "auto",
"messages": [{"role": "user", "content": "hi"}]
}'
```
**流式传输(Streaming)**
```python
stream = client.chat.completions.create(
model="auto",
messages=[{"role": "user", "content": "Stream me a haiku about SQLite."}],
stream=True,
)
for chunk in stream:
print(chunk.choices[0].delta.content or "", end="", flush=True)
```
**VS Code 幽灵文本自动补全(Continue)**
FreeLLMAPI 为发送旧版 OpenAI prompt/suffix 请求的编辑器自动补全客户端暴露 `/v1/completions`。Continue 配置示例:
```yaml
models:
- name: FreeLLMAPI Autocomplete
provider: openai
model: auto
apiBase: http://localhost:3001/v1
apiKey: freellmapi-your-unified-key
useLegacyCompletionsEndpoint: true
roles:
- autocomplete
```
**工具调用(Tool calling)**
传入 OpenAI 风格的 `tools` 和 `tool_choice`;助手响应会通过代理原样往返,与 OpenAI API 完全一致。多步流程(助手 `tool_calls` → `tool` 角色后续跟进 → 最终答案)在路由器能访问的每个提供商上均可工作。
```python
tools = [{
"type": "function",
"function": {
"name": "get_weather",
"description": "Get current weather for a city.",
"parameters": {
"type": "object",
"properties": {"city": {"type": "string"}},
"required": ["city"],
},
},
}]
# 1. Model asks for a tool call
first = client.chat.completions.create(
model="auto",
messages=[{"role": "user", "content": "What's the weather in Karachi?"}],
tools=tools,
tool_choice="required",
)
call = first.choices[0].message.tool_calls[0]
# 2. You execute the tool, feed the result back
final = client.chat.completions.create(
model="auto",
messages=[
{"role": "user", "content": "What's the weather in Karachi?"},
first.choices[0].message,
{"role": "tool", "tool_call_id": call.id, "content": '{"temp_c": 32, "cond": "sunny"}'},
],
tools=tools,
)
print(final.choices[0].message.content)
```
**Gemini Google Search 接地(grounding)**
Google 的模型可以将回答建立在实时 Google 搜索结果之上。由于 OpenAI 线路格式无法表达该能力,请请求名为 `google_search` 的工具,Google 提供商会将其转换为 Gemini 的原生接地工具。它可以单独发送,也可以与常规函数工具一并发送。
```python
resp = client.chat.completions.create(
model="gemini-2.5-flash", # pin a Google model so the request routes there
messages=[{"role": "user", "content": "Who won the F1 race this weekend?"}],
tools=[{"type": "function", "function": {"name": "google_search", "parameters": {}}}],
)
print(resp.choices[0].message.content)
```
**视觉 / 图像输入(Vision / image input)**
使用标准 OpenAI `image_url` 内容块发送图像(base64 `data:` URL 或 `http(s)` URL)。当请求包含图像时,路由器会限制为仅使用**支持视觉的模型**,并忽略纯文本模型。支持视觉的模型在 Fallback Chain 页面上标有 **Vision** 徽章;当前集合包括 Gemini(2.5 / 3.x)、Llama 4 Scout/Maverick(Groq、NVIDIA)、GLM-4.6V Flash(Z.ai)、Nemotron Nano 12B VL(OpenRouter)以及 GitHub 的 GPT-4o / GPT-4.1。
```python
resp = client.chat.completions.create(
model="auto", # auto-routes to a vision model
messages=[{
"role": "user",
"content": [
{"type": "text", "text": "What's in this image?"},
{"type": "image_url", "image_url": {"url": "data:image/png;base64,<...>"}},
],
}],
)
print(resp.choices[0].message.content)
```
若在 Fallback Chain 中未启用任何支持视觉的模型,图像请求会返回明确的 `422`(`code: "no_vision_model"`),而不是静默丢弃图像。(`/v1/responses` 尚不支持图像输入 — 请使用 `/v1/chat/completions`。)
同样适用于 `stream=True` — 你会先收到 `delta.tool_calls` 块,随后是 `finish_reason: "tool_calls"` 结束。底层实现上,兼容 OpenAI 的提供商(Groq、Cerebras、Mistral、OpenRouter、GitHub Models、HuggingFace、Cloudflare、Cohere compat)会原样透传请求;Gemini 请求会被转换为 Google 的 `functionDeclarations` / `functionResponse` 形态,响应再转换回来。
每个响应都带有 `X-Routed-Via: /` 标头,便于查看实际为每次调用提供服务的提供商。若请求在提供商之间发生故障转移,你还会看到 `X-Fallback-Attempts: N`。
### 嵌入(Embeddings)
`/v1/embeddings` 兼容 OpenAI,与聊天路由有一处刻意差异:**故障转移绝不会跨模型切换。** 不同模型的向量处于不兼容的空间 — 静默切换模型会破坏基于该代理构建的任何向量存储。因此嵌入按**族(family)**(一个模型身份 + 维度)路由,故障转移仅在提供同一族的提供商之间进行。
```python
resp = client.embeddings.create(
model="auto", # default family; or a family name like "bge-m3"
input=["the quick brown fox", "pack my box with five dozen liquor jugs"],
)
print(len(resp.data), "vectors of", len(resp.data[0].embedding), "dims")
```
```bash
curl http://localhost:3001/v1/embeddings \
-H "Authorization: Bearer freellmapi-your-unified-key" \
-H "Content-Type: application/json" \
-d '{"model": "auto", "input": "hello world"}'
```
`model` 接受 `auto`(配置的默认族)、族名称或提供商特定的模型 id(会解析到其所属族)。可用族:
| 族(`model`) | 维度(Dims) | 提供商(故障转移顺序) |
| --- | --- | --- |
| `gemini-embedding-001` *(默认)* | 3072 | Google |
| `text-embedding-3-large` | 3072 | GitHub Models |
| `text-embedding-3-small` | 1536 | GitHub Models |
| `embed-v4.0` | 1536 | Cohere |
| `bge-m3` | 1024 | Cloudflare → Hugging Face |
| `qwen3-embedding-0.6b` | 1024 | Cloudflare |
| `nv-embedqa-e5-v5` | 1024 | NVIDIA |
| `llama-nemotron-embed-1b-v2` | 2048 | NVIDIA |
| `llama-nemotron-embed-vl-1b-v2` | 2048 | NVIDIA → OpenRouter |
| `embeddinggemma-300m` | 768 | Cloudflare |
默认族、各提供商开关及优先级位于控制台的 **Models → Embeddings** 页面。为给定向量存储选定一个族后请坚持使用 — 这正是族模型的设计目的。
### Anthropic / Claude 客户端
FreeLLMAPI 也支持 Anthropic 的 Messages API,因此任何为 Claude 构建的工具 — 包括 **Claude Code** 和官方 Anthropic SDK — 均可对接你的免费资源池。将客户端指向你服务器的 **origin**(Anthropic 客户端会自行追加 `/v1/messages`),并使用统一密钥进行认证。`x-api-key` 和 `Authorization: Bearer` 均可接受。
```bash
curl http://localhost:3001/v1/messages \
-H "x-api-key: freellmapi-your-unified-key" \
-H "anthropic-version: 2023-06-01" \
-H "Content-Type: application/json" \
-d '{
"model": "claude-sonnet-4-5",
"max_tokens": 256,
"messages": [{"role": "user", "content": "hi"}]
}'
```
Claude 模型名称在 **Keys → Anthropic** 选项卡上映射到你的免费资源池:每个族(`default`、`opus`、`sonnet`、`haiku`)路由到 `auto`(路由器选取免费模型)或你固定的模型。`POST /v1/messages/count_tokens` 以及内容协商的 `GET /v1/models`(发送 `anthropic-version` 时为 Anthropic 形态)也已实现。流式传输、系统提示、工具使用与图像输入均通过同一路由器转换,与 OpenAI 端点一致。
**Claude Code** — 将其指向你的服务器并启动:
*在 macOS / Linux(Bash)上:*
```bash
export ANTHROPIC_BASE_URL=http://localhost:3001
export ANTHROPIC_AUTH_TOKEN=freellmapi-your-unified-key # NOT ANTHROPIC_API_KEY
claude
```
*在 Windows(PowerShell)上:*
```powershell
$env:ANTHROPIC_BASE_URL="http://localhost:3001"
$env:ANTHROPIC_AUTH_TOKEN="freellmapi-your-unified-key"
claude
```
> 使用 `ANTHROPIC_AUTH_TOKEN`(以 Bearer token 形式发送),**不要**使用 `ANTHROPIC_API_KEY` — Claude Code 会将已设置的 `ANTHROPIC_API_KEY` 视为冲突的第一方凭据并拒绝启动。
## 截图
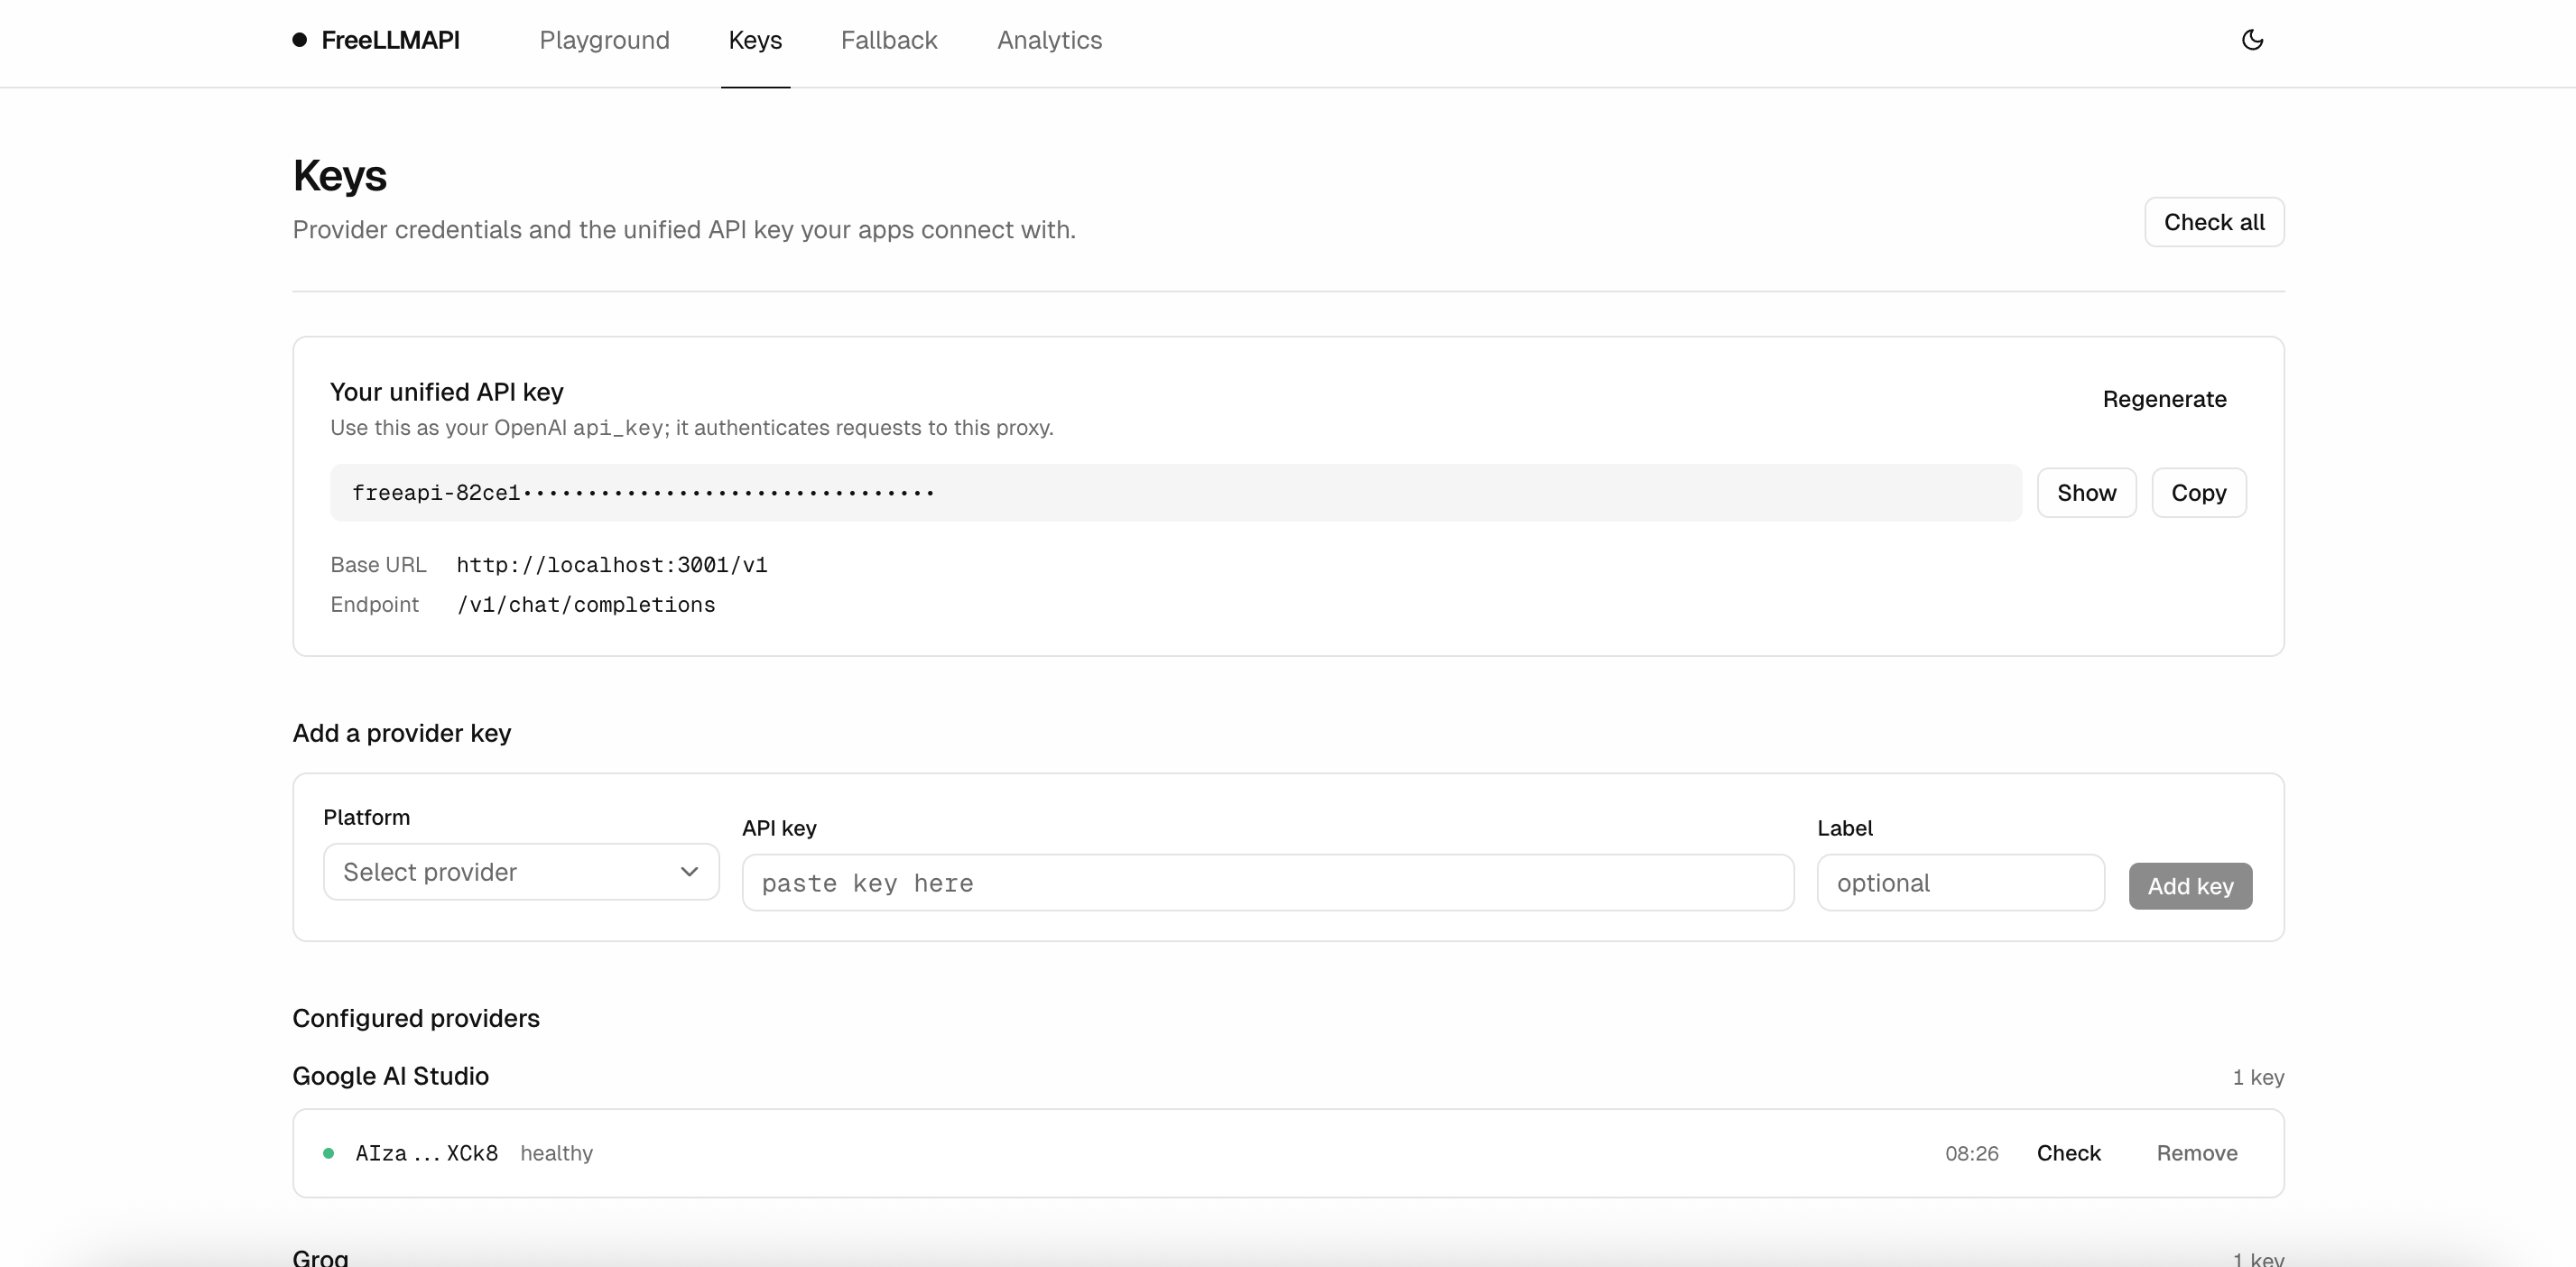
### 密钥
管理提供商凭据,并获取应用连接时使用的统一 API 密钥。每个密钥会显示状态指示点及最近一次健康检查时间。
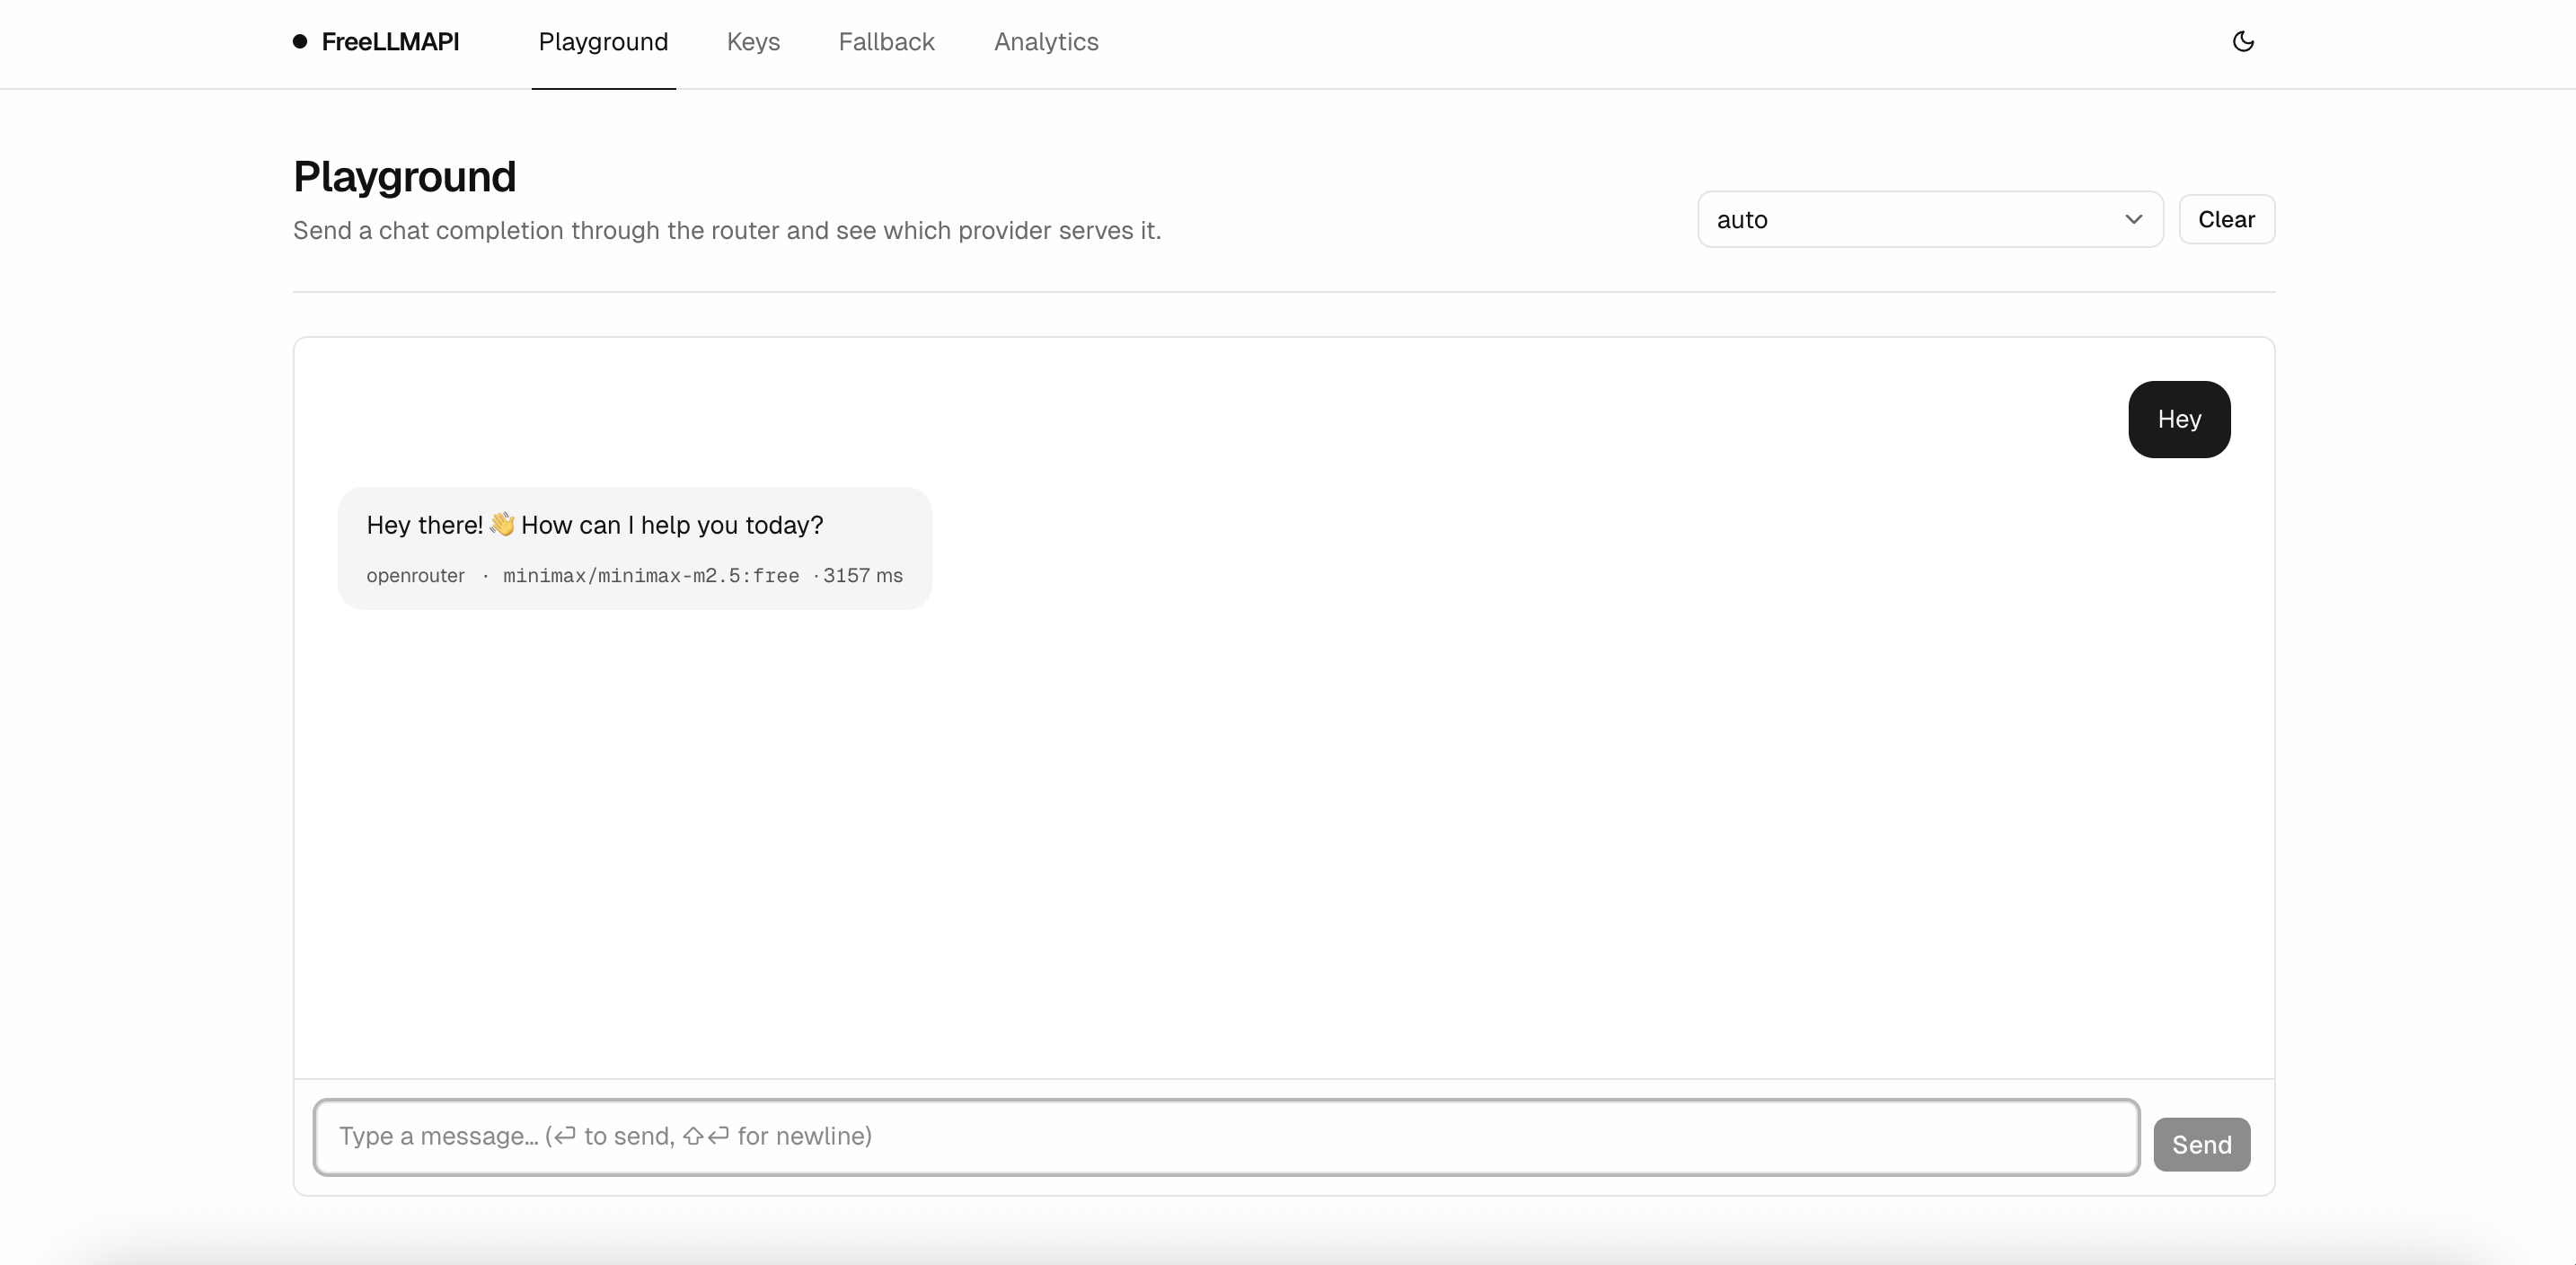
### Playground
通过路由器发送聊天补全请求,查看由哪个提供商提供服务,模型 ID 和延迟会直接显示在消息上。
### 分析
24 小时 / 7 天 / 30 天 / 90 天时间窗口内的请求量、成功率、输入/输出 token 数、平均延迟,以及按提供商的细分数据。

## 工作原理
```
┌──────────────────┐ Bearer freellmapi-… ┌─────────────────────────┐
│ OpenAI SDK / │ ──────────────────────▶ │ Express proxy (:3001) │
│ curl / any │ ◀────────────────────── │ /v1/chat/completions │
│ OpenAI client │ streamed tokens └────────────┬────────────┘
└──────────────────┘ │
▼
┌────────────────────────────────────────────────┐
│ Router │
│ 1. Pick highest-priority model that │
│ (a) has a healthy key and │
│ (b) is under all its rate limits. │
│ 2. Decrypt key, call provider SDK. │
│ 3. On 429/5xx → cooldown + retry next model. │
└────────────────────────────────────────────────┘
│
┌──────────────┬────────────┬──────────┴─────────┬─────────────┬──────────┐
▼ ▼ ▼ ▼ ▼ ▼
Google Groq Cerebras OpenRouter HF …22 more
```
- **Router**(`server/src/services/router.ts`)— 按请求选择模型。
- **Rate-limit ledger**(速率限制账本,`server/src/services/ratelimit.ts`)— 由 SQLite 支撑的内存中 RPM/RPD/TPM/TPD 计数器,遇到 429 时进入冷却期。
- **Provider adapters**(提供商适配器,`server/src/providers/*.ts`)— 每个提供商一个文件,实现 `Provider` 基类:`chatCompletion()` 和 `streamChatCompletion()`。
- **Health service**(健康检查服务,`server/src/services/health.ts`)— 定期探测以保持密钥状态最新。
- **Dashboard**(仪表板,`client/`)— 基于 React + Vite + shadcn/ui 的管理界面。
- **Storage**(存储)— SQLite(`better-sqlite3`),对密钥采用 AES-256-GCM 信封加密。
## 上下文交接(Context Handoff)
当 FreeLLMAPI 在对话中途切换到不同模型(配额、速率限制、冷却期)时,新模型并不知道自己在接手他人的任务。**Context handoff**(上下文交接)会在出站请求中添加一条紧凑的 `system` 消息,准确告知新模型这一情况:
```
FreeLLMAPI context handoff:
You are taking over an ongoing conversation from another model (groq:llama-3 → google:gemini-flash).
Continue the user's task using the conversation context already provided in this request.
Do not restart the task, re-ask already answered setup questions, or discard prior tool results.
Respect the user's latest message as the highest-priority instruction.
Recent session summary:
User: …
Assistant: …
```
**在 `.env` 中启用:**
```env
FREELLMAPI_CONTEXT_HANDOFF=on_model_switch
```
**工作原理:**
- 每个会话的消息存储在内存中(TTL:3 小时)。
- 仅当给定会话键所选模型发生变化时才注入。
- 首次请求、同一模型继续对话,或已存在交接消息时不会注入。
- 会话键:若存在则使用 `X-Session-Id` 请求头,否则使用第一条用户消息的 SHA-1(与会话粘性相同)。
- 存储仅在内存中,不会写入磁盘或记录日志。
> **重要提示:** Context Handoff 可改善通过 FreeLLMAPI 路由的对话连续性。它无法恢复提供商内部的隐藏状态,或从未发送到代理的消息。
## 局限性
叠加免费套餐存在真实的权衡。请诚实地面对它们:
- **没有前沿模型。** 免费套餐目录上限大约在 Llama 3.3 70B、GLM-4.5、Qwen 3 Coder 和 Gemini 2.5 Pro。你无法通过本方案获得 GPT-5 或 Claude Opus 级别的推理能力。对于难题,请购买真正的 API。
- **智能水平会随一天推进而下降。** 你排名靠前的模型(通常是 Gemini 2.5 Pro、通过 GitHub Models 的 GPT-4o)日配额最低。一旦达到上限,路由器会沿优先级链降级到更小/更弱的模型。预计端点的有效智能水平会在每天晚些时候下降——然后在 UTC 午夜重置。
- **延迟波动很大。** Cerebras 和 Groq 极快;其他则不然。你能用到哪个就用哪个。
- **免费套餐可能毫无预警地变更。** 提供商经常收紧、放宽或取消免费套餐。届时你会看到 429 或认证错误,直到目录更新送达——live-feed 安装可在数天内获得修复,免费安装走 30 天滞后通道。重新种子脚本位于 `server/src/scripts/`。
- **按定义没有 SLA。** 若需要可靠性,请使用有合同保障的付费提供商。
- **本地优先(Local-first)。** 没有多租户认证。仅供个人运行;不要将其暴露到公网。
## 贡献
非常欢迎贡献者!请参阅 [CONTRIBUTING.md](CONTRIBUTING.md) 了解开发循环、PR 期望,以及 AI/LLM 辅助贡献的政策(简而言之:欢迎,质量标准与其他 PR 相同)。适合新手的 PR:
- **添加提供商** — 复制 `server/src/providers/openai-compat.ts` 作为模板,接入 `server/src/providers/index.ts`,在 `server/src/db/index.ts` 中种子化其模型,在 `server/src/__tests__/providers/` 中添加测试。
- **添加端点** — moderations 及其他 OpenAI 兼容接口。提供商基类可扩展新方法;适配器声明其支持的接口。
- **改进路由器** — 成本感知路由(最便宜-健康-最快权衡)、更好的延迟加权优先级、区域固定。
- **仪表板优化** — Analytics 页面图表、密钥轮换 UX、从 `.env` 批量导入密钥。
- **文档** — 更多示例、Go/Rust 等客户端库代码片段、Docker 或 Fly 部署方案。
**开发循环:**
```bash
npm install
npm run dev # server on :3001, dashboard on :5173, both with HMR
npm test # server vitest; also runs client tests if the workspace adds them
npm run build # compile server and dashboard
```
PR 应包含测试、保持现有测试套件通过,并符合仓库中已有的 `.editorconfig` / tsconfig 默认配置。完整贡献者工作流请参阅 [CONTRIBUTING.md](./CONTRIBUTING.md)。
### 数据库迁移
在本地开发中,通过以下方式应用待处理的迁移:
```bash
NODE_ENV=development npm run db:migration:up
```
完整迁移 CLI 及工作流请参阅 [CONTRIBUTING.md](./CONTRIBUTING.md)。
### 贡献者


 ## 服务条款(ToS)审查
针对自托管、单用户、个人使用场景,已根据各服务商的服务条款(ToS)于 2026 年 5 月重新审查。摘要如下:
| Provider | Verdict | Notes |
|---|---|---|
| Google Gemini | ⚠️ 谨慎 | 2026 年 3 月 ToS 将适用范围收窄为*"用于专业或商业目的,不得用于消费者用途"*——自托管开发者代理仍可合理解释,但该条款为新增内容。 |
| Groq | ✅ 可能合规 | GroqCloud 服务协议允许客户应用(Customer Application)集成。 |
| Cerebras | ✅ 可能合规 | 允许使用;明确禁止出售/转让 API 密钥。 |
| Mistral | ✅ 可能合规 | API 允许用于个人/内部商业用途。 |
| OpenRouter | ✅ 可能合规 | 2026 年 4 月 ToS 强化了禁止转售/禁止竞争服务的条款;私有单用户代理仍无问题。 |
| Cloudflare Workers AI | ⚠️ 存疑 | 无反代理条款;适用一般自助订阅协议(Self-Serve Subscription Agreement)。 |
| NVIDIA NIM | ⚠️ 谨慎 | 试用 ToS §1.2 / §1.4:*"仅限评估,不得用于生产环境。"* 免费访问为持续的 40 RPM 速率限制(2025 年积分体系已停用),但仅限评估的适用范围仍然有效。 |
| GitHub Models | ⚠️ 谨慎 | 免费层明确限定为*"实验"*与*"原型开发"。* |
| Cohere | ❌ 避免使用 | 条款 §14 仍禁止*"个人、家庭或家庭用途。"* |
| Zhipu (open.bigmodel.cn) | ✅ 可能合规 | 平台文档中仍保留个人/非商业研究豁免条款。 |
| Z.ai (api.z.ai) | ⚠️ 谨慎 | 新增条目——新加坡实体(与智谱中国不同)。§III.3(l) 反流量重定向条款可能被合理解读为针对代理;无明确个人用途豁免。 |
| Ollama Cloud | ✅ 可能合规 | 新增条目——免费方案允许访问云模型(1 个并发、5 小时会话上限)。未发现反代理/反转售条款。*(集成追踪于 #14。)* |
| OVH AI Endpoints | ✅ 可能合规 | 新增条目(2026 年 6 月)——官方文档支持匿名访问(每 IP 每模型 2 次/分钟)。OVH 保留引入 token/用量上限的权利。 |
| AI Horde | ✅ 可能合规 | 新增条目(2026 年 6 月)——由 Haidra 非营利组织运营的免费社区公共平台;官方支持匿名使用(密钥 `0000000000`,队列优先级最低)。无反代理/反转售条款。OpenAI 代理为试点,可能受用量限制。*(集成 #345。)* |
让大多数服务商满意的经验法则:**每个服务商仅使用一个账号**、**不转售**、**不与他人共享你的端点**、**不要将免费层当作付费生产后端猛刷**。本内容仅供参考,不构成法律建议——请阅读各服务商的 ToS 并自行判断。
自 2026 年 4 月审查起已移除:Hugging Face、Moonshot 和 MiniMax 直连集成已从目录中删除(HF——工具调用格式问题;Moonshot——已转为仅付费;MiniMax——已被 OpenRouter `minimax/minimax-m2.5:free` 路由取代)。
## 免责声明
**本项目仅供个人实验与学习,不得用于生产环境。** 免费层存在是为了让开发者在其上构建原型;它们并非稳定、受支持的推理基础设施,也不应被当作此类基础设施使用。若你在 FreeLLMAPI 之上构建真实产品,请在上线前替换为付费 API。你与各上游服务商的关系受你在创建账号时所接受条款的约束——流量经本项目代理时这些条款仍然适用,你有责任遵守它们。
## License
[MIT](./LICENSE)