---
title: RocketMQ 常见问题总结
description: RocketMQ 常见面试题与知识点总结,涵盖 RocketMQ 架构(NameServer/Broker/Proxy)、消息类型(普通/顺序/事务/定时消息)、消息存储机制(CommitLog/ConsumeQueue)、高性能原理(零拷贝/顺序写)、消息可靠性保障、RocketMQ 5.x 新特性等内容。
category: 高性能
tag:
- RocketMQ
- 消息队列
head:
- - meta
- name: keywords
content: RocketMQ,消息队列,NameServer,Broker,Proxy,顺序消息,事务消息,定时消息,消息存储,RocketMQ面试,RocketMQ5.x
---
> 本文由 FrancisQ 投稿!相比原文主要进行了下面这些完善:
>
> - [分析了 RocketMQ 高性能读写的原因和顺序消费的具体实现](https://github.com/Snailclimb/JavaGuide/pull/2133)
> - [增加了消息类型、消费者类型、消费者组和生产者组的介绍](https://github.com/Snailclimb/JavaGuide/pull/2134)
> - [RocketMQ 5.x 支持按消息粒度分配](https://github.com/Snailclimb/JavaGuide/issues/2778)
## 消息队列扫盲
RocketMQ 面试一般不会停在“消息队列是什么”。更常见的追问是:NameServer 为什么可以做得很轻,Broker 主从怎么同步,CommitLog 和 ConsumeQueue 各自负责什么,顺序消息、事务消息、定时消息又分别靠什么实现。
如果你还没系统用过 MQ,先把三个场景记住:异步、解耦、削峰。后面讲 RocketMQ 架构、存储和消费模型,基本都绕不开这三个问题。
### 消息队列为什么会出现?
单体应用里,接口之间直接调用最省事;系统拆成多个服务后,调用链一长,同步调用就会把响应时间、故障和流量峰值一起传递下去。消息队列插在中间,先把消息存起来,让下游按自己的节奏消费。
### 消息队列能用来干什么?
#### 异步
你可能会问,应用之间的通信又不是只能由消息队列解决,为什么中间非要插一个消息队列?直接进行通信不行吗?
这就引出了另一个概念——**同步通信**。比如业界使用较多的 Dubbo 就是一个适用于各个系统之间同步通信的 RPC 框架。
以购票系统为例,需求是用户在购买完成之后能接收到购买完成的短信通知。
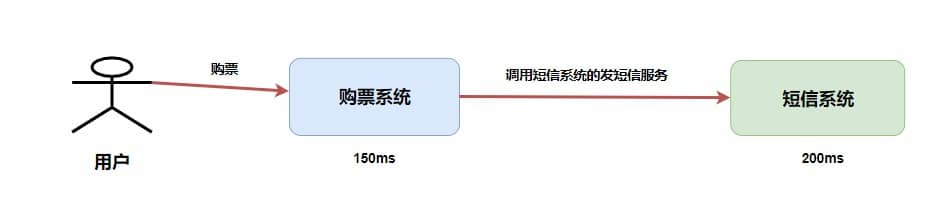
我们省略中间的网络通信时间消耗,假如购票系统处理需要 150ms ,短信系统处理需要 200ms ,那么整个处理流程的时间消耗就是 150ms + 200ms = 350ms。
当然,乍看没什么问题。但仔细分析会发现问题:用户购票在购票系统处理完成时就已经完成了购买动作,而现在通过同步调用非要让整个请求时间变长。短信系统只是一个辅助功能,用于增强用户体验感,并非核心业务。整个调用流程显得 **头重脚轻**——购票是一个不太耗时的流程,但因为同步调用,必须等待发送短信这个较耗时的操作完成才能返回结果。如果再加一个发送邮件的需求呢?

这样整个系统的调用链又变长了,整个时间就变成了 550ms。
当我们在食堂排队打饭时,我们和食堂工作人员之间就是一个同步模型。
我们需要告诉工作人员:“请帮我加个鸡腿,再加个酸辣土豆丝,多打点饭”。
然后工作人员帮我们打饭配菜,我们需要等待这个过程完成。
最终我们从工作人员手中接过饭菜然后去寻找座位。
回想一下,我们在传达需求之后是 **同步等待工作人员配好饭菜** 的。如果增加更多菜品,工作人员打饭配菜的流程就会变长,我们等待的时间也会相应增加。
而在餐厅用餐时,我们告诉服务员来一碗牛肉面加个荷包蛋 **(传达一个消息)** ,然后可以在餐桌上做自己的事情 **(干自己其他事情)** ,等到牛肉面上桌我们再开始用餐。虽然做面的时间没有变短,但是我们只需要传达一个消息就可以干其他事情了,这就是 **异步** 的概念。
所以,为了解决这一个问题,聪明的程序员在中间也加了个类似于服务员的中间件——消息队列。这个时候我们就可以把模型给改造了。

这样,我们在将消息存入消息队列之后我们就可以直接返回了(我们告诉服务员我们要吃什么然后玩手机),所以整个耗时只是 150ms + 10ms = 160ms。
> 但是你需要注意的是,整个流程的时长是没变的,就像你仅仅告诉服务员要吃什么是不会影响到做面的速度的。
#### 解耦
回到最初同步调用的过程,我们写个伪代码简单概括一下。
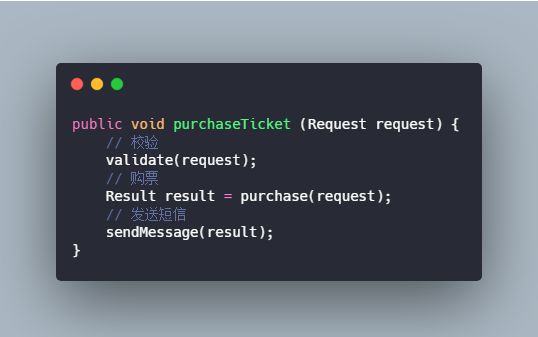
那么第二步,我们又添加了一个发送邮件,我们就得重新去修改代码,如果我们又加一个需求:用户购买完还需要给他加积分,这个时候我们是不是又得改代码?
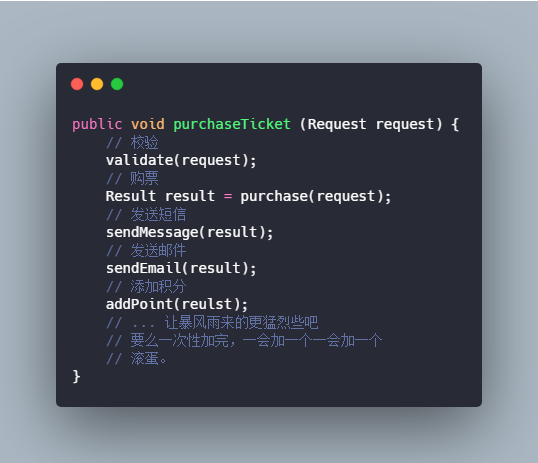
如果还觉得可以接受,那么当需要移除发送邮件服务时,是不是又得改代码、又得重启应用?
这样频繁改动代码显然很麻烦,此时可以 **使用消息队列进行解耦** 。需要注意的是,后面的发送短信、发送邮件、添加积分等操作都依赖于 `result`,即购票的处理结果(如订单号、用户账号等),也就是说后续服务都需要相同的消息来进行处理。因此可以通过 **“广播消息”** 模式来实现。
这里所说的“广播”并不是真正的广播,而是下游系统作为消费者去 **订阅** 特定的主题。比如主题可以命名为 `订票`,购买系统作为生产者将消息发送到消息队列,消费者订阅该主题后,从消息队列中拉取消息并消费。在生产者端只需要关注 **生产消息到指定主题** ,**消费者只需要关注从指定主题中拉取消息** 。
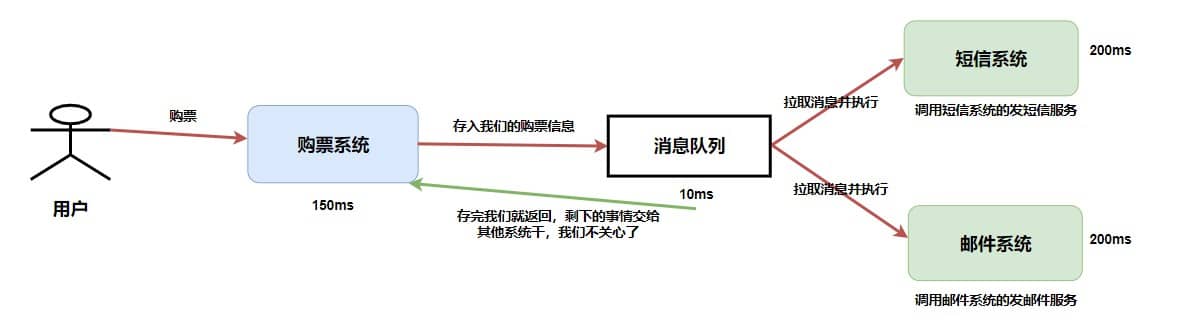
> 如果没有消息队列,每当一个新的业务接入,我们都要在主系统调用新接口、或者当我们取消某些业务,我们也得在主系统删除某些接口调用。有了消息队列,我们只需要关心消息是否送达了队列,至于谁希望订阅,接下来收到消息如何处理,是下游的事情,无疑极大地减少了开发和联调的工作量。
#### 削峰
回到同步调用系统的场景,思考一下:如果此时有大量用户请求购票,整个系统会变成什么样?
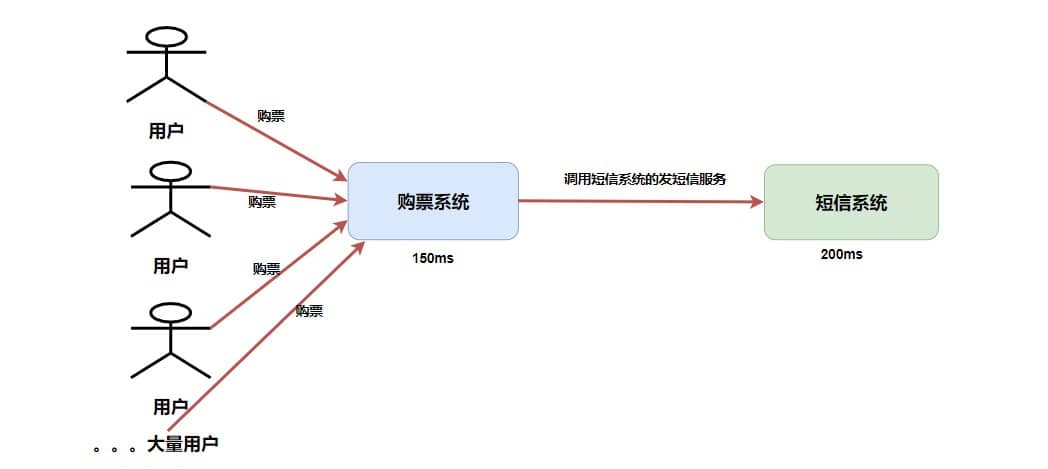
假设有一万个请求进入购票系统,运行主业务的服务器配置通常较好,购票系统可以承受这一万个用户请求。但这意味着同时也会产生一万个调用短信服务的请求。短信系统并非主要业务,配备的硬件资源不会太高。此时短信系统能否承受这一万的峰值?很可能系统会 **直接崩溃** 。
短信业务并非主业务,能否 **折中处理** ?如果我们把购买完成的信息发送到消息队列中,而短信系统 **尽自己所能地去消息队列中取消息和消费消息** ,即使处理速度慢一点也无所谓,只要系统没有崩溃就可以接受。
系统可用性是最重要的,验证码短信的延迟几秒到达用户手机,通常是可以接受的。
### 消息队列能带来什么好处?
总结起来就是三个关键词:**异步、解耦、削峰**。这不仅是消息队列的核心价值,更是分布式架构设计的重要思想。
```mermaid
flowchart LR
subgraph MQ["消息队列三大应用场景"]
style MQ fill:#F0F2F5,stroke:#E0E6ED,stroke-width:1.5px
Async["异步处理"]
Decouple["解耦"]
Peak["削峰"]
end
Async --> A1["提高响应速度"]
Async --> A2["提升用户体验"]
Decouple --> D1["降低系统耦合"]
Decouple --> D2["提高扩展性"]
Peak --> P1["缓解系统压力"]
Peak --> P2["保证系统稳定"]
classDef app fill:#4CA497,color:#fff,rx:10,ry:10
classDef benefit fill:#00838F,color:#fff,rx:10,ry:10
class Async,Decouple,Peak app
class A1,A2,D1,D2,P1,P2 benefit
linkStyle default stroke-width:1.5px,opacity:0.8
```
### 消息队列会带来副作用吗?
没有哪一门技术是“银弹”,消息队列也有它的副作用。
比如,本来好好的两个系统之间的调用,我中间加了个消息队列,如果消息队列挂了怎么办呢?是不是 **降低了系统的可用性** ?
那这样是不是要保证 HA(高可用)?是不是要搞集群?那么我 **整个系统的复杂度是不是上升了** ?
抛开上面的问题不讲,万一我发送方发送失败了,然后执行重试,这样就可能产生重复的消息。
或者我消费端处理失败了,请求重发,这样也会产生重复的消息。
对于一些微服务来说,消费重复消息会带来更大的麻烦,比如增加积分,这个时候我加了多次是不是对其他用户不公平?
那么,又 **如何解决重复消费消息的问题** 呢?
如果我们此时的消息需要保证严格的顺序性怎么办呢?比如生产者生产了一系列的有序消息(对一个 id 为 1 的记录进行删除增加修改),但是我们知道在发布订阅模型中,对于主题是无顺序的,那么这个时候就会导致对于消费者消费消息的时候没有按照生产者的发送顺序消费,比如这个时候我们消费的顺序为修改删除增加,如果该记录涉及到金额的话是不是会出大事情?
那么,又 **如何解决消息的顺序消费问题** 呢?
就拿我们上面所讲的分布式系统来说,用户购票完成之后是不是需要增加账户积分?在同一个系统中我们一般会使用事务来进行解决,如果用 `Spring` 的话我们在上面伪代码中加入 `@Transactional` 注解就好了。但是在不同系统中如何保证事务呢?总不能这个系统我扣钱成功了你那积分系统积分没加吧?或者说我这扣钱明明失败了,你那积分系统给我加了积分。
那么,又如何 **解决分布式事务问题** 呢?
我们刚刚说了,消息队列可以进行削峰操作,那如果我的消费者如果消费很慢或者生产者生产消息很快,这样是不是会将消息堆积在消息队列中?
那么,又如何 **解决消息堆积的问题** 呢?
可用性降低、复杂度上升,同时还带来重复消费、顺序消费、分布式事务、消息堆积等一系列问题。这些问题如何解决?
下面我们逐一讨论这些问题的解决方案。
## RocketMQ 是什么?
在讨论上述问题的解决方案之前,我们先来了解一下 RocketMQ 的内部构造。建议带着问题去阅读和了解。
RocketMQ 是一个基于 **Topic 的发布订阅消息系统**,Topic 下可以包含多个 MessageQueue,MessageQueue 是消息存储和传输的最小队列单元。它具有**高性能、高可靠、高实时、分布式** 的特点,采用 Java 语言开发,由阿里巴巴团队在 2016 年底贡献给 Apache,成为 Apache 顶级项目。在阿里内部,RocketMQ 很好地服务了集团大大小小上千个应用,在每年的双十一当天,更有万亿级消息通过 RocketMQ 流转。
RocketMQ 具备高吞吐、低延迟、高可用的特点,经过了双十一等大规模场景的验证。
从 RocketMQ 5.x 开始,官方更强调云原生架构:Proxy 层支持 gRPC、多语言 SDK 和多协议接入,Broker 更专注消息存储和高可用。这意味着新项目选型时,除了看传统的 NameServer、Broker、Producer、Consumer,也要关注是否需要 Proxy、gRPC SDK、Kubernetes 部署和云原生可观测能力。
## 队列模型和主题模型是什么?
在谈 RocketMQ 的技术架构之前,我们先来了解一下两个名词概念——**队列模型** 和 **主题模型** 。
首先,为什么消息队列叫消息队列?
实际上,早期的消息中间件是通过 **队列** 这一模型来实现的,可能是历史原因,我们都习惯把消息中间件称为消息队列。
但是,如今例如 RocketMQ、Kafka 这些优秀的消息中间件不仅仅是通过一个 **队列** 来实现消息存储的。
### 队列模型
就像我们理解队列一样,消息中间件的队列模型就真的只是一个队列。
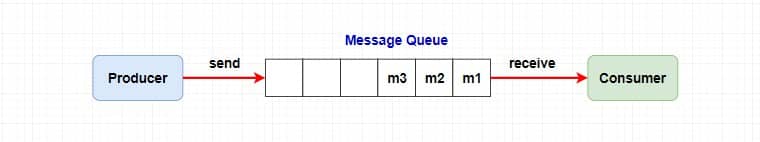
队列模型的特点:**一个消息只能被一个消费者消费**。
```mermaid
flowchart LR
P["生产者"] --> Q["队列"]
Q --> C1["消费者1"]
Q --> C2["消费者2"]
classDef producer fill:#4CA497,color:#fff,rx:10,ry:10
classDef queue fill:#E99151,color:#fff,rx:10,ry:10
classDef consumer fill:#00838F,color:#fff,rx:10,ry:10
class P producer
class Q queue
class C1,C2 consumer
linkStyle default stroke-width:1.5px,opacity:0.8
```
在一开始我跟你提到了一个 **“广播”** 的概念,也就是说如果我们此时我们需要将一个消息发送给多个消费者(比如此时我需要将信息发送给短信系统和邮件系统),这个时候单个队列即不能满足需求了。
当然你可以让 Producer 生产消息放入多个队列中,然后每个队列去对应每一个消费者。问题是可以解决,创建多个队列并且复制多份消息是会很影响资源和性能的。而且,这样子就会导致生产者需要知道具体消费者个数然后去复制对应数量的消息队列,这就违背我们消息中间件的 **解耦** 这一原则。
### 主题模型
那么有没有好的方法去解决这一个问题呢?有,那就是 **主题模型** 或者可以称为 **发布订阅模型** 。
> 感兴趣的同学可以去了解一下设计模式里面的观察者模式并且手动实现一下,我相信你会有所收获的。
在主题模型中,消息的生产者称为 **发布者(Publisher)** ,消息的消费者称为 **订阅者(Subscriber)** ,存放消息的容器称为 **主题(Topic)** 。
其中,发布者将消息发送到指定主题中,订阅者需要 **提前订阅主题** 才能接受特定主题的消息。
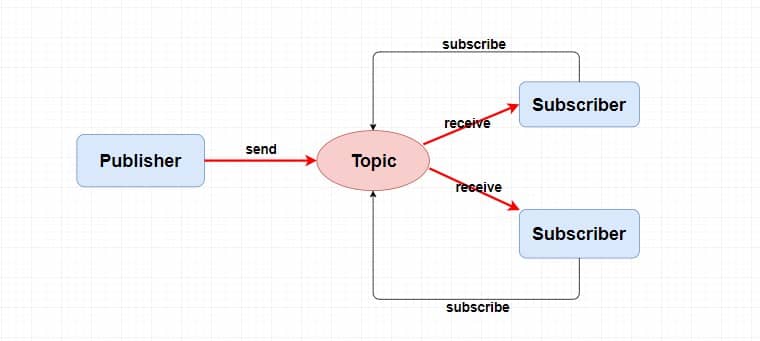
主题模型的特点:**一个 Topic 可以被多个消费者组订阅,每个消费者组都有独立的消费进度**。在集群消费模式下,同一消费者组内通常只由一个消费者实例处理某条消息;在广播消费模式下,同一消费者组内的每个消费者都会收到消息。
```mermaid
flowchart LR
P1["发布者1"] --> T["主题"]
P2["发布者2"] --> T
T --> S1["订阅者1"]
T --> S2["订阅者2"]
T --> S3["订阅者3"]
classDef publisher fill:#4CA497,color:#fff,rx:10,ry:10
classDef topic fill:#E99151,color:#fff,rx:10,ry:10
classDef subscriber fill:#00838F,color:#fff,rx:10,ry:10
class P1,P2 publisher
class T topic
class S1,S2,S3 subscriber
linkStyle default stroke-width:1.5px,opacity:0.8
```
### RocketMQ 中的消息模型
RocketMQ 中的消息模型就是按照 **主题模型** 所实现的。那么 **主题** 到底是怎么实现的呢?
其实对于主题模型的实现来说每个消息中间件的底层设计都是不一样的,就比如 Kafka 中的 **分区** ,RocketMQ 中的 **队列** ,RabbitMQ 中的 Exchange 。我们可以理解为 **主题模型/发布订阅模型** 就是一个标准,那些中间件只不过照着这个标准去实现而已。
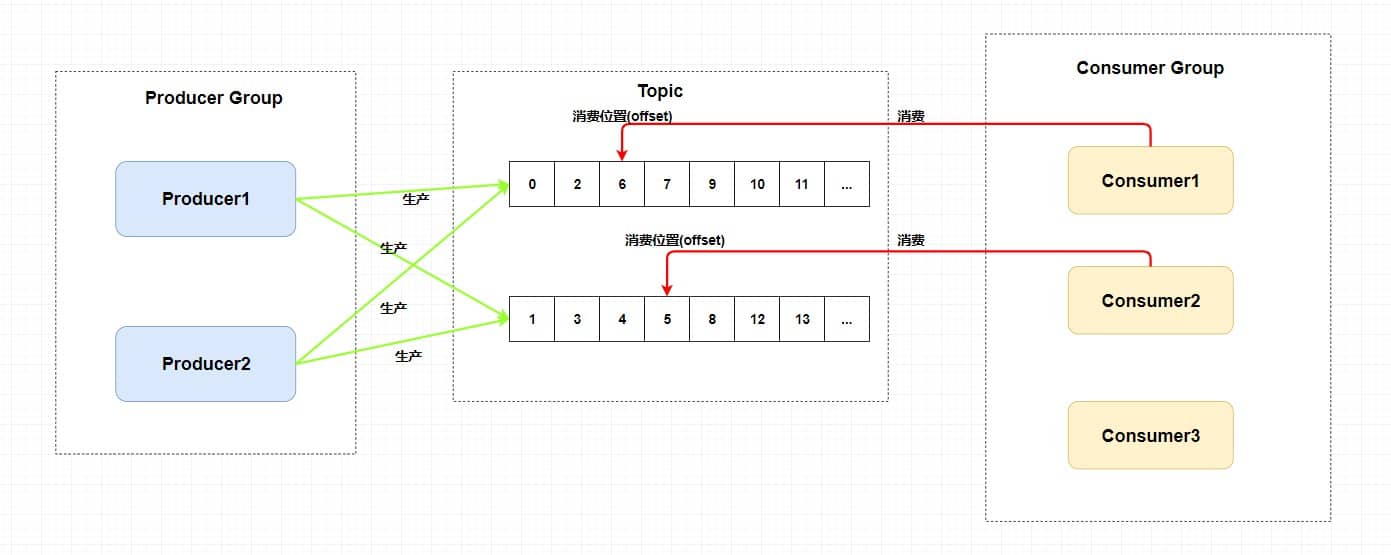
所以,RocketMQ 中的 **主题模型** 到底是如何实现的呢?先看一张图:
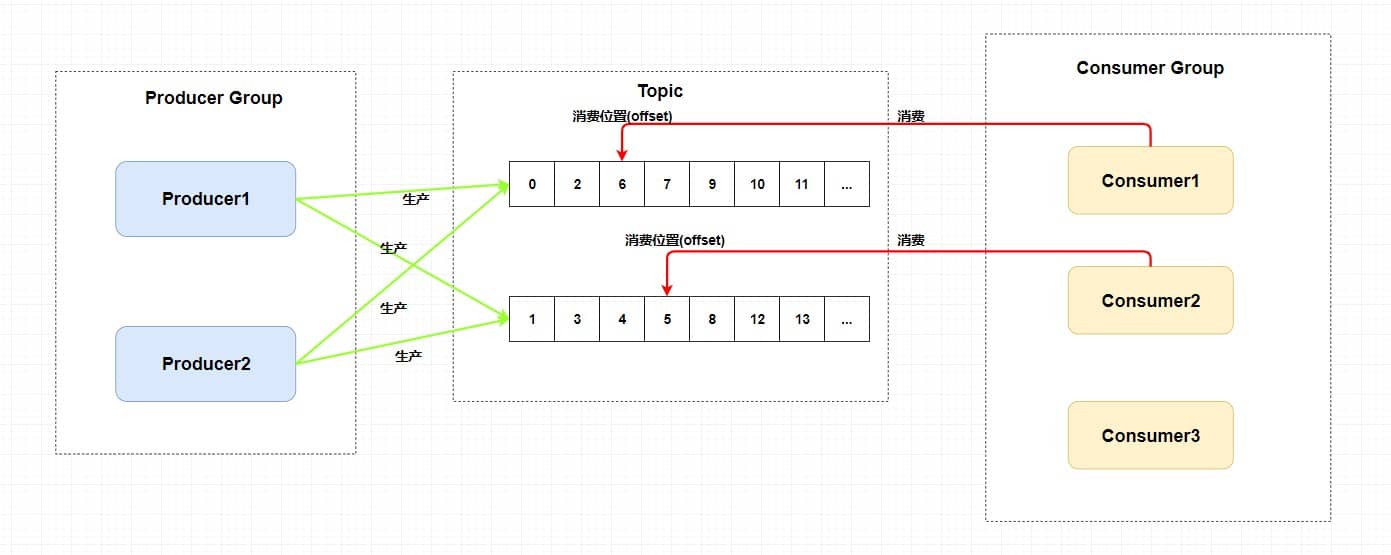
我们可以看到在整个图中有 `Producer Group`、Topic、`Consumer Group` 三个角色。这个图更接近早期和兼容模型,理解 5.x 时要记住:新版领域模型里生产者本身是轻量、匿名的,生产者组不再是重点概念。
- `Producer Group` 生产者组:在早期客户端和兼容场景中代表某一类生产者,比如我们有多个秒杀系统作为生产者,这多个合在一起就是一个 `Producer Group` 生产者组,它们一般生产相同的消息。
- `Consumer Group` 消费者组:代表某一类的消费者,比如我们有多个短信系统作为消费者,这多个合在一起就是一个 `Consumer Group` 消费者组,它们一般消费相同的消息。
- Topic 主题:代表一类消息,比如订单消息,物流消息等等。
你可以看到图中生产者组中的生产者会向主题发送消息,而 **主题中存在多个队列**,生产者每次生产消息之后会把消息发送到指定主题下的某个队列。
每个主题中都有多个队列(分布在不同的 Broker 中,如果是集群的话,Broker 又分布在不同的服务器中),集群消费模式下,一个消费者集群多台机器共同消费一个 `topic` 的多个队列。
**负载均衡策略对比**
```mermaid
flowchart TB
subgraph Queue["队列粒度负载均衡 4.x"]
style Queue fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
direction TB
Q1["队列1"] --> C1["消费者1"]
Q2["队列2"] --> C2["消费者2"]
Q3["队列3"] --> C3["消费者3"]
Q4["队列4"] -.-> C4["消费者4
(无队列可消费)"]
end
subgraph Message["消息粒度负载均衡 5.x Push/Simple"]
style Message fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
direction TB
MQ1["队列1"] --> MC1["消费者1
消费消息1"]
MQ1 --> MC2["消费者2
消费消息2"]
MQ1 --> MC3["消费者3
消费消息3"]
end
classDef queue fill:#4CA497,color:#fff,rx:10,ry:10
classDef consumer4x fill:#E99151,color:#fff,rx:10,ry:10
classDef consumer5x fill:#00838F,color:#fff,rx:10,ry:10
class Q1,Q2,Q3,Q4,MQ1 queue
class C1,C2,C3,C4 consumer4x
class MC1,MC2,MC3 consumer5x
linkStyle default stroke-width:1.5px,opacity:0.8
```
- **队列粒度负载均衡(4.x 默认策略)**:一个队列只会被一个消费者消费。如果某个消费者挂掉,分组内其它消费者会接替挂掉的消费者继续消费。队列数通常要大于或等于消费者数,消费者少于队列是常见情况,只是单个消费者会分到多个队列;如果消费者数多于队列数,多出来的消费者会空闲。这种模式的缺点是容易产生 **长尾效应**:如果某个消费者处理速度较慢,会导致其对应的队列消息堆积,而其他消费者却处于空闲状态。
- **消息粒度负载均衡(5.x PushConsumer/SimpleConsumer 默认策略)**:RocketMQ 5.x 中,PushConsumer 和 SimpleConsumer 默认使用消息粒度负载均衡,同一消费者分组内的多个消费者可以按照消息粒度分摊主题中的消息;PullConsumer 仍然是队列粒度。消费者获取某条消息后,服务端会将该消息加锁,保证这条消息对其他消费者不可见,直到该消息消费成功或消费超时。这种模式有效解决了长尾效应问题,因为消息不再静态绑定到某个消费者,而是动态分配给空闲的消费者。
消费者个数小于队列个数并不是问题,只是并发能力受消费者数量限制。真正需要避免的是队列数太少,导致后续扩容消费者时没有足够的队列可分配。如下图。

**每个消费组在每个队列上维护一个消费位置** ,为什么呢?
因为我们刚刚画的仅仅是一个消费者组,我们知道在发布订阅模式中一般会涉及到多个消费者组,而每个消费者组在每个队列中的消费位置都是不同的。如果此时有多个消费者组,那么消息被一个消费者组消费完之后是不会删除的(因为其它消费者组也需要呀),它仅仅是为每个消费者组维护一个 **消费位移(offset)** ,每次消费者组消费完会返回一个成功的响应,然后队列再把维护的消费位移加一,这样就不会出现刚刚消费过的消息再一次被消费了。
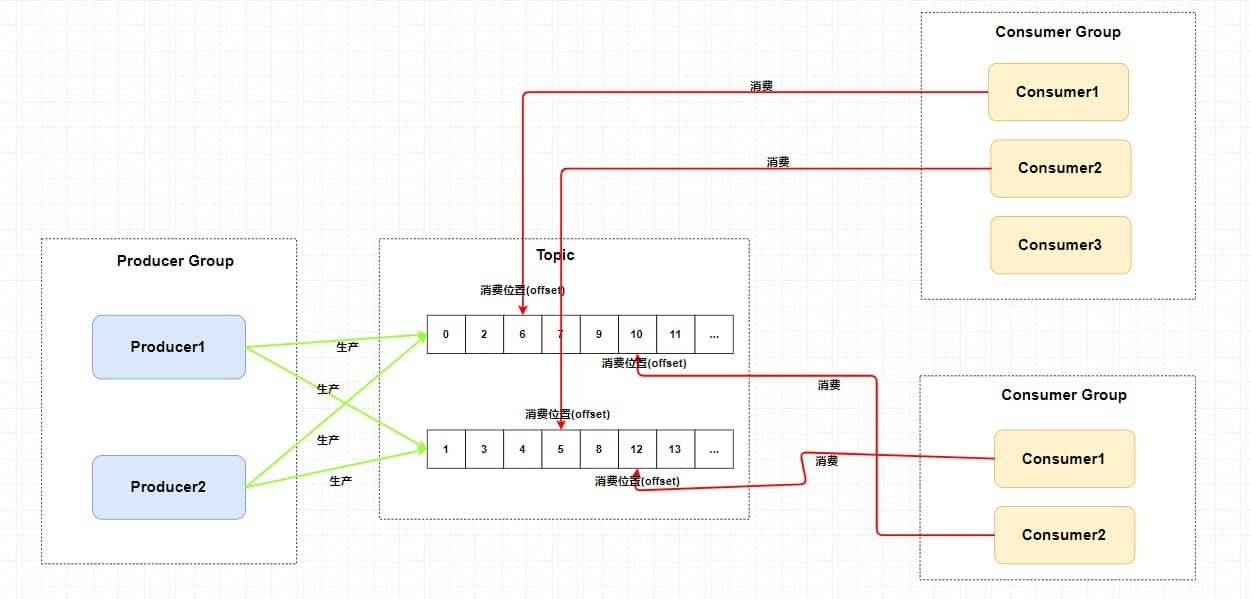
可能你还有一个问题,**为什么一个主题中需要维护多个队列** ?
答案是 **提高并发能力** 。的确,每个主题中只存在一个队列也是可行的。你想一下,如果每个主题中只存在一个队列,这个队列中也维护着每个消费者组的消费位置,这样也可以做到 **发布订阅模式** 。如下图。

但是,这样我生产者是不是只能向一个队列发送消息?又因为需要维护消费位置所以一个队列只能对应一个消费者组中的消费者,这样是不是其他的 Consumer 就没有用武之地了?从这两个角度来讲,并发度一下子就小了很多。
所以总结来说,RocketMQ 通过**使用在一个 Topic 中配置多个队列并且每个队列维护每个消费者组的消费位置** 实现了 **主题模式/发布订阅模式** 。
## RocketMQ 架构
讲完了消息模型,我们理解起 RocketMQ 的技术架构起来就容易多了。
RocketMQ 的核心组件包括 **NameServer、Broker、Producer、Consumer**,在 5.0 版本中还引入了 **Proxy** 组件。
```mermaid
flowchart TB
subgraph RocketMQ["RocketMQ 系统架构"]
direction TB
style RocketMQ fill:#F0F2F5,stroke:#E0E6ED,stroke-width:1.5px
subgraph Components["核心组件"]
direction TB
style Components fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
NS["NameServer
注册中心"]
BK["Broker
消息存储"]
PX["Proxy
代理层(5.0+)"]
PD["Producer
生产者"]
CM["Consumer
消费者"]
end
subgraph Protocol["通信协议"]
direction LR
style Protocol fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
RP["Remoting
私有协议"]
GP["gRPC
云原生协议"]
end
subgraph Network["网络层"]
style Network fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
NB["Netty
高性能通信框架"]
end
end
NS <--> BK
NS <--> PD
NS <--> CM
PD <--> PX
CM <--> PX
PX <--> BK
PD -.->|Remoting 直连| BK
CM -.->|Remoting 直连| BK
BK --> NB
RP --> NB
GP --> NB
classDef ns fill:#E99151,color:#fff,rx:10,ry:10
classDef broker fill:#4CA497,color:#fff,rx:10,ry:10
classDef proxy fill:#005D7B,color:#fff,rx:10,ry:10
classDef producer fill:#00838F,color:#fff,rx:10,ry:10
classDef consumer fill:#7E57C2,color:#fff,rx:10,ry:10
classDef remoting fill:#FFC107,color:#333,rx:10,ry:10
classDef grpc fill:#26A69A,color:#fff,rx:10,ry:10
classDef netty fill:#EF5350,color:#fff,rx:10,ry:10
class NS ns
class BK broker
class PX proxy
class PD producer
class CM consumer
class RP remoting
class GP grpc
class NB netty
linkStyle default stroke-width:1.5px,opacity:0.8
```
### 核心组件要点
| 组件 | 技术要点 |
| -------------- | ---------------------------------------- |
| **NameServer** | 轻量级注册中心,各节点无数据同步 |
| **Broker** | 消息存储与投递,支持主从部署 |
| **Proxy** | 5.0 新增,协议适配与计算卸载(可选组件) |
| **Producer** | 同步、异步、单向多种发送方式 |
| **Consumer** | Push/Pull/Simple 三种消费模式 |
### NameServer(注册中心)
NameServer 负责元数据的存储,扮演着集群“中枢神经系统”的角色,其核心作用是为生产者和消费者提供路由信息,帮助它们找到对应的 Broker 地址。
**核心功能:**
1. **Broker 管理**:Broker 启动时主动连接 NameServer,上报元数据信息。
2. **路由信息管理**:生产者和消费者从 NameServer 获取 Broker 路由表。
**心跳机制:**
```mermaid
flowchart LR
subgraph Heartbeat["心跳机制"]
style Heartbeat fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
direction TB
BK["Broker"] -->|启动时| Reg["注册元数据"]
BK -->|每隔30秒| HB["发送心跳包"]
HB --> NS["NameServer
更新路由表"]
NS -->|每隔10秒检查| Check["检查心跳
(120秒超时)"]
Check -->|超时| Down["标记Broker宕机"]
end
classDef broker fill:#4CA497,color:#fff,rx:10,ry:10
classDef ns fill:#E99151,color:#fff,rx:10,ry:10
classDef check fill:#FFC107,color:#333,rx:10,ry:10
classDef down fill:#EF5350,color:#fff,rx:10,ry:10
classDef default fill:#4CA497,color:#fff,rx:10,ry:10
class BK broker
class NS ns
class Check check
class Down down
class Reg,HB default
linkStyle default stroke-width:1.5px,opacity:0.8
```
**元数据包含:**
- Broker 的地址、名称、BrokerId
- 主节点地址
- 该 Broker 上的所有 Topic 的队列配置
### Broker(消息存储)
Broker 负责消息的存储、投递和查询以及服务高可用保证。
**存储机制:**
1. **消息写入**:收到消息后顺序追加到 CommitLog 文件
2. **文件分割**:文件超过固定大小(默认 1G)生成新文件
3. **逻辑分片**:MessageQueue 是逻辑分片,ConsumeQueue 是消息索引
**一个 Topic 分布在多个 Broker 上,一个 Broker 可以配置多个 Topic ,它们是多对多的关系**。
如果某个 Topic 消息量很大,应该给它多配置几个队列(上文中提到了提高并发能力),并且 **尽量多分布在不同 Broker 上,以减轻某个 Broker 的压力** 。
Topic 消息量都比较均匀的情况下,如果某个 Broker 上的队列越多,则该 Broker 压力越大。

### Producer(生产者)
**发送流程:**
```mermaid
flowchart TB
subgraph ProducerFlow["生产者发送流程"]
direction TB
style ProducerFlow fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
P["Producer 启动"] -->|1.建立长连接| NS1["连接 NameServer
获取路由表"]
NS1 -->|2.选择队列| LB["负载均衡算法
选择 MessageQueue"]
LB -->|3.建立连接| BK["与 Broker 建立长连接"]
BK -->|4.发送消息| MSG["发送消息到
MessageQueue"]
end
classDef producer fill:#00838F,color:#fff,rx:10,ry:10
classDef ns fill:#E99151,color:#fff,rx:10,ry:10
classDef lb fill:#FFC107,color:#333,rx:10,ry:10
classDef broker fill:#4CA497,color:#fff,rx:10,ry:10
classDef msg fill:#7E57C2,color:#fff,rx:10,ry:10
class P producer
class NS1 ns
class LB lb
class BK broker
class MSG msg
linkStyle default stroke-width:1.5px,opacity:0.8
```
**三种发送方式:**
- **单向发送(Oneway)**:发送后立即返回,不关心是否成功
- **同步发送(Sync)**:发送后等待响应
- **异步发送(Async)**:发送后立即返回,在回调方法中处理响应
### Consumer(消费者)
**消费流程:**
```mermaid
flowchart TB
subgraph ConsumerFlow["消费者消费流程"]
direction TB
style ConsumerFlow fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
C["Consumer 启动"] -->|1.建立长连接| NS2["连接 NameServer
获取路由表"]
NS2 -->|2.建立连接| BK2["与 Broker 建立连接"]
BK2 -->|3.消费消息| CONS["开始消费消息"]
CONS -->|4.提交位点| OFFSET["提交消费位点
保存消费进度"]
end
classDef consumer fill:#7E57C2,color:#fff,rx:10,ry:10
classDef ns fill:#E99151,color:#fff,rx:10,ry:10
classDef broker fill:#4CA497,color:#fff,rx:10,ry:10
classDef consume fill:#00838F,color:#fff,rx:10,ry:10
classDef offset fill:#FFC107,color:#333,rx:10,ry:10
class C consumer
class NS2 ns
class BK2 broker
class CONS consume
class OFFSET offset
linkStyle default stroke-width:1.5px,opacity:0.8
```
**三种消费模式:**
- **拉取模式(Pull)**:消费者主动向 Broker 发送拉取请求
- **推模式(Push)**:长轮询机制,Broker 有消息时才返回
- **无状态模式(Pop)**:RocketMQ 5.0 新增,服务端管理重平衡和位点
### 网络协议
RocketMQ 目前常见的是 Remoting 和 gRPC 两类接入方式:
| 对比项 | Remoting(传统协议) | gRPC(5.x 新版 SDK) |
| ---------- | ----------------------------------- | ----------------------------------------- |
| **成熟度** | Java 生态使用时间长,路径短 | 适合多语言和云原生接入,通常经 Proxy 接入 |
| **扩展性** | 多语言接入需要分别适配 | 基于标准协议,客户端生态和网关治理更友好 |
| **取舍** | 适合已有 4.x 客户端和内部高性能链路 | 链路多一层 Proxy 时,要额外关注延迟和容量 |
### 网络模块(基于 Netty)
RocketMQ 的 RPC 通信采用 Netty 作为底层通信库,基于 Reactor 多线程模型进行了深度扩展和优化。
**线程模型总结:**
- **Reactor 主线程**:1 个,负责监听连接
- **Reactor 线程池**:默认 3 个,负责网络数据处理
- **业务线程池**:动态调整,根据 CPU 核心数
### Proxy(代理层,5.0 新增)
RocketMQ 5.0 引入了 **Proxy** 组件,这是 **计算与存储分离** 架构的核心体现。Proxy 作为客户端与 Broker 之间的代理层,将客户端协议适配、权限管理、消费管理等计算逻辑从 Broker 中剥离出来,使 Broker 更专注于消息存储和高可用。这种设计对于云原生架构非常重要,使得计算层可以独立弹性扩展。
**两种部署模式:**
| 模式 | 说明 | 适用场景 |
| ---------------- | ----------------------------------------------- | ---------------------------------------- |
| **Local 模式** | Proxy 和 Broker 同进程部署,只需新增 Proxy 配置 | 从旧版本平滑升级,或无特殊需求的场景 |
| **Cluster 模式** | Proxy 和 Broker 分别独立部署 | 需要弹性扩展或对协议适配有定制需求的场景 |
**核心作用:**
- **协议适配**:支持 gRPC 协议接入,方便多语言客户端接入
- **计算卸载**:将认证鉴权、消费管理等计算逻辑从 Broker 剥离,降低 Broker 负载
- **弹性扩展**:Proxy 无状态,可独立水平扩展
> **注意**:在 5.0 版本中,使用新版 SDK(gRPC 协议)的客户端需要通过 Proxy 接入,而旧版 SDK(Remoting 协议)仍然可以直连 Broker。
Proxy 的价值不只是“多一层代理”。在云原生场景下,它可以把协议接入、认证鉴权、流量治理、消费管理这类计算逻辑从 Broker 中剥离出来,让 Broker 更稳定地承担存储职责。代价是链路多了一跳,需要额外关注 Proxy 的水平扩容、延迟、限流和监控。
### 为什么必须要 NameServer?
先看一个简单的架构模型:
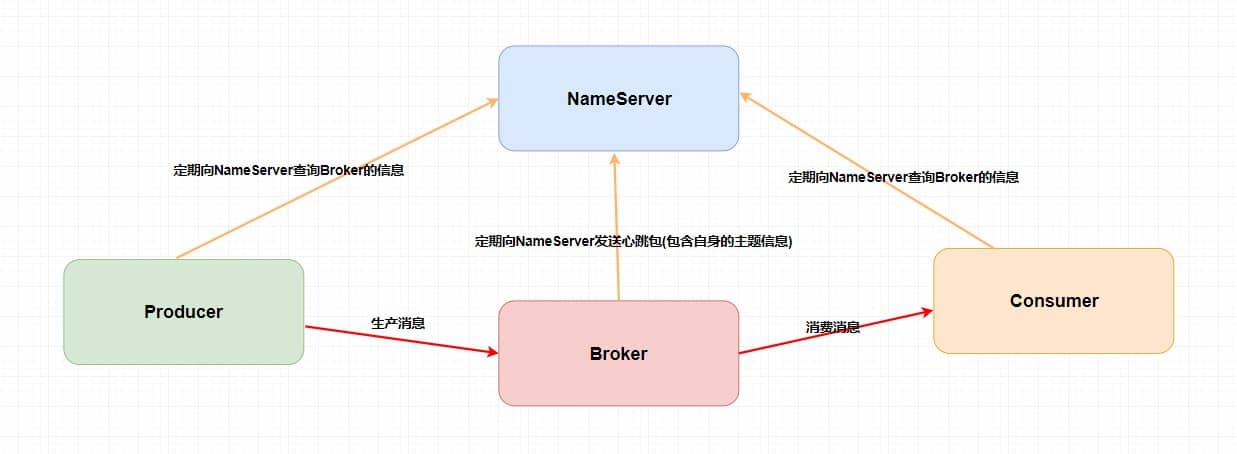
你可能会发现一个问题:NameServer 是做什么的?直接让 Producer、Consumer 和 Broker 进行生产和消费消息不行吗?
Broker 需要保证高可用,如果整个系统仅靠一个 Broker 来维持,压力会非常大,所以需要使用多个 Broker 来保证 **负载均衡**。如果消费者和生产者直接和多个 Broker 相连,当 Broker 变更时会牵连每个生产者和消费者,产生耦合问题。NameServer 注册中心就是用来解决这个问题的。
**NameServer 的设计哲学:**
NameServer 是 **无状态的、各节点之间互不通信** 的。这与 ZooKeeper 的强一致性(需要选举机制)形成了鲜明对比,体现了 RocketMQ 追求 **极致性能和简单架构** 的设计哲学。每个 Broker 与所有 NameServer 保持长连接,定期上报自身信息,即使某个 NameServer 节点宕机,也不会影响整个集群的可用性。
下面是官网的架构图:
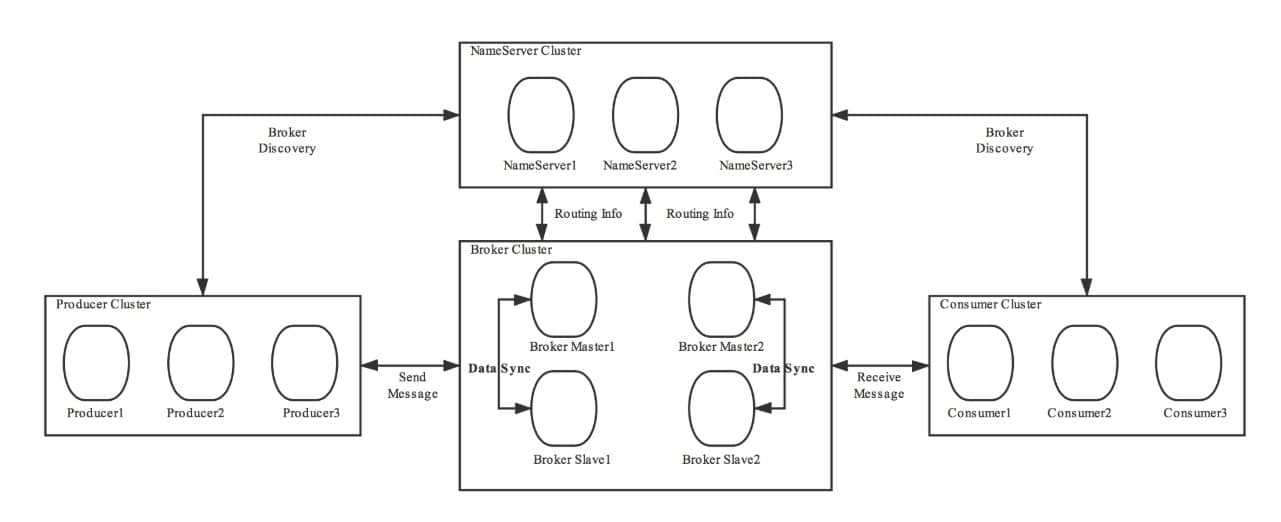
和前面的简化架构图相比,主要是一些细节上的差别:
第一、Broker **做了集群并且还进行了主从部署** ,由于消息分布在各个 Broker 上,一旦某个 Broker 宕机,则该 Broker 上的消息读写都会受到影响。所以 RocketMQ 提供了 `master/slave` 的结构,`slave` 定时从 `master` 同步数据(同步刷盘或者异步刷盘),如果 `master` 宕机,**则 `slave` 提供消费服务,但是不能写入消息** (后面还会详细说明)。
第二、为了保证 HA,NameServer 也做了集群部署,但它是 **去中心化** 的。也就意味着它没有主节点,可以明显看出 NameServer 的所有节点之间没有进行 `Info Replicate`。在 RocketMQ 中,**单个 Broker 和所有 NameServer 保持长连接**,并且 **每隔 30 秒** Broker 会向所有 NameServer 发送心跳,心跳包含了自身的 Topic 配置信息。NameServer **每隔 10 秒** 检查一次心跳,如果某个 Broker **超过 120 秒** 没有心跳,则认为该 Broker 已宕机。
第三、在生产者需要向 Broker 发送消息的时候,**需要先从 NameServer 获取关于 Broker 的路由信息**,然后通过 **轮询** 的方法去向每个队列中生产数据以达到 **负载均衡** 的效果。
第四、消费者通过 NameServer 获取所有 Broker 的路由信息后,向 Broker 发送 `Pull` 请求来获取消息数据。Consumer 可以以两种模式启动—— **广播(Broadcast)和集群(Cluster)**。广播模式下,一条消息会发送给 **同一个消费组中的所有消费者** ,集群模式下消息只会发送给一个消费者。
## RocketMQ 消息
### 普通消息
普通消息一般应用于微服务解耦、事件驱动、数据集成等场景,这些场景大多数要求数据传输通道具有可靠传输的能力,且对消息的处理时机、处理顺序没有特别要求。以在线的电商交易场景为例,上游订单系统将用户下单支付这一业务事件封装成独立的普通消息并发送至 RocketMQ 服务端,下游按需从服务端订阅消息并按照本地消费逻辑处理下游任务。每个消息之间都是相互独立的,且不需要产生关联。另外还有日志系统,以离线的日志收集场景为例,通过埋点组件收集前端应用的相关操作日志,并转发到 RocketMQ 。
**普通消息生命周期**
```mermaid
flowchart LR
N1["初始化"] --> N2["待消费"] --> N3["消费中"] --> N4["消费提交"] --> N5["消息删除"]
classDef default fill:#4CA497,color:#fff,rx:10,ry:10
classDef final fill:#00838F,color:#fff,rx:10,ry:10
class N1,N2,N3,N4 default
class N5 final
linkStyle default stroke-width:1.5px,opacity:0.8
```
- 初始化:消息被生产者构建并完成初始化,待发送到服务端的状态。
- 待消费:消息被发送到服务端,对消费者可见,等待消费者消费的状态。
- 消费中:消息被消费者获取,并按照消费者本地的业务逻辑进行处理的过程。 此时服务端会等待消费者完成消费并提交消费结果,如果一定时间后没有收到消费者的响应,RocketMQ 会对消息进行重试处理。
- 消费提交:消费者完成消费处理,并向服务端提交消费结果;如果消费失败或超时,消息会按重试策略重新投递,超过最大重试次数后可能进入死信队列。RocketMQ 不会因为某个消费组消费成功就立即删除消息,而是按照消息保存机制滚动清理,消息在保存时间到期或存储空间不足被删除前,消费者仍然可以回溯消息重新消费。
- 消息删除:RocketMQ 按照消息保存机制滚动清理最早的消息数据,将消息从物理文件中删除。
### 定时/延时消息
> **备注:定时消息和延时消息本质相同,都是服务端根据消息设置的定时时间在某一固定时刻将消息投递给消费者消费。**
在分布式定时调度触发、任务超时处理等场景,需要实现精准、可靠的定时事件触发。使用 RocketMQ 的定时消息可以简化定时调度任务的开发逻辑,实现高性能、可扩展、高可靠的定时触发能力。
**典型场景一:分布式定时调度**
在分布式定时调度场景下,需要实现各类精度的定时任务,例如每天 5 点执行文件清理,每隔 2 分钟触发一次消息推送等需求。传统基于数据库的定时调度方案在分布式场景下,性能不高,实现复杂。
**典型场景二:任务超时处理**
以电商交易场景为例,订单下单后暂未支付,此时不可以直接关闭订单,而是需要等待一段时间后才能关闭订单。使用 RocketMQ 定时消息可以实现超时任务的检查触发。
基于定时消息的超时任务处理具备如下优势:
- **精度更灵活、开发门槛低**:5.x 不再只依赖固定延迟等级,可以按时间戳设置投递时间;但默认投递粒度仍是秒级,不能理解为严格毫秒级准时触发。
- **高性能可扩展**:传统的数据库扫描方式较为复杂,需要频繁调用接口扫描,容易产生性能瓶颈。RocketMQ 的定时消息具有高并发和水平扩展的能力。
**定时时间设置原则**
RocketMQ 定时消息设置的定时时间是一个预期触发的系统时间戳,延时时间也需要转换成当前系统时间后的某一个时间戳,而不是一段延时时长。
- **时间格式**:毫秒级的 Unix 时间戳
- **定时时长最大值**:默认为 24 小时,不支持自定义修改
- **定时时间必须设置在当前时间之后**,否则定时不生效,服务端会立即投递消息
**示例**:
- 定时消息:当前系统时间为 2022-06-09 17:30:00,希望消息在 19:20:00 投递,则定时时间戳为 1654773600000
- 延时消息:当前系统时间为 2022-06-09 17:30:00,希望延时 1 小时后投递,则定时时间戳为 1654770600000
**4.x 版本与 5.x 版本的区别**
- **4.x 版本**:只支持延时消息,默认分为 18 个等级(1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h),也可以在配置文件中增加自定义的延时等级和时长。
- **5.x 版本**:支持通过毫秒级 Unix 时间戳设置投递时间,相比 4.x 固定延迟等级更灵活;但默认定时粒度为 1000ms,实际投递还会受服务端负载、存储恢复等因素影响,不能理解为严格毫秒级准时触发。
**定时消息生命周期**
```mermaid
flowchart LR
T1["初始化"] --> T2["定时中"] --> T3["待消费"] --> T4["消费中"] --> T5["消费提交"] --> T6["消息删除"]
classDef default fill:#E99151,color:#fff,rx:10,ry:10
classDef final fill:#00838F,color:#fff,rx:10,ry:10
class T1,T2,T3,T4,T5 default
class T6 final
linkStyle default stroke-width:1.5px,opacity:0.8
```
- **初始化**:消息被生产者构建并完成初始化,待发送到服务端的状态。
- **定时中**:消息被发送到服务端,和普通消息不同的是,服务端不会直接构建消息索引,而是会将定时消息**单独存储在定时存储系统中**,等待定时时刻到达。
- **待消费**:定时时刻到达后,服务端将消息重新写入普通存储引擎,对下游消费者可见,等待消费者消费的状态。
- **消费中**:消息被消费者获取,并按照消费者本地的业务逻辑进行处理的过程。此时服务端会等待消费者完成消费并提交消费结果,如果一定时间后没有收到消费者的响应,RocketMQ 会对消息进行重试处理。
- **消费提交**:消费者完成消费处理,并向服务端提交消费结果;如果消费失败或超时,消息会按重试策略重新投递,超过最大重试次数后可能进入死信队列。RocketMQ 不会因为某个消费组消费成功就立即删除消息,而是按照消息保存机制滚动清理。
- **消息删除**:Apache RocketMQ 按照消息保存机制滚动清理最早的消息数据,将消息从物理文件中删除。
**使用限制**
1. **消息类型一致性**:定时消息仅支持在 MessageType 为 Delay 的主题内使用
2. **定时精度约束**:定时时长参数精确到毫秒级,但默认精度为 1000ms(秒级精度)
**使用建议**
定时消息的实现逻辑需要先经过定时存储等待触发,定时时间到达后才会被投递给消费者。因此,如果将大量定时消息的定时时间设置为同一时刻,则到达该时刻后会有大量消息同时需要被处理,会造成系统压力过大,导致消息分发延迟,影响定时精度。
### 顺序消息
**什么是顺序消息**
顺序消息是 Apache RocketMQ 提供的一种高级消息类型,支持消费者按照发送消息的先后顺序获取消息,从而实现业务场景中的顺序处理。
**应用场景**
在有序事件处理、撮合交易、数据实时增量同步等场景下,异构系统间需要维持强一致的状态同步,上游的事件变更需要按照顺序传递到下游进行处理。
- **撮合交易**:以证券、股票交易撮合场景为例,对于出价相同的交易单,坚持按照先出价先交易的原则,下游处理订单的系统需要严格按照出价顺序来处理订单。
- **数据实时增量同步**:以数据库变更增量同步场景为例,上游源端数据库按需执行增删改操作,将二进制操作日志作为消息,通过 RocketMQ 传输到下游搜索系统,下游系统按顺序还原消息数据,实现状态数据按序刷新。
**如何保证消息的顺序性**
RocketMQ 的消息顺序性分为两部分:**生产顺序性**和**消费顺序性**。
**生产顺序性**
如需保证消息生产的顺序性,则必须满足以下条件:
1. **单一生产者**:消息生产的顺序性仅支持单一生产者
2. **串行发送**:生产者使用多线程并行发送时,不同线程间产生的消息将无法判定其先后顺序
满足以上条件的生产者,将顺序消息发送至 RocketMQ 后,会保证设置了同一**消息组**的消息,按照发送顺序存储在同一队列中。
**消息组(MessageGroup)**
RocketMQ 顺序消息的顺序关系通过消息组(MessageGroup)判定和识别,发送顺序消息时需要为每条消息设置归属的消息组。
- **相同消息组**的多条消息之间遵循先进先出的顺序关系
- **不同消息组**、无消息组的消息之间不涉及顺序性
基于消息组的顺序判定逻辑,支持按照业务逻辑做细粒度拆分,可以在满足业务局部顺序的前提下提高系统的并行度和吞吐能力。
```mermaid
flowchart TB
subgraph Order["订单系统"]
style Order fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
O1["订单A
消息组: orderA"]
O2["订单B
消息组: orderB"]
O3["订单C
消息组: orderC"]
end
subgraph Queue["队列"]
style Queue fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
Q["队列1
(混合存储不同消息组)"]
end
subgraph Storage["存储顺序"]
style Storage fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
direction LR
S1["orderA-M1
↓"]
S2["orderB-M1
↓"]
S3["orderA-M2
↓"]
S4["orderC-M1
↓"]
S5["orderB-M2
↓"]
end
O1 --> Q
O2 --> Q
O3 --> Q
Q --> Storage
classDef orderA fill:#4CA497,color:#fff,rx:10,ry:10
classDef orderB fill:#E99151,color:#fff,rx:10,ry:10
classDef orderC fill:#7E57C2,color:#fff,rx:10,ry:10
classDef queue fill:#00838F,color:#fff,rx:10,ry:10
classDef storage fill:#FFC107,color:#333,rx:10,ry:10
class O1 orderA
class O2 orderB
class O3 orderC
class Q queue
class S1,S2,S3,S4,S5 storage
linkStyle default stroke-width:1.5px,opacity:0.8
```
**说明**:
- orderA 消息组的 M1、M2 保持顺序
- orderB 消息组的 M1、M2 保持顺序
- 不同消息组可以混合存储在同一个队列中
**消费顺序性**
如需保证消息消费的顺序性,则必须满足以下条件:
1. **投递顺序**:RocketMQ 通过客户端 SDK 和服务端通信协议保障消息按照服务端存储顺序投递
2. **有限重试**:顺序消息投递仅在重试次数限定范围内,超过最大重试次数后将不再重试,跳过这条消息消费
**消费者类型对顺序消费的影响**
- **PushConsumer**:RocketMQ 保证消息按照存储顺序一条一条投递给消费者
- **SimpleConsumer**:消费者可能一次拉取多条消息,此时消息消费的顺序性需要由业务方自行保证
**生产顺序性和消费顺序性组合**
| 生产顺序 | 消费顺序 | 顺序性效果 |
| ---------------------------- | -------- | ---------------------------------------- |
| 设置消息组,保证消息顺序发送 | 顺序消费 | 按照消息组粒度,严格保证消息顺序 |
| 设置消息组,保证消息顺序发送 | 并发消费 | 并发消费,尽可能按时间顺序处理 |
| 未设置消息组,消息乱序发送 | 顺序消费 | 只能保证队列存储顺序,不保证业务发送顺序 |
| 未设置消息组,消息乱序发送 | 并发消费 | 并发消费,尽可能按照时间顺序处理 |
**使用限制**
1. **消息类型一致性**:顺序消息仅支持在 MessageType 为 FIFO 的主题内使用;RocketMQ 5.x 中还要为有序消息设置 MessageGroup,并把消费者组配置为顺序投递,否则仍可能按并发方式投递
2. 顺序消息消费失败进行消费重试时,为保障消息的顺序性,后续消息不可被消费,必须等待前面的消息消费完成后才能被处理
**使用建议**
1. **串行消费**:消息消费建议串行处理,避免一次消费多条消息导致乱序
2. **消息组尽可能打散**:建议将业务以消息组粒度进行拆分,例如将订单 ID、用户 ID 作为消息组关键字,可实现同一终端用户的消息按照顺序处理,不同用户的消息无需保证顺序
### 事务消息
**什么是事务消息**
事务消息是 Apache RocketMQ 提供的一种高级消息类型,支持在分布式场景下保障消息生产和本地事务的最终一致性。简单来讲,就是将本地事务(数据库的 DML 操作)与发送消息合并在同一个事务中。
**应用场景**
在分布式系统调用的特点为一个核心业务逻辑的执行,同时需要调用多个下游业务进行处理。如何保证核心业务和多个下游业务的执行结果完全一致,是分布式事务需要解决的主要问题。
以电商交易场景为例,用户支付订单这一核心操作的同时会涉及到下游物流发货、积分变更、购物车状态清空等多个子系统的变更:
- **主分支订单系统状态更新**:由未支付变更为支付成功
- **物流系统状态新增**:新增待发货物流记录,创建订单物流记录
- **积分系统状态变更**:变更用户积分,更新用户积分表
- **购物车系统状态变更**:清空购物车,更新用户购物车记录
**传统方案的问题**
- **传统 XA 事务方案**:基于 XA 协议的分布式事务系统可以实现一致性,但多分支环境下资源锁定范围大,并发度低
- **基于普通消息方案**:普通消息和订单事务无法保证一致,容易出现消息发送成功但订单没有执行成功、订单执行成功但消息没有发送成功等情况
**RocketMQ 事务消息方案**
RocketMQ 事务消息的方案,具备高性能、可扩展、业务开发简单的优势,支持二阶段的提交能力,将二阶段提交和本地事务绑定,实现 **本地事务和消息发送** 的最终一致性。
**事务消息处理流程**
```mermaid
flowchart TB
subgraph Phase1["阶段一: 发送半事务消息"]
direction TB
style Phase1 fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
M1["生产者构建消息"] --> M2["发送至服务端"]
M2 --> M3["服务端持久化消息"]
M3 --> M4["返回 Ack 确认"]
M4 --> M5["消息标记为
'暂不能投递'
(半事务消息)"]
end
subgraph Phase2["阶段二: 执行本地事务"]
direction TB
style Phase2 fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
L1["生产者开始执行
本地事务逻辑"] --> L2{"本地事务
执行结果"}
L2 -->|Commit| L3["提交二次确认 Commit"]
L2 -->|Rollback| L4["提交二次确认 Rollback"]
L2 -->|Unknown| L5["等待事务回查"]
end
subgraph Phase3["阶段三: 事务回查机制"]
direction TB
style Phase3 fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
C1["服务端未收到确认
或收到 Unknown"] --> C2["固定时间后
发起消息回查"]
C2 --> C3["生产者检查本地事务
最终状态"]
C3 --> C4["再次提交二次确认"]
end
subgraph Result["最终处理"]
style Result fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
direction TB
R1["Commit: 消息投递给消费者"]
R2["Rollback: 回滚事务
不投递消息"]
end
Phase1 --> Phase2
L3 --> R1
L4 --> R2
L5 --> Phase3
C4 --> R1
classDef normal fill:#4CA497,color:#fff,rx:10,ry:10
classDef decision fill:#E99151,color:#fff,rx:10,ry:10
classDef result fill:#00838F,color:#fff,rx:10,ry:10
class M1,M2,M3,M4,M5,L1,C1,C2,C3,C4 normal
class L2,L3,L4,L5 decision
class R1,R2 result
linkStyle default stroke-width:1.5px,opacity:0.8
```
1. 生产者将消息发送至 RocketMQ 服务端
2. 服务端将消息持久化成功之后,向生产者返回 Ack 确认消息已经发送成功,此时消息被标记为“暂不能投递”,这种状态下的消息即为**半事务消息**
3. 生产者开始执行本地事务逻辑
4. 生产者根据本地事务执行结果向服务端提交二次确认结果(Commit 或 Rollback)
5. 如果服务端未收到二次确认结果,或收到的结果为 Unknown,经过固定时间后,服务端将对消息生产者发起**消息回查**
6. 生产者收到消息回查后,需要检查对应消息的本地事务执行的最终结果
7. 生产者根据检查到的本地事务的最终状态再次提交二次确认
**事务消息生命周期**
- **初始化**:半事务消息被生产者构建并完成初始化,待发送到服务端的状态
- **事务待提交**:半事务消息被发送到服务端后会被持久化到事务相关的存储中,但不会直接进入普通可消费状态;它需要等待第二阶段本地事务返回 Commit 或 Rollback 后再决定是否投递。此时消息对下游消费者不可见
- **消息回滚**:第二阶段如果事务执行结果明确为回滚,服务端会将半事务消息回滚,该事务消息流程终止
- **提交待消费**:第二阶段如果事务执行结果明确为提交,服务端会将半事务消息重新存储到普通存储系统中,此时消息对下游消费者可见
- **消费中**:消息被消费者获取,并按照消费者本地的业务逻辑进行处理的过程
- **消费提交**:消费者完成消费处理,并向服务端提交消费结果;如果消费失败或超时,仍会进入重试、死信或补偿流程
- **消息删除**:RocketMQ 按照消息保存机制滚动清理最早的消息数据
**使用限制**
1. **消息类型一致性**:事务消息仅支持在 MessageType 为 Transaction 的主题内使用
2. **消费事务性**:RocketMQ 事务消息保证本地主分支事务和下游消息发送事务的一致性,但不保证消息消费结果和上游事务的一致性
3. **中间状态可见性**:事务消息为最终一致性,即消息提交到下游消费端处理完成之前,下游分支和上游事务之间的状态会不一致
4. **事务超时机制**:事务消息的生命周期存在超时机制,半事务消息被生产者发送服务端后,如果在指定时间内服务端无法确认提交或者回滚状态,则消息默认会被回滚
5. **事务回查机制**:服务端默认 **每隔 60 秒** 对未确认的半事务消息发起回查;半事务消息默认最大超时时间为 **4 小时**,超时后会被强制回滚。老版本或部分云厂商实现可能还会暴露最大回查次数参数,面试和生产配置时要按实际版本确认。
**使用建议**
1. **避免大量未决事务导致超时**:生产者应该尽量避免本地事务返回未知结果,大量的事务检查会导致系统性能受损
2. **正确处理“进行中”的事务**:消息回查时,对于正在进行中的事务不要返回 Rollback 或 Commit 结果,应继续保持 Unknown 的状态
3. **本地事务状态要可查询**:事务回查依赖生产者查询本地事务最终状态,建议落库或写可靠存储,不要只放进进程内存。
4. **下游消费仍需幂等**:事务消息解决的是“本地事务和消息发送”的一致性,不保证消费者业务一定成功,消费端仍然要有重试、幂等和补偿。
### 关于发送消息
#### 不建议单一进程创建大量生产者
Apache RocketMQ 的生产者和主题是多对多的关系,支持同一个生产者向多个主题发送消息。对于生产者的创建和初始化,建议遵循够用即可、最大化复用原则,如果有需要发送消息到多个主题的场景,无需为每个主题都创建一个生产者。
#### 不建议频繁创建和销毁生产者
Apache RocketMQ 的生产者是可以重复利用的底层资源,类似数据库的连接池。因此不需要在每次发送消息时动态创建生产者,且在发送结束后销毁生产者。这样频繁的创建销毁会在服务端产生大量短连接请求,严重影响系统性能。
正确示例:
```java
Producer p = ProducerBuilder.build();
for (int i =0;i msgs,
ConsumeConcurrentlyContext context) {
System.out.printf("Receive New Messages: %s %n", msgs);
// 业务处理逻辑
return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
}
});
consumer.start();
}
```
**消费监听器执行结果:**
- **返回消费成功**:表示该消息处理成功,服务端按照消费结果更新消费进度
- **返回消费失败**:表示该消息处理失败,需要根据消费重试逻辑判断是否进行重试消费
- **抛出异常**:按消费失败处理,需要根据消费重试逻辑判断是否进行重试消费
**使用注意事项:**
PushConsumer 消费时,不允许使用以下方式处理消息:
1. **错误方式一**:消息还未处理完成,就提前返回消费成功结果。此时如果消息消费失败,RocketMQ 服务端是无法感知的,因此不会进行消费重试。
2. **错误方式二**:在消费监听器内将消息再次分发到自定义的其他线程,消费监听器提前返回消费结果。此时如果消息消费失败,RocketMQ 服务端同样无法感知,因此也不会进行消费重试。
**Push 模式工作原理:**
1. **负载均衡**:RebalanceService 线程根据队列数量和消费者个数做负载均衡,将分配到的队列发布 pullRequest 到 pullRequestQueue
2. **消息拉取**:PullMessageService 线程不断从 pullRequestQueue 获取 pullRequest,从 Broker 拉取消息并缓存到 ProcessQueue
3. **消息消费**:ConsumeMessageService 线程从 ProcessQueue 获取消息,调用监听器处理业务逻辑
4. **位点提交**:消费完成后自动提交消费位点
5. **流控保护**:拉取前检查缓存阈值(1000 消息或 100M),超过则延迟拉取
### SimpleConsumer
SimpleConsumer 是一种接口原子型的消费者类型,消息的获取、消费状态提交以及消费重试都是通过消费者业务逻辑主动发起调用完成。
**消息不可见时间(Invisible Time):**
SimpleConsumer 的核心机制是 **消息不可见时间**。当消费者获取消息后,该消息在指定的不可见时间内对其他消费者不可见。如果在不可见时间内完成消费并提交 ACK,消息被标记为已消费;如果超时未提交 ACK,消息会重新变为可见状态,可被其他消费者获取。这与 PushConsumer 的定时重试队列机制不同,SimpleConsumer 通过动态修改不可见时间来实现更灵活的重试控制。
一个来自官网的例子:
```java
// 消费示例:使用 SimpleConsumer 消费普通消息,主动获取消息处理并提交。
ClientServiceProvider provider = ClientServiceProvider.loadService();
String topic = "YourTopic";
FilterExpression filterExpression = new FilterExpression("YourFilterTag", FilterExpressionType.TAG);
SimpleConsumer simpleConsumer = provider.newSimpleConsumerBuilder()
// 设置消费者分组。
.setConsumerGroup("YourConsumerGroup")
// 设置接入点。
.setClientConfiguration(ClientConfiguration.newBuilder().setEndpoints("YourEndpoint").build())
// 设置预绑定的订阅关系。
.setSubscriptionExpressions(Collections.singletonMap(topic, filterExpression))
// 设置从服务端接受消息的最大等待时间
.setAwaitDuration(Duration.ofSeconds(1))
.build();
try {
// SimpleConsumer 需要主动获取消息,并处理。
List messageViewList = simpleConsumer.receive(10, Duration.ofSeconds(30));
messageViewList.forEach(messageView -> {
System.out.println(messageView);
// 消费处理完成后,需要主动调用 ACK 提交消费结果。
try {
simpleConsumer.ack(messageView);
} catch (ClientException e) {
logger.error("Failed to ack message, messageId={}", messageView.getMessageId(), e);
}
});
} catch (ClientException e) {
// 如果遇到系统流控等原因造成拉取失败,需要重新发起获取消息请求。
logger.error("Failed to receive message", e);
}
```
SimpleConsumer 适用于以下场景:
- 消息处理时长不可控:如果消息处理时长无法预估,经常有长时间耗时的消息处理情况。建议使用 SimpleConsumer 消费类型,可以在消费时自定义消息的预估处理时长,若实际业务中预估的消息处理时长不符合预期,也可以通过接口提前修改。
- 需要异步化、批量消费等高级定制场景:SimpleConsumer 在 SDK 内部没有复杂的线程封装,完全由业务逻辑自由定制,可以实现异步分发、批量消费等高级定制场景。
- 需要自定义消费速率:SimpleConsumer 是由业务逻辑主动调用接口获取消息,因此可以自由调整获取消息的频率,自定义控制消费速率。
**SimpleConsumer 工作原理:**
1. **主动获取消息**:业务方调用 receive() 接口主动获取消息
2. **业务处理**:获取到的消息由业务方自行处理
3. **主动提交 ACK**:消费处理完成后,业务方主动调用 ack() 接口提交消费结果
4. **高可控性**:业务方可完全控制消息处理时机和消费速率
### PullConsumer(拉模式消费者)
**核心特点:**
Pull 模式下,**应用程序对消息的拉取过程参与度高,可控性强**,可以自主决定何时进行消息拉取,从什么位置 offset 拉取消息。
**与 Push 模式的对比:**
| 特性 | Push 模式 | Pull 模式 |
| -------------- | -------------------- | ---------------- |
| **控制权** | 客户端 SDK 自动拉取 | 应用程序主动拉取 |
| **可控性** | 可控性不足 | 可控性高 |
| **开发复杂度** | 简单,只需实现监听器 | 需要管理拉取过程 |
| **适用场景** | 消息处理可预估 | 需要精细控制拉取 |
**使用示例(DefaultMQPullConsumer):**
```java
@Test
public void testPullConsumer() throws Exception {
DefaultMQPullConsumer consumer = new DefaultMQPullConsumer("group1_pull");
consumer.setNamesrvAddr(this.nameServer);
String topic = "topic1";
consumer.start();
// 获取 Topic 对应的消息队列
Set messageQueues = consumer.fetchSubscribeMessageQueues(topic);
int maxNums = 10; // 每次拉取消息的最大数量
while (true) {
boolean found = false;
for (MessageQueue messageQueue : messageQueues) {
// 获取消费位置
long offset = consumer.fetchConsumeOffset(messageQueue, false);
// 拉取消息
PullResult pullResult = consumer.pull(messageQueue, "tag8", offset, maxNums);
switch (pullResult.getPullStatus()) {
case FOUND:
found = true;
List msgs = pullResult.getMsgFoundList();
System.out.println("收到消息,数量----" + msgs.size());
// 处理消息
for (MessageExt msg : msgs) {
System.out.println("处理消息——" + msg.getMsgId());
}
// 更新消费位置
long nextOffset = pullResult.getNextBeginOffset();
consumer.updateConsumeOffset(messageQueue, nextOffset);
break;
case NO_NEW_MSG:
System.out.println("没有新消息");
break;
case NO_MATCHED_MSG:
System.out.println("没有匹配的消息");
break;
case OFFSET_ILLEGAL:
System.err.println("offset 错误");
break;
}
}
if (!found) {
// 没有队列中有新消息,则暂停一会
TimeUnit.MILLISECONDS.sleep(5000);
}
}
}
```
**使用示例(DefaultLitePullConsumer - 推荐):**
```java
DefaultLitePullConsumer litePullConsumer =
new DefaultLitePullConsumer("lite_pull_consumer_test");
litePullConsumer.setConsumeFromWhere(ConsumeFromWhere.CONSUME_FROM_FIRST_OFFSET);
litePullConsumer.subscribe("TopicTest", "*");
litePullConsumer.start();
try {
while (running) {
// 应用程序主动调用 poll 方法拉取消息
List messageExts = litePullConsumer.poll();
System.out.printf("%s%n", messageExts);
}
} finally {
litePullConsumer.shutdown();
}
```
**适用场景:**
- **需要精细控制拉取时机**:可以根据业务需求自主决定何时拉取消息
- **需要控制消费速率**:可以灵活调整拉取频率
- **批量消费场景**:可以一次性拉取大量消息进行批量处理
- **特殊消费需求**:如需要从特定 offset 开始消费、需要暂停消费等
**Pull 模式工作原理:**
1. **负载均衡**:RebalanceService 线程发现消费快照发生变化时,启动消息拉取线程
2. **消息拉取**:PullTaskImpl 拉取到消息后,把消息放到 consumeRequestCache
3. **消息消费**:应用程序调用 poll 方法,不停地从 consumeRequestCache 拉取消息进行业务处理
### 三种消费者类型对比
| 对比项 | PushConsumer | SimpleConsumer | PullConsumer |
| -------------- | ------------------------------------------------------------------------ | ---------------------------------------------------- | -------------------------------------------------- |
| 接口方式 | 使用监听器回调接口返回消费结果,消费者仅允许在监听器范围内处理消费逻辑。 | 业务方自行实现消息处理,并主动调用接口返回消费结果。 | 业务方自行按队列拉取消息,并可选择性地提交消费结果 |
| 消费并发度管理 | 由 SDK 管理消费并发度。 | 由业务方消费逻辑自行管理消费线程。 | 由业务方消费逻辑自行管理消费线程。 |
| 负载均衡粒度 | 5.x SDK 默认是消息粒度,早期版本是队列粒度 | 5.x SDK 默认是消息粒度 | 队列粒度,吞吐攒批性能更好,但容易不均衡 |
| 接口灵活度 | 高度封装,不够灵活。 | 原子接口,可灵活自定义。 | 原子接口,可灵活自定义。 |
| 适用场景 | 适用于无自定义流程的业务消息开发场景。 | 适用于需要高度自定义业务流程的业务开发场景。 | 仅推荐在流处理框架场景下集成使用 |
**选择建议:**
- **普通场景**:优先使用 **PushConsumer**,开发简单,SDK 自动管理拉取和提交
- **消息处理时长不可控**:使用 **SimpleConsumer**,可以自定义处理时长
- **需要精细控制**:使用 **PullConsumer**,完全自主控制拉取过程
**注意**:生产环境中相同的 ConsumerGroup 下严禁混用 PullConsumer 和其他两种消费者,否则会导致消息消费异常。
## 消费者分组和生产者分组
### 生产者分组
RocketMQ 5.x 新版领域模型里,**生产者是轻量、匿名的运行实体**,一般不再需要像早期版本那样重点管理生产者分组(ProducerGroup)。不过在 3.x/4.x 客户端、Spring 生态或兼容模式里,仍可能看到 ProducerGroup 配置,迁移时不要简单删除,要按实际客户端版本确认。
### 消费者分组
消费者分组是多个消费行为一致的消费者的负载均衡分组。消费者分组不是具体实体而是一个逻辑资源。通过消费者分组实现消费性能的水平扩展以及高可用容灾。
**消费者组的核心作用:**
```mermaid
flowchart TB
subgraph ConsumerGroup["消费者组概念"]
direction TB
style ConsumerGroup fill:#F0F2F5,stroke:#E0E6ED,stroke-width:1.5px
subgraph Cluster["集群消费模式"]
direction TB
style Cluster fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
CG["消费者组"] --> C1["消费者1
消费队列1、2"]
CG --> C2["消费者2
消费队列3、4"]
CG --> C3["消费者3
空闲"]
Note1["任意一条消息
只需被消费组内
任意一个消费者处理"]
end
subgraph Broadcast["广播消费模式"]
direction TB
style Broadcast fill:#F5F7FA,stroke:#E0E6ED,stroke-width:1.5px
BG["消费者组"] --> B1["消费者1
消费所有消息"]
BG --> B2["消费者2
消费所有消息"]
BG --> B3["消费者3
消费所有消息"]
Note2["每条消息
推送给消费组
所有消费者"]
end
%% 优化:调整注释连线,避免跨子图渲染异常
C1 -.-> Note1
C2 -.-> Note1
C3 -.-> Note1
B1 -.-> Note2
B2 -.-> Note2
B3 -.-> Note2
end
classDef cg fill:#4CA497,color:#fff,rx:10,ry:10
classDef consumer fill:#E99151,color:#fff,rx:10,ry:10
classDef note fill:#00838F,color:#fff,rx:10,ry:10
class CG,BG cg
class C1,C2,C3,B1,B2,B3 consumer
class Note1,Note2 note
linkStyle default stroke-width:1.5px,opacity:0.8
```
消费者分组中的订阅关系、投递顺序性、消费重试策略是一致的。
- 订阅关系:Apache RocketMQ 以消费者分组的粒度管理订阅关系,实现订阅关系的管理和追溯。
- 投递顺序性:Apache RocketMQ 的服务端将消息投递给消费者消费时,支持顺序投递和并发投递,投递方式在消费者分组中统一配置。
- 消费重试策略: 消费者消费消息失败时的重试策略,包括重试次数、死信队列设置等。
RocketMQ 服务端 5.x 版本:上述消费者的消费行为从关联的消费者分组中统一获取,因此,同一分组内所有消费者的消费行为必然是一致的,客户端无需关注。
RocketMQ 服务端 3.x/4.x 历史版本:上述消费逻辑由消费者客户端接口定义,因此,您需要自己在消费者客户端设置时保证同一分组下的消费者的消费行为一致。(来自官方网站)
**两种消费模式对比:**
| 对比维度 | 集群消费模式 | 广播消费模式 |
| ------------ | ---------------------------------------------- | ------------------------------------ |
| **消息消费** | 任意一条消息只需被消费组内的任意一个消费者处理 | 每条消息推送给消费组所有消费者 |
| **扩缩容** | 可通过扩缩消费者数量来提升或降低消费能力 | 扩缩消费者数量无法提升或降低消费能力 |
| **适用场景** | 需要提升消费能力、避免重复消费 | 需要所有消费者都收到消息 |
## 如何解决顺序消费和重复消费?
其实,这些东西都是我在介绍消息队列带来的一些副作用的时候提到的,也就是说,这些问题不仅仅挂钩于 RocketMQ ,而是应该每个消息中间件都需要去解决的。
在上面我介绍 RocketMQ 的技术架构的时候我已经向你展示了 **它是如何保证高可用的** ,这里不涉及运维方面的搭建,如果你感兴趣可以自己去官网上照着例子搭建属于你自己的 RocketMQ 集群。
> 其实 Kafka 的架构基本和 RocketMQ 类似,只是早期 Kafka 依赖 ZooKeeper 管理元数据,而它的 **分区** 就相当于 RocketMQ 中的 **队列**。还有一些小细节不同会在后面提到。
>
> 补充:早期 Kafka 依赖 ZooKeeper 管理元数据,新版本已经引入 KRaft 模式。这里对比的是“分区/队列用于提升并行度”的架构思路,不应再简单认为 Kafka 一定依赖 ZooKeeper。
### 顺序消费
在上面的技术架构介绍中,我们已经知道了 **RocketMQ 在主题上是无序的、它只有在队列层面才是保证有序** 的。
这又扯到两个概念——**普通顺序** 和 **严格顺序** 。
所谓普通顺序是指 消费者通过 **同一个消费队列收到的消息是有顺序的** ,不同消息队列收到的消息则可能是无顺序的。普通顺序消息在 Broker **重启情况下不会保证消息顺序性** (短暂时间) 。
所谓严格顺序是指 消费者收到的 **所有消息** 均是有顺序的。严格顺序消息 **即使在异常情况下也会保证消息的顺序性** 。
但是,严格顺序看起来虽好,实现它可会付出巨大的代价。如果你使用严格顺序模式,Broker 集群中只要有一台机器不可用,则整个集群都不可用。你还用啥?现在主要场景也就在 `binlog` 同步。
一般而言,我们的 `MQ` 都是能容忍短暂的乱序,所以推荐使用普通顺序模式。
那么,我们现在使用了 **普通顺序模式** ,我们从上面学习知道了在 Producer 生产消息的时候会进行轮询(取决你的负载均衡策略)来向同一主题的不同消息队列发送消息。那么如果此时我有几个消息分别是同一个订单的创建、支付、发货,在轮询的策略下这 **三个消息会被发送到不同队列** ,因为在不同的队列此时就无法使用 RocketMQ 带来的队列有序特性来保证消息有序性了。
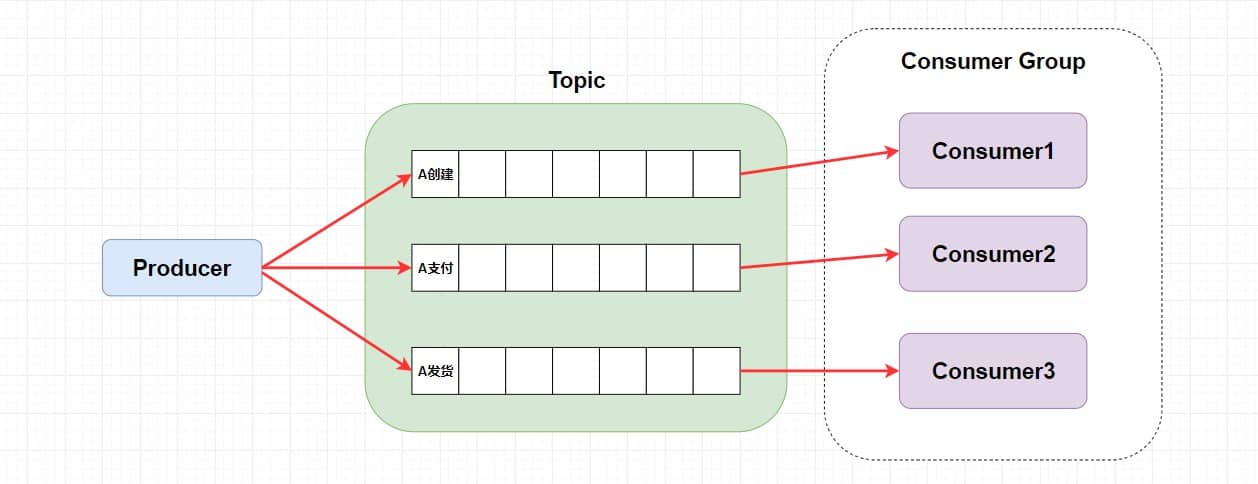
那么,怎么解决呢?
其实很简单,我们需要处理的仅仅是将同一语义下的消息放入同一个队列(比如这里是同一个订单),那我们就可以使用 **Hash 取模法** 来保证同一个订单在同一个队列中就行了。
**4.x 版本:使用 MessageQueueSelector**
RocketMQ 4.x 版本通过继承 `MessageQueueSelector` 来实现自定义队列选择逻辑:
```java
SendResult sendResult = producer.send(msg, new MessageQueueSelector() {
@Override
public MessageQueue select(List mqs, Message msg, Object arg) {
//根据订单ID等业务关键字计算队列索引
Long orderId = (Long) arg;
int index = Math.floorMod(Long.hashCode(orderId), mqs.size());
return mqs.get(index);
}
}, orderId);
```
**5.x 版本:使用消息组(MessageGroup)**
RocketMQ 5.x 版本引入了**消息组**的概念,通过设置消息组来保证同一组内消息的顺序性:
```java
Message message = messageBuilder.setTopic("topic")
.setTag("messageTag")
//设置顺序消息的排序分组
.setMessageGroup("fifoGroup001") // 比如使用订单ID作为消息组
.setBody("messageBody".getBytes())
.build();
```
**队列选择算法**
RocketMQ 实现了两种队列选择算法:
- **轮询算法**(默认):向消息指定的 topic 所在队列中依次发送消息,保证消息均匀分布
- **最小投递延迟算法**:每次消息投递的时候统计消息投递的延迟,选择队列时优先选择消息延时小的队列
```java
// 启用最小投递延迟算法
producer.setSendLatencyFaultEnable(true);
```
### 特殊情况处理
#### 发送异常
选择队列后会与 Broker 建立连接,通过网络请求将消息发送到 Broker 上,如果 Broker 挂了或者网络波动发送消息超时此时 RocketMQ 会进行重试。
重新选择其他 Broker 中的消息队列进行发送,默认重试两次,可以手动设置。
```java
producer.setRetryTimesWhenSendFailed(5);
```
#### 消息过大
这里要区分两个限制:客户端可以配置消息体超过某个阈值后压缩(例如 Java 4.x 客户端常见默认值是 4KB),而 RocketMQ 5.x 官方参数里默认最大消息体是 4MB,且这个大小不包含压缩后的额外效果。大文件不建议直接塞进消息体,通常把文件放到对象存储或文件系统里,MQ 里只传业务 ID 和文件地址。
### 重复消费
RocketMQ 和大多数消息队列一样,工程上通常按 **至少一次投递** 来设计:只要出现消费失败、超时、客户端重启、网络抖动等情况,同一条业务消息就可能再次投递。因此,解决重复消费的核心思路就是两个字—— **幂等** 。在编程中,一个*幂等*操作的特点是其任意多次执行所产生的影响均与一次执行的影响相同。比如说,这个时候我们有一个订单的处理积分的系统,每当来一个消息的时候它就负责为创建这个订单的用户的积分加上相应的数值。可是有一次,消息队列发送给订单系统 FrancisQ 的订单信息,其要求是给 FrancisQ 的积分加上 500。但是积分系统在收到 FrancisQ 的订单信息处理完成之后返回给消息队列处理成功的信息的时候出现了网络波动(当然还有很多种情况,比如 Broker 意外重启等等),这条回应没有发送成功。
那么,消息队列没收到积分系统的回应会不会尝试重发这个消息?问题就来了,我再发这个消息,万一它又给 FrancisQ 的账户加上 500 积分怎么办呢?
所以我们需要给我们的消费者实现 **幂等** ,也就是对同一个消息的处理结果,执行多少次都不变。
那么如何给业务实现幂等呢?这个还是需要结合具体的业务的。Redis 的 `SETNX` 可以做短期去重或弱幂等控制,但不要把它当成所有场景的唯一依据;订单、支付、库存这类强一致场景,更推荐使用 **数据库唯一键、幂等表或业务状态机** 来兜底,保证重复消息不会造成重复写入或重复扣减。
不过最主要的还是需要 **根据特定场景使用特定的解决方案** ,你要知道你的消息消费是否是完全不可重复消费还是可以忍受重复消费的,然后再选择强校验和弱校验的方式。毕竟在 CS 领域还是很少有技术银弹的说法。
RocketMQ 消费端幂等可以优先按业务唯一键设计,而不是只依赖消息 ID。比如订单支付消息用支付单号或订单号做唯一键,库存扣减消息用业务流水号做唯一键。这样即使消息重试、补偿或重新投递,只要业务唯一键不变,就能避免重复写入。
而在整个互联网领域,幂等不仅仅适用于消息队列的重复消费问题,这些实现幂等的方法,也同样适用于,**在其他场景中来解决重复请求或者重复调用的问题** 。比如将 HTTP 服务设计成幂等的,**解决前端或者 APP 重复提交表单数据的问题** ,也可以将一个微服务设计成幂等的,解决 RPC 框架自动重试导致的 **重复调用问题** 。
## RocketMQ 如何实现分布式事务?
如何解释分布式事务呢?事务大家都知道吧?**要么都执行要么都不执行** 。在同一个系统中我们可以轻松地实现事务,但是在分布式架构中,我们有很多服务是部署在不同系统之间的,而不同服务之间又需要进行调用。比如此时我下订单然后增加积分,如果保证不了分布式事务的话,就会出现 A 系统下了订单,但是 B 系统增加积分失败或者 A 系统没有下订单,B 系统却增加了积分。前者对用户不友好,后者对运营商不利,这是我们都不愿意见到的。
那么,如何去解决这个问题呢?
如今比较常见的分布式事务实现有 2PC、TCC 和事务消息(half 半消息机制)。每一种实现都有其特定的使用场景,但是也有各自的问题,**都不是完美的解决方案**。
在 RocketMQ 中使用的是 **事务消息加上事务反查机制** 来解决分布式事务问题的。我画了张图,大家可以对照着图进行理解。
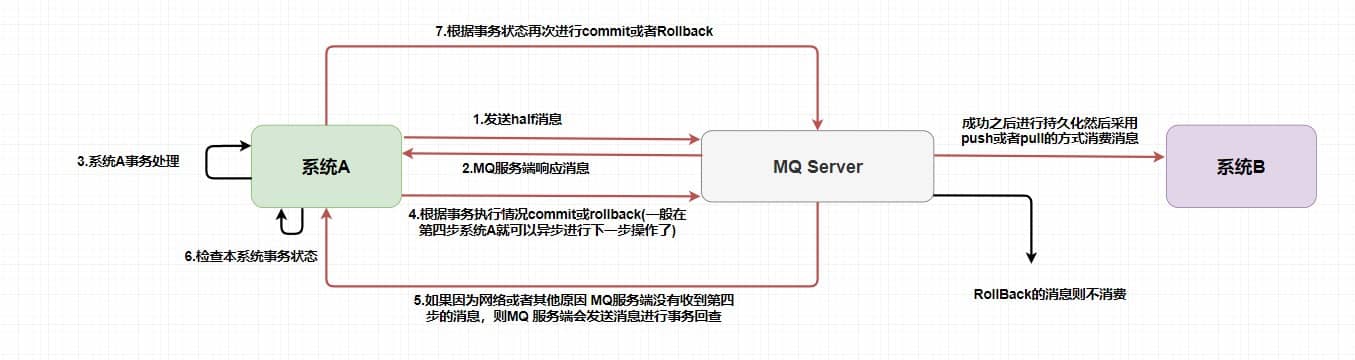
**事务消息处理流程详解**
1. **发送半事务消息**:生产者将消息发送至 RocketMQ 服务端
2. **服务端确认**:服务端将消息持久化成功之后,向生产者返回 Ack 确认消息已经发送成功,此时消息被标记为“暂不能投递”,这种状态下的消息即为**半事务消息**
3. **执行本地事务**:生产者开始执行本地事务逻辑
4. **提交二次确认**:生产者根据本地事务执行结果向服务端提交二次确认结果(Commit 或 Rollback)
5. **事务回查**:如果服务端未收到二次确认结果,或收到的结果为 Unknown,经过固定时间后,服务端将对消息生产者发起**消息回查**
6. **检查本地事务**:生产者收到消息回查后,需要检查对应消息的本地事务执行的最终结果
7. **再次提交确认**:生产者根据检查到的本地事务的最终状态再次提交二次确认
在第一步发送的 half 消息 ,它的意思是 **在事务提交之前,对于消费者来说,这个消息是不可见的** 。
> 那么,如何做到写入消息但是对用户不可见呢?RocketMQ 事务消息的做法是:如果消息是 half 消息,将备份原消息的主题与消息消费队列,然后 **改变主题** 为 RMQ_SYS_TRANS_HALF_TOPIC。由于消费组未订阅该主题,故消费端无法消费 half 类型的消息,**然后 RocketMQ 会开启一个定时任务,从 Topic 为 RMQ_SYS_TRANS_HALF_TOPIC 中拉取消息进行消费**,根据生产者组获取一个服务提供者发送回查事务状态请求,根据事务状态来决定是提交或回滚消息。
你可以试想一下,如果没有从第 5 步开始的 **事务回查机制** ,如果出现网路波动第 4 步没有发送成功,这样就会产生 MQ 不知道是不是需要给消费者消费的问题。在 RocketMQ 中就是使用的上述的事务回查来解决的,而在 Kafka 中通常是直接抛出一个异常让用户来自行解决。
你还需要注意的是,在 `MQ Server` 指向系统 B 的操作已经和系统 A 不相关了,也就是说在消息队列中的分布式事务是——**本地事务和存储消息到消息队列才是同一个事务**。这样也就产生了事务的**最终一致性**,因为整个过程是异步的,**每个系统只要保证它自己那一部分的事务就行了**。
实践中会遇到的问题:事务消息需要一个事务监听器来监听本地事务是否成功,并且事务监听器接口只允许被实现一次。那就意味着需要把各种事务消息的本地事务都写在一个接口方法里面,必将会产生大量的耦合和类型判断。采用函数 Function 接口来包装整个业务过程,作为一个参数传递到监听器的接口方法中。再调用 Function 的 apply() 方法来执行业务,事务也会在 apply() 方法中执行。让监听器与业务之间实现解耦,使之具备了真实生产环境中的可行性。
另外,事务回查时不要只查 Redis。事务最终状态应该以和本地事务同库提交的事务表、业务表状态为准,Redis 最多作为缓存或加速查询的副本。下面示例保留 Redis 写法是为了演示思路,生产环境要把本地事务状态落到可靠存储,并用业务唯一键或数据库约束保证消费端幂等。
1.模拟一个添加用户浏览记录的需求
```java
@PostMapping("/add")
@ApiOperation("添加用户浏览记录")
public Result add(Long userId, Long forecastLogId) {
// 函数式编程:浏览记录入库
Function function = transactionId -> viewHistoryHandler.addViewHistory(transactionId, userId, forecastLogId);
Map hashMap = new HashMap<>();
hashMap.put("userId", userId);
hashMap.put("forecastLogId", forecastLogId);
String jsonString = JSON.toJSONString(hashMap);
// 发送事务消息;将本地的事务操作,用函数Function接口接收,作为一个参数传入到方法中
TransactionSendResult transactionSendResult = mqProducerService.sendTransactionMessage(jsonString, MQDestination.TAG_ADD_VIEW_HISTORY, function);
return Result.success(transactionSendResult);
}
```
2.发送事务消息的方法
```java
/**
* 发送事务消息
*
* @param msgBody
* @param tag
* @param function
* @return
*/
public TransactionSendResult sendTransactionMessage(String msgBody, String tag, Function function) {
// 构建消息体
Message message = buildMessage(msgBody);
// 构建消息投递信息
String destination = buildDestination(tag);
TransactionSendResult result = rocketMQTemplate.sendMessageInTransaction(destination, message, function);
return result;
}
```
3.生产者消息监听器,只允许一个类去实现该监听器
```java
@Slf4j
@RocketMQTransactionListener
public class TransactionMsgListener implements RocketMQLocalTransactionListener {
@Autowired
private RedisService redisService; // 示例缓存,生产环境不要作为事务状态唯一来源
/**
* 执行本地事务(在发送消息成功时执行)
*
* @param message
* @param o
* @return commit or rollback or unknown
*/
@Override
public RocketMQLocalTransactionState executeLocalTransaction(Message message, Object o) {
// 1、获取事务ID
String transactionId = null;
try {
transactionId = message.getHeaders().get("rocketmq_TRANSACTION_ID").toString();
// 2、判断传入函数对象是否为空,如果为空代表没有要执行的业务直接抛弃消息
if (o == null) {
//返回ROLLBACK状态的消息会被丢弃
log.info("事务消息回滚,没有需要处理的业务 transactionId={}", transactionId);
return RocketMQLocalTransactionState.ROLLBACK;
}
// 将Object o转换成Function对象
Function function = (Function) o;
// 执行业务 事务也会在function.apply中执行
Boolean apply = function.apply(transactionId);
if (apply) {
log.info("事务提交,消息正常处理 transactionId={}", transactionId);
//返回COMMIT状态的消息会立即被消费者消费到
return RocketMQLocalTransactionState.COMMIT;
}
} catch (Exception e) {
log.info("出现异常 返回ROLLBACK transactionId={}", transactionId);
return RocketMQLocalTransactionState.ROLLBACK;
}
return RocketMQLocalTransactionState.ROLLBACK;
}
/**
* 事务回查机制,检查本地事务的状态
*
* @param message
* @return
*/
@Override
public RocketMQLocalTransactionState checkLocalTransaction(Message message) {
String transactionId = message.getHeaders().get("rocketmq_TRANSACTION_ID").toString();
// 示例里查 Redis;生产环境建议查询本地事务表或业务表最终状态
MqTransaction mqTransaction = redisService.getCacheObject("mqTransaction:" + transactionId);
if (Objects.isNull(mqTransaction)) {
return RocketMQLocalTransactionState.ROLLBACK;
}
return RocketMQLocalTransactionState.COMMIT;
}
}
```
4.模拟的业务场景,这里的方法必须提取出来,放在别的类里面.如果调用方与被调用方在同一个类中,会发生事务失效的问题.
```java
@Component
public class ViewHistoryHandler {
@Autowired
private IViewHistoryService viewHistoryService;
@Autowired
private IMqTransactionService mqTransactionService;
@Autowired
private RedisService redisService; // 示例缓存,事务状态仍应以数据库为准
/**
* 浏览记录入库
*
* @param transactionId
* @param userId
* @param forecastLogId
* @return
*/
@Transactional
public Boolean addViewHistory(String transactionId, Long userId, Long forecastLogId) {
// 构建浏览记录
ViewHistory viewHistory = new ViewHistory();
viewHistory.setUserId(userId);
viewHistory.setForecastLogId(forecastLogId);
viewHistory.setCreateTime(LocalDateTime.now());
boolean save = viewHistoryService.save(viewHistory);
// 本地事务信息
MqTransaction mqTransaction = new MqTransaction();
mqTransaction.setTransactionId(transactionId);
mqTransaction.setCreateTime(new Date());
mqTransaction.setStatus(MqTransaction.StatusEnum.VALID.getStatus());
// 事务状态应和本地业务数据在同一个事务中落库
mqTransactionService.save(mqTransaction);
// Redis 只能作为缓存副本,不能作为事务状态的唯一来源
redisService.setCacheObject("mqTransaction:" + transactionId, mqTransaction, 4L, TimeUnit.HOURS);
// 放开注释,模拟异常,事务回滚
// int i = 10 / 0;
return save;
}
}
```
5.消费消息,以及幂等处理
```java
@Service
@RocketMQMessageListener(topic = MQDestination.TOPIC, selectorExpression = MQDestination.TAG_ADD_VIEW_HISTORY, consumerGroup = MQDestination.TAG_ADD_VIEW_HISTORY)
public class ConsumerAddViewHistory implements RocketMQListener {
// 监听到消息就会执行此方法
@Override
public void onMessage(Message message) {
// 幂等校验
String transactionId = message.getTransactionId();
// 示例里查 Redis;强一致场景建议用业务唯一键、幂等表或数据库约束兜底
MqTransaction mqTransaction = redisService.getCacheObject("mqTransaction:" + transactionId);
// 不存在事务记录
if (Objects.isNull(mqTransaction)) {
return;
}
// 已消费
if (Objects.equals(mqTransaction.getStatus(), MqTransaction.StatusEnum.CONSUMED.getStatus())) {
return;
}
String msg = new String(message.getBody());
Map map = JSON.parseObject(msg, new TypeReference>() {
});
Long userId = map.get("userId");
Long forecastLogId = map.get("forecastLogId");
// 下游的业务处理
// TODO 记录用户喜好,更新用户画像
// TODO 更新'证券预测文章'的浏览量,重新计算文章的曝光排序
// 更新状态为已消费
mqTransaction.setUpdateTime(new Date());
mqTransaction.setStatus(MqTransaction.StatusEnum.CONSUMED.getStatus());
redisService.setCacheObject("mqTransaction:" + transactionId, mqTransaction, 4L, TimeUnit.HOURS);
log.info("监听到消息:msg={}", JSON.toJSONString(map));
}
}
```
## 如何解决消息堆积问题?
在上面我们提到了消息队列一个很重要的功能——**削峰** 。那么如果这个峰值太大了导致消息堆积在队列中怎么办呢?
其实这个问题可以将它广义化,因为产生消息堆积的根源其实就只有两个——生产者生产太快或者消费者消费太慢。
我们可以从多个角度去思考解决这个问题,当流量到峰值的时候是因为生产者生产太快,我们可以使用一些 **限流降级** 的方法,当然你也可以增加多个消费者实例去水平扩展增加消费能力来匹配生产的激增。如果消费者消费过慢的话,我们可以先检查 **是否是消费者出现了大量的消费错误** ,或者打印一下日志查看是否是哪一个线程卡死,出现了锁资源不释放等等的问题。
> 当然,最快速解决消息堆积问题的方法还是增加消费者实例,不过 **同时你还需要增加每个主题的队列数量** 。
>
> **注意**:在 RocketMQ 4.x 及之前的版本中,**一个队列只会被一个消费者消费**,如果你仅仅是增加消费者实例就会出现我一开始给你画架构图的那种情况(部分消费者没有队列可消费)。
>
> RocketMQ 5.x 的 PushConsumer 和 SimpleConsumer 默认使用**消息粒度负载均衡策略**,同一消费者分组内的多个消费者可以按照消息粒度共同消费同一个队列中的消息,因此即使消费者数量多于队列数量,仍能提升消费并行度。PullConsumer 仍是队列粒度,扩容时还是要关注队列数。
生产排查消息堆积时,可以按这个顺序来:
1. **先确认堆积范围**:是单个 Topic、单个队列,还是整个 Broker 都堆积。
2. **看生产速度和消费速度**:生产突增要限流或削峰,消费下降要查消费者。
3. **查消费者耗时**:重点看慢 SQL、外部接口、锁竞争、线程池和批量大小。
4. **看队列和消费者匹配关系**:4.x 和 PullConsumer 需要关注队列数是否限制了并发,5.x PushConsumer/SimpleConsumer 还要关注消息粒度负载均衡策略。
5. **做临时扩容和补偿**:必要时临时扩容消费者、增加队列、拆分 Topic,历史积压用批处理任务慢慢追。
不要只盯着“加消费者”。如果单队列顺序消费卡住,或者业务处理本身很慢,加消费者也不会明显改善。
## 什么是回溯消费?
回溯消费是指 Consumer 已经消费成功的消息,由于业务上需求需要重新消费,在 RocketMQ 中, Broker 在向 Consumer 投递成功消息后,**消息仍然需要保留** 。并且重新消费一般是按照时间维度,例如由于 Consumer 系统故障,恢复后需要重新消费 1 小时前的数据,那么 Broker 要提供一种机制,可以按照时间维度来回退消费进度。RocketMQ 支持按照时间回溯消费,时间维度精确到毫秒。
## RocketMQ 如何保证高性能读写
### 传统 IO 方式
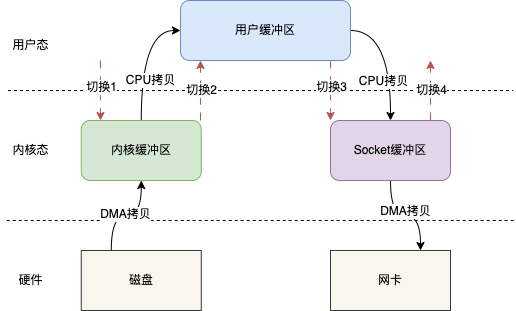
传统的 IO 读写其实就是 read + write 的操作,整个过程会分为如下几步
- 用户调用 read()方法,开始读取数据,此时发生一次上下文从用户态到内核态的切换,也就是图示的切换 1
- 将磁盘数据通过 DMA 拷贝到内核缓存区
- 将内核缓存区的数据拷贝到用户缓冲区,这样用户,也就是我们写的代码就能拿到文件的数据
- read()方法返回,此时就会从内核态切换到用户态,也就是图示的切换 2
- 当我们拿到数据之后,就可以调用 write()方法,此时上下文会从用户态切换到内核态,即图示切换 3
- CPU 将用户缓冲区的数据拷贝到 Socket 缓冲区
- 将 Socket 缓冲区数据拷贝至网卡
- write()方法返回,上下文重新从内核态切换到用户态,即图示切换 4
整个过程发生了 4 次上下文切换和 4 次数据的拷贝,这在高并发场景下肯定会严重影响读写性能故引入了零拷贝技术
### 零拷贝技术
#### mmap
mmap(memory map)是一种内存映射文件的方法,即将一个文件或者其它对象映射到进程的地址空间,实现文件磁盘地址和进程虚拟地址空间中一段虚拟地址的一一对映关系。
简单地说就是内核缓冲区和应用缓冲区共享,从而减少了从读缓冲区到用户缓冲区的一次 CPU 拷贝。基于此上述架构图可变为:
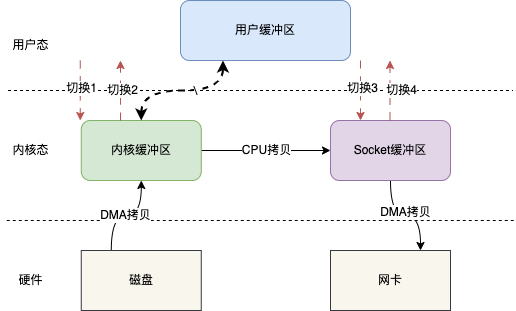
基于 mmap IO 读写其实就变成 mmap + write 的操作,也就是用 mmap 替代传统 IO 中的 read 操作。
当用户发起 mmap 调用时,内核主要是建立文件和进程虚拟地址空间的映射关系,并不会在这一步就把全部文件内容拷贝进内存。真正访问映射区域时,如果对应页还不在 Page Cache 中,才会触发缺页中断并把磁盘数据加载到内存;随后用户调用 write,仍需要把数据从内核缓冲区写到 Socket 缓冲区。
发生 4 次上下文切换和 3 次 IO 拷贝操作,在 Java 中的实现:
```java
FileChannel fileChannel = new RandomAccessFile("test.txt", "rw").getChannel();
MappedByteBuffer mappedByteBuffer = fileChannel.map(FileChannel.MapMode.READ_WRITE, 0, fileChannel.size());
```
#### sendfile
sendfile()跟 mmap()一样,也会减少一次 CPU 拷贝,但是它同时也会减少两次上下文切换。
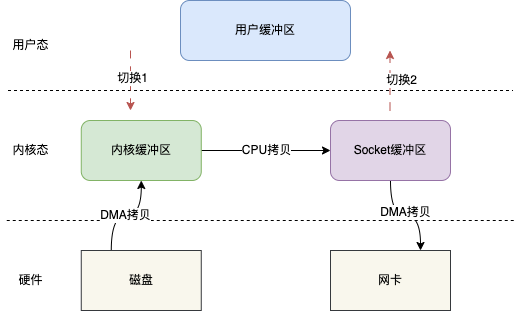
如图,用户在发起 sendfile()调用时会发生切换 1,之后数据通过 DMA 拷贝到内核缓冲区,再由内核把数据发送到 Socket 相关缓冲区,最后写入网卡,sendfile()返回,发生切换 2。不同操作系统和网卡能力下具体拷贝次数会有差异,但核心收益是减少用户态和内核态之间的数据拷贝与上下文切换。Java 也提供了相应 api:
```java
FileChannel channel = FileChannel.open(Paths.get("./test.txt"), StandardOpenOption.WRITE, StandardOpenOption.CREATE);
//调用transferTo方法向目标数据传输
channel.transferTo(position, len, target);
```
在如上代码中,并没有文件的读写操作,而是直接将文件的数据传输到 target 目标缓冲区,也就是说,sendfile 是无法知道文件的具体的数据的;但是 mmap 不一样,他是可以修改内核缓冲区的数据的。假设如果需要对文件的内容进行修改之后再传输,只有 mmap 可以满足。
通过上面的一些介绍,结论是基于零拷贝技术,可以减少 CPU 拷贝和上下文切换,从而提升文件读写和网络传输效率。
RocketMQ 快不只是因为 mmap。更关键的是 CommitLog 顺序追加写、Page Cache、ConsumeQueue 定长索引,以及刷盘和复制策略之间的取舍。mmap 主要降低文件读写路径上的额外拷贝和系统调用成本,是其中一个重要环节。
## RocketMQ 的刷盘机制
了解了 RocketMQ 的架构和设计原理后,接下来探讨几个核心问题:
- 在 Topic 中的 **队列是以什么样的形式存在的?**
- **队列中的消息又是如何进行存储持久化的呢?**
- **同步刷盘** 和 **异步刷盘** 是什么?它们会给持久化带来什么样的影响?
### 同步刷盘和异步刷盘
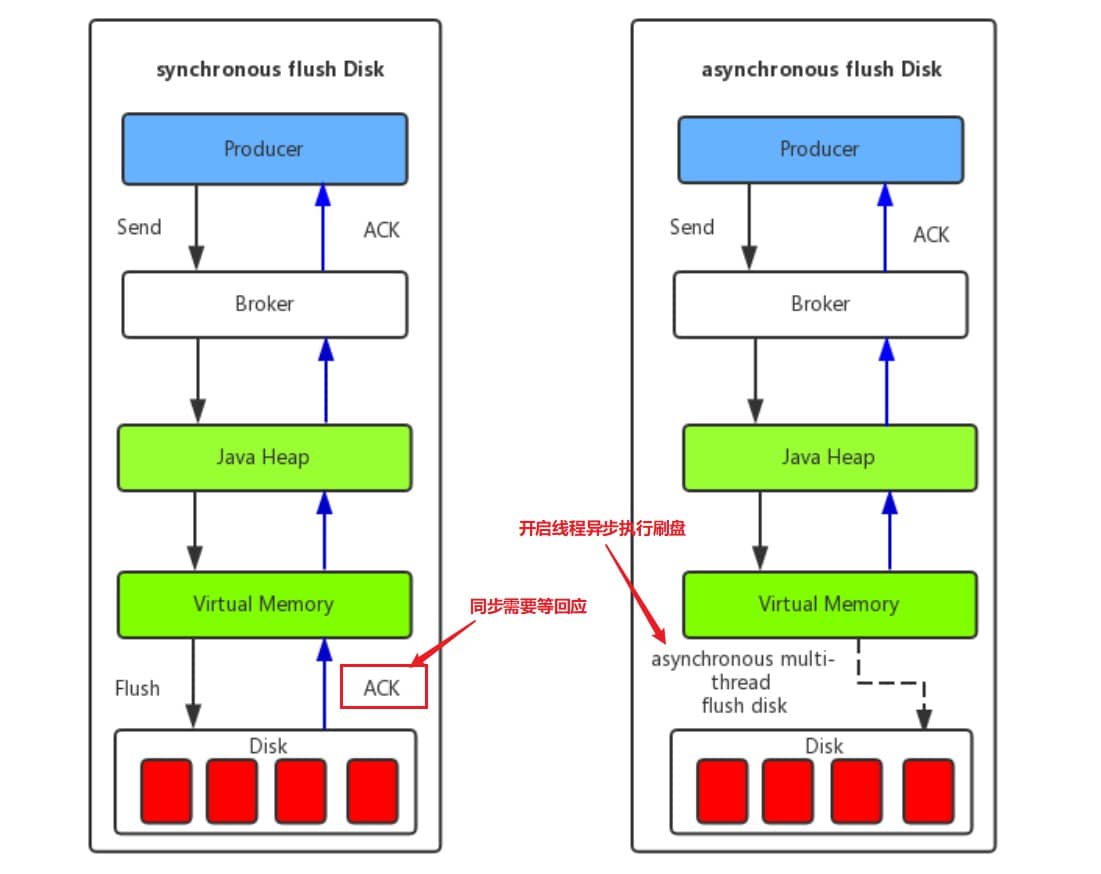
如上图所示,在同步刷盘中需要等待一个刷盘成功的 ACK ,同步刷盘对 `MQ` 消息可靠性来说是一种不错的保障,但是 **性能上会有较大影响** ,一般地适用于金融等特定业务场景。
而异步刷盘往往是开启一个线程去异步地执行刷盘操作。消息刷盘采用后台异步线程提交的方式进行, **降低了读写延迟** ,提高了 `MQ` 的性能和吞吐量,一般适用于如发验证码等对于消息保证要求不太高的业务场景。
一般地,**异步刷盘只有在 Broker 意外宕机的时候会丢失部分数据**,你可以设置 Broker 的参数 `FlushDiskType` 来调整你的刷盘策略(ASYNC_FLUSH 或者 SYNC_FLUSH)。
### 同步复制和异步复制
上面的同步刷盘和异步刷盘是在单个节点层面的,而同步复制和异步复制主要是指 `Broker` 主从模式下,主节点返回消息给客户端的时候是否需要同步从节点。
- 同步复制:也叫 “同步双写”,也就是说,**只有消息同步双写到主从节点上时才返回写入成功** 。
- 异步复制:**消息写入主节点之后就直接返回写入成功** 。
然而,很多事情是没有完美的方案的,就比如我们进行消息写入的节点越多就更能保证消息的可靠性,但是随之的性能也会下降,所以需要程序员根据特定业务场景去选择适应的主从复制方案。
那么,**异步复制会不会也像异步刷盘那样影响消息的可靠性呢?**
答案是会影响。刷盘策略决定消息是否落到本机磁盘,复制策略决定消息是否已经同步到副本。异步复制下,主节点返回成功时消息可能还没有复制到从节点;如果主节点此时宕机且数据无法恢复,从节点就可能缺少这部分消息。因此,要求更高可靠性时,通常会选择同步刷盘 + 同步复制,或者使用 DLedger 这类多数派复制方案。
比如采用异步复制时,主节点已经向生产者返回成功,但这部分消息还没来得及同步到从节点。如果主节点只是短暂不可用,恢复后仍可能继续补齐复制;如果主节点数据丢失或发生不可逆故障,从节点就可能永远少这部分消息。这里影响的不只是可用性,也包括可靠性。
在单主从架构中,如果一个主节点挂掉了,那么整个系统就不能再生产消息了。那么这个可用性的问题能否解决呢?**可以通过多主从架构来解决**,在最初的架构图中,每个 Topic 是分布在不同 Broker 中的。

但是这种复制方式同样也会带来一个问题,那就是无法保证 **严格顺序** 。在上文中我们提到了如何保证的消息顺序性是通过将一个语义的消息发送在同一个队列中,使用 Topic 下的队列来保证顺序性的。如果此时我们主节点 A 负责的是订单 A 的一系列语义消息,然后它挂了,这样其他节点是无法代替主节点 A 的,如果我们任意节点都可以存入任何消息,那就没有顺序性可言了。
而在 RocketMQ 中采用了 DLedger 解决这个问题。DLedger 要求在写入消息的时候,**至少消息复制到半数以上的节点之后**,才给客户端返回写入成功,并且支持通过选举来动态切换主节点。
> DLedger 也不是完美的方案:在选举过程中是无法提供服务的;必须使用三个节点或以上;如果多数节点同时挂掉也无法保证可用性;要求消息复制到半数以上节点的效率和直接异步复制还是有一定差距的。
### 存储机制
至此,刷盘和复制的问题已经解决了。
接下来讨论 **队列是以什么样的形式存在的?队列中的消息又是如何进行存储持久化的?** 这涉及到 RocketMQ 的存储结构设计。首先介绍 RocketMQ 消息存储架构中的三大角色——CommitLog、ConsumeQueue 和 IndexFile。
**存储架构三大组件:**
- **CommitLog**:**消息主体以及元数据的存储主体**,存储 Producer 端写入的消息主体内容,消息内容不是定长的。单个文件大小默认 **1G**,文件名长度为 20 位,左边补零,剩余为起始偏移量,比如 00000000000000000000 代表第一个文件,起始偏移量为 0;当第一个文件写满后,第二个文件为 00000000001073741824,起始偏移量为 1073741824,以此类推。消息主要是 **顺序写入日志文件**,当文件满了,写入下一个文件。
- **ConsumeQueue**:指定 Topic 下某个 MessageQueue 的物理索引文件,**引入的目的主要是提高消息消费的性能**。由于 RocketMQ 是基于 Topic 的订阅模式,如果要遍历 CommitLog 文件根据 Topic 和队列检索消息是非常低效的。ConsumeQueue 保存了消息在 CommitLog 中的 **起始物理偏移量 offset**、消息大小 size 和消息 Tag 的 HashCode 值。ConsumeQueue 文件夹的组织方式为:topic/queue/file 三层组织结构,具体存储路径为:`$HOME/store/consumequeue/{topic}/{queueId}/{fileName}`。ConsumeQueue 文件采取定长设计,每一个条目共 **20 个字节**(8 字节 commitlog 物理偏移量 + 4 字节消息长度 + 8 字节 tag hashcode),单个文件由 **30 万个条目** 组成,每个 ConsumeQueue 文件大小约 **5.72M**。
- **IndexFile**:索引文件,提供了一种可以通过 key 或时间区间来查询消息的方法。
总结来说,整个消息存储的结构,最主要的就是 `CommitLog` 和 ConsumeQueue。MessageQueue 是 Topic 下的逻辑队列,ConsumeQueue 是这个逻辑队列对应的物理索引文件,不要把两者完全等同。
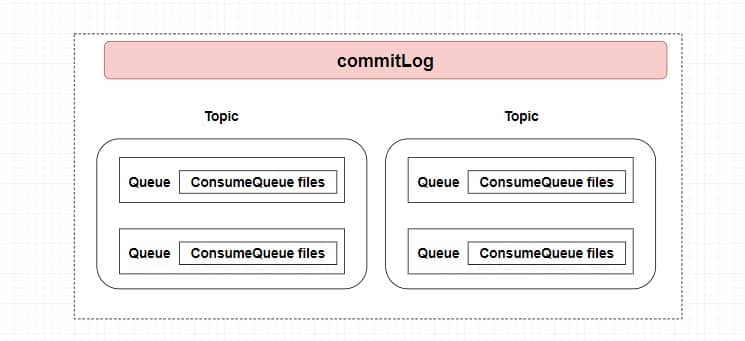
RocketMQ 采用的是 **混合型的存储结构** ,即 Broker 单个实例下所有的队列共用一个日志数据文件(CommitLog)来存储消息。而 Kafka 会为每个分区(Partition)分配一个独立的存储文件。
RocketMQ 这么做的原因是 **提高数据的写入效率** ,不分 Topic 意味着有更大的几率获取 **成批** 的消息进行顺序写入,但也带来一个问题:读取消息时如果遍历整个 CommitLog 文件,效率很低。
所以,RocketMQ 使用 ConsumeQueue 作为每个队列的索引文件来 **提升读取消息的效率**。可以直接根据队列的消息序号,计算出索引的全局位置(索引序号 × 索引固定长度 20),然后直接读取这条索引,再根据索引中记录的消息的全局位置找到消息。
下面结合架构图来理解存储结构:
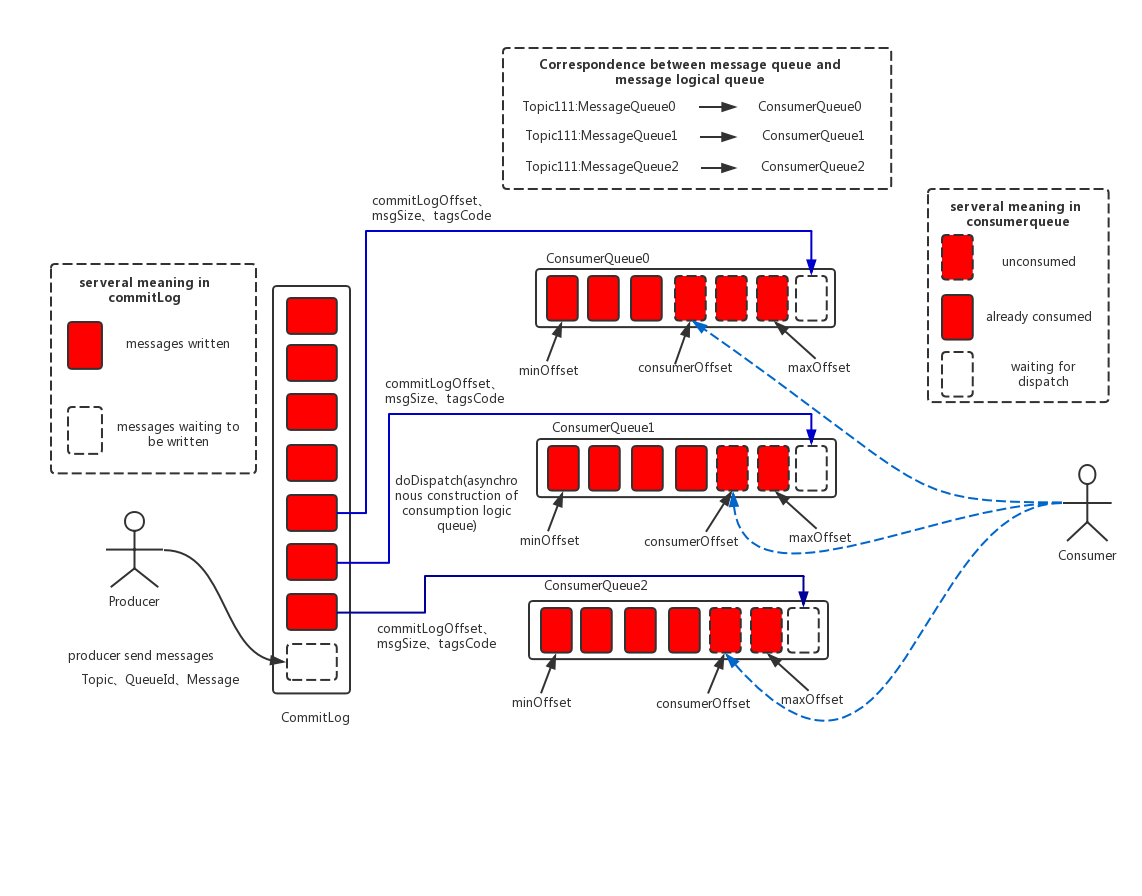
> 如果上面没看懂的读者一定要认真看下面的流程分析!
首先,在图的最上面可以把 `ConsumeQueue` 理解为某个 MessageQueue 的索引文件,而不是消息主体本身。
在图中最左边说明了红色方块代表被写入的消息,虚线方块代表等待被写入的消息。左边的生产者发送消息会指定 Topic、`QueueId` 和具体消息内容,而在 Broker 中不区分消息类型,直接 **全部顺序存储到 CommitLog**。根据生产者指定的 Topic 和 `QueueId`,将这条消息在 CommitLog 中的偏移量(offset)、消息大小和 tag 的 hash 值存入对应的 ConsumeQueue 索引文件中。
在每个队列中都保存了 `ConsumeOffset` 即每个消费者组的消费位置,消费者拉取消息进行消费时只需要根据 `ConsumeOffset` 获取下一个未被消费的消息即可。
以上就是 RocketMQ 存储架构的核心原理。
最后留一个思考题:**为什么 CommitLog 文件要设计成固定大小的长度呢?** 提示:与 **内存映射机制(mmap)** 有关。
## 总结
本文系统地介绍了 RocketMQ 的核心知识点,以下是关键内容回顾:
**消息队列核心价值**
- **异步**:提升系统响应速度,非核心流程异步化处理
- **解耦**:降低系统间耦合度,通过发布订阅模式实现松耦合
- **削峰**:缓解瞬时流量压力,保护下游系统不被冲垮
**RocketMQ 架构要点**
| 组件 | 核心职责 |
| -------------- | -------------------------------------------- |
| **NameServer** | 无状态注册中心,各节点互不通信,追求简单高效 |
| **Broker** | 消息存储与投递,支持主从架构和 DLedger 模式 |
| **Proxy** | 5.0 新增,计算与存储分离,支持 gRPC 协议 |
| **Producer** | 消息生产者,支持同步、异步、单向发送 |
| **Consumer** | 消息消费者,支持 Push、Pull、Simple 三种模式 |
**消息类型对比**
| 消息类型 | 适用场景 | 关键特性 |
| ------------ | -------------------- | ------------------------ |
| **普通消息** | 微服务解耦、事件驱动 | 无顺序要求,消息相互独立 |
| **顺序消息** | 订单处理、数据同步 | 同一消息组内严格有序 |
| **定时消息** | 延迟任务、超时处理 | 5.x 支持按时间戳设置投递 |
| **事务消息** | 分布式事务 | 半消息机制 + 事务回查 |
**5.x 版本核心升级**
- **消息粒度负载均衡**:5.x PushConsumer/SimpleConsumer 默认使用,缓解队列粒度负载不均
- **计算与存储分离**:Proxy 组件承担协议适配和计算逻辑,Broker 专注存储
- **定时消息增强**:不再只受限于固定延迟等级,可按毫秒级时间戳设置投递时间,默认粒度为秒级
- **gRPC 多语言 SDK**:降低多语言客户端接入成本,更适合云原生和多协议场景
**高性能设计**
- **顺序写**:CommitLog 采用顺序写入,充分利用磁盘顺序 IO 的高性能
- **零拷贝**:结合 mmap、Page Cache 等机制,减少数据拷贝和系统调用成本
- **索引设计**:ConsumeQueue 作为消息索引,避免遍历 CommitLog
**可靠性保障**
- **刷盘策略**:同步刷盘提升本机持久化可靠性,异步刷盘提升性能
- **主从复制**:同步复制提升副本可靠性,异步复制提升吞吐但可能丢失未复制消息
- **DLedger**:基于 Raft 协议实现自动主从切换,提升高可用能力