> [!NOTE] > 本文档由 WeHub 基于上游 README 翻译整理,属于社区翻译,非官方中文文档。 > [English](./README.en.md) · [原始项目](https://github.com/NevaMind-AI/memU) · [上游 README](https://github.com/NevaMind-AI/memU/blob/HEAD/README.md) > 原作者、版权与许可证归属以原始项目及本仓库 LICENSE 文件为准。 ![MemU Banner](assets/banner.png)
# memU ### 个人记忆,以文件形式存储 **快速检索。更高准确度。更低成本。** [![PyPI version](https://badge.fury.io/py/memu-py.svg)](https://badge.fury.io/py/memu-py) [![License: Apache 2.0](https://img.shields.io/badge/License-Apache%202.0-blue.svg)](https://opensource.org/licenses/Apache-2.0) [![Python 3.13+](https://img.shields.io/badge/python-3.13+-blue.svg)](https://www.python.org/downloads/) [![Discord](https://img.shields.io/badge/Discord-Join%20Chat-5865F2?logo=discord&logoColor=white)](https://discord.com/invite/hQZntfGsbJ) [![Twitter](https://img.shields.io/badge/Twitter-Follow-1DA1F2?logo=x&logoColor=white)](https://x.com/memU_ai) NevaMind-AI%2FmemU | Trendshift **[English](readme/README_en.md) | [中文](readme/README_zh.md) | [日本語](readme/README_ja.md) | [한국어](readme/README_ko.md) | [Español](readme/README_es.md) | [Français](readme/README_fr.md)**
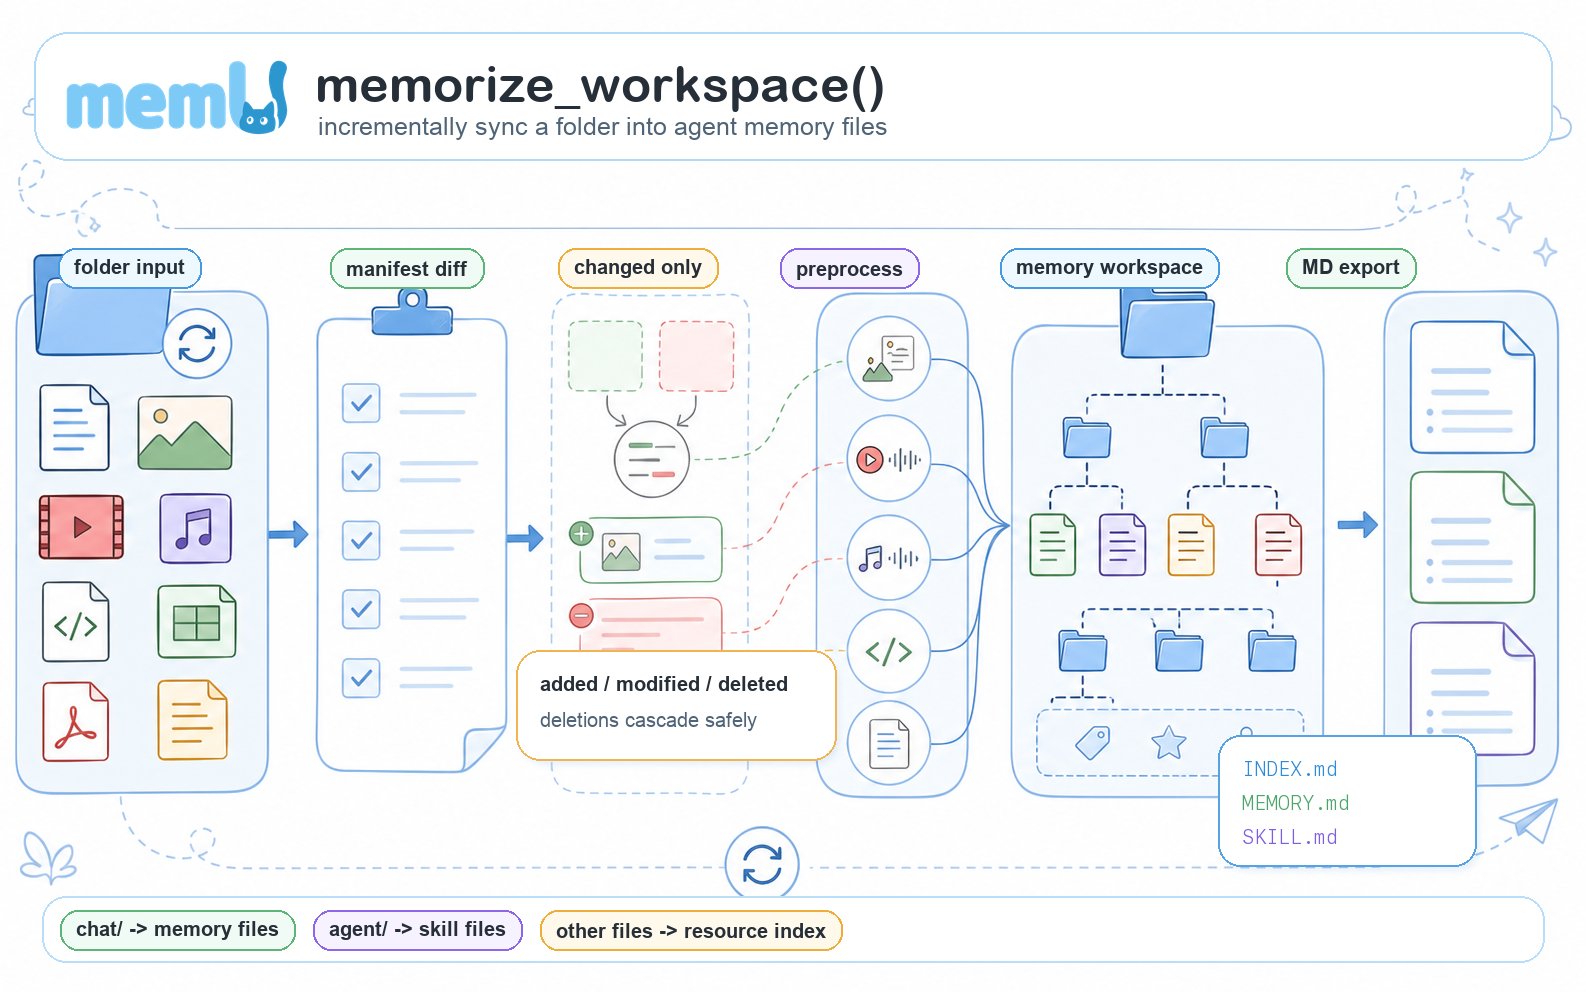
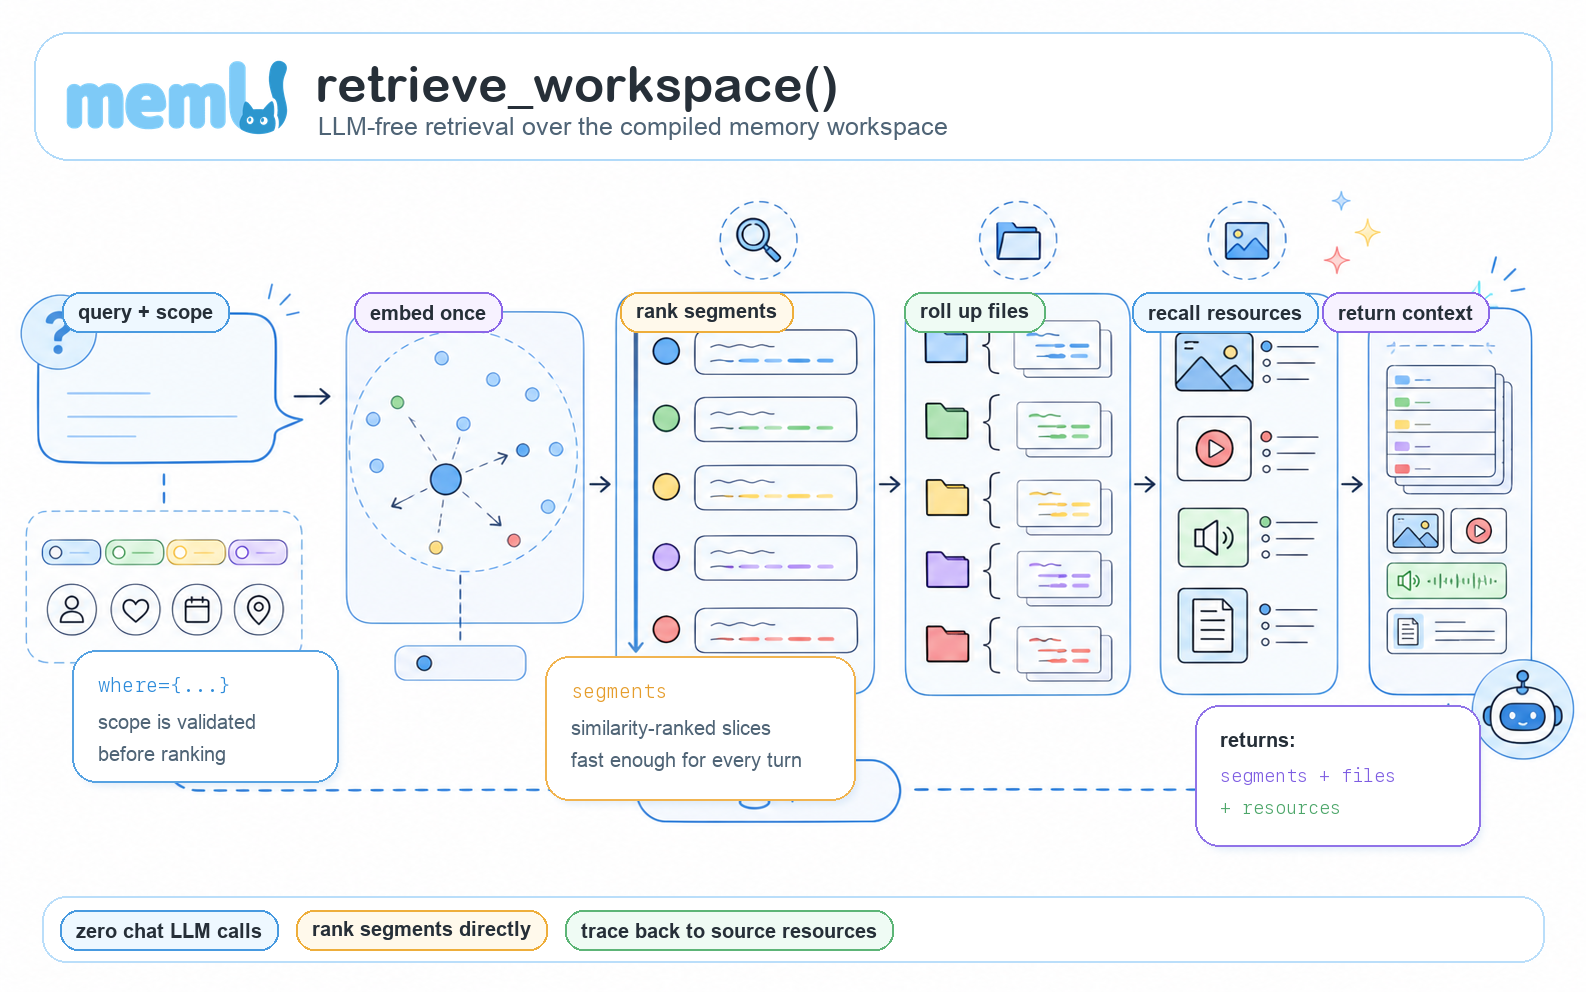
--- > [!WARNING] > 🚧 **正在大力建设中** — memU 正在进行重大改版。API、CLI 命令和文档可能随时变更。预计将于 **2026 年 7 月 15 日** 左右趋于稳定。 > 🤖 **Agents**:阅读 [`.claude/skills/memu/SKILL.md`](.claude/skills/memu/SKILL.md),即可立即 `memorize-workspace` 和 `retrieve-workspace`。 memU 将对话、文档、代码、图片、音频、视频、URL 和工具轨迹编译为人类可读的 Markdown 文件(`INDEX.md`、`MEMORY.md`、`SKILL.md`)。Agent 遍历该树状结构,仅加载当前时刻所需内容 — 而非每次都重新扫描一切,或将冗长历史塞入每条提示词。 ```python await service.memorize_workspace(folder="./workspace") context = await service.retrieve_workspace("What should I know about this user's launch preferences?") ``` 或者直接在终端操作 — 无需编写代码: ```bash npx memu-cli memorize-workspace ./workspace npx memu-cli retrieve-workspace "What should I know about this user's launch preferences?" ``` 就是这样。Agent 不再依赖关于某人或其工作区的一整块巨型提示词,而是获得三个可遍历的持久层: ```txt workspace/ ├── INDEX.md ← Index: a map of everything — raw sources and summaries ├── MEMORY.md ← Memory: an overview that links into memory/ ├── SKILL.md ← Skill: an overview that links into skill/ ├── resource/ ← the raw source files, copied verbatim ├── memory/ │ └── .md ← one memory file per topic: facts, preferences, goals, events └── skill/ └── .md ← one skill file per learned pattern, workflow, or mistake to avoid ``` - **Index(`INDEX.md`)** — 记忆的地图:有哪些内容、来自何处、以及应优先查看哪里 - **Memory(`MEMORY.md`)** — 从源数据中提取的个人事实、偏好、目标、事件和决策 - **Skill(`SKILL.md`)** — **从 agent 轨迹中自动提取,并在每次工作区同步时持续精炼**,使 agent 在重复任务上不断改进 当你使用 `memorize_workspace` 同步文件夹时,顶层目录决定处理方式:``chat/`` 下的文件成为 memory,``agent/`` 下的文件成为 skills,其余一切则作为工作区上下文编入索引。 以下三点使其有别于将所有内容塞入提示词: - **快速检索** — 定位到正确文件夹并排序相关文件,而非每次都扫描全部内容。 - **更高准确度** — 按用户、任务或会话限定范围,并将每一项追溯至其来源的确切对话、文档、图片或日志。 - **更低成本** — 检索紧凑、限定范围的上下文,而非在每条提示词中反复注入冗长历史、文档、日志及媒体衍生文本。 - **可供你检视** — 人类可读的文件树,你可审计、编辑、限定范围,并通过自有存储(`inmemory`、`sqlite`、`postgres`)和 LLM 提供商进行路由。 --- ## ⭐️ Star the repository 如果你觉得 memU 有用或有趣,欢迎点个 GitHub Star ⭐️。 --- ## ✨ Core Features | Capability | Description | |------------|-------------| | 🗂️ **Multimodal Ingestion** | 将对话、文档、图片、视频、音频、URL、日志和本地文件写入记忆 | | 📁 **Compiled Memory Workspace** | 持久化 Index、Skill 和 Memory 层 — 文件夹(categories)、文件(items)、源工件、链接、摘要和嵌入 | | 🧠 **Typed Memory Extraction** | 从原始源中提取 profile、event、knowledge、behavior、skill 和 tool 记忆 | | 🛠️ **Self-Evolving Skills** | 从 agent 轨迹中自动提取可复用的工具模式与工作流,并在每次工作区同步时合并精炼,而非重新学习 | | 🧭 **Self-Organizing Folders** | 自动构建 categories、链接、摘要和嵌入,无需手动打标签 | | 🤖 **Agent-Ready Retrieval** | 无需 LLM 的 `retrieve_workspace()` 直接对记忆片段、文件和源资源进行排序 | | 🔄 **Incremental Workspace Sync** | `memorize_workspace()` 将文件夹与 manifest 进行 diff — 仅(重新)处理已变更文件,删除操作级联生效 | | 🧱 **Pluggable Storage** | 使用内存、SQLite 或 Postgres 后端,共享同一套 repository 契约 | | 🔀 **Profile-Based LLM Routing** | 通过可配置的 LLM profiles 路由聊天、嵌入、视觉和转录任务 | | ⌨️ **CLI** | `memu` 命令(pip)和 `npx memu-cli`(npm)— 在终端或 CI 中记忆与检索 | --- ## 🎯 Use Cases 每个用例都遵循同一循环:将源文件放入文件夹,用 `memorize_workspace()` 同步,再用 `retrieve_workspace()` 查询。同步是增量的(仅重新处理已变更文件),顶层目录决定处理方式 — ``chat/`` → memory topics,``agent/`` → skills,其余一切 → 编入索引的上下文。 ### 1. **Personal Memory** *将聊天记录转化为用户偏好、目标、事件、决策和关系上下文。* ```python # workspace/chat/*.json — conversation logs become memory topic files await service.memorize_workspace(folder="./workspace") context = await service.retrieve_workspace("What should I remember about this user?") ``` ### 2. **Workspace Context for Coding Agents** *将文档、PR 备注、日志和设计决策转化为可复用的项目记忆。* ```python # docs, notes, and logs anywhere in the folder are captioned and indexed await service.memorize_workspace(folder="./workspace") context = await service.retrieve_workspace("How should I structure this module?") ``` ### 3. **Multimodal Knowledge Layer** *从文档、截图、图片、视频和音频笔记中提取可搜索的事实。* ```python # modality is inferred per file: .pdf/.docx/.pptx/.xlsx/.html (via MarkItDown — # pip install 'memu-py[document]'), .png/.jpg, .mp3/.wav, .mp4/.mov, ... await service.memorize_workspace(folder="./workspace") context = await service.retrieve_workspace("What matters for the next research plan?") ``` ### 4. **Tool and Agent Learning** *将执行轨迹转化为 skills,告知未来的 agent 哪些做法有效、哪些应当避免。* ```python # workspace/agent/*.txt — execution traces are distilled into skill files await service.memorize_workspace(folder="./workspace") context = await service.retrieve_workspace("Which tools worked for config editing?") ``` --- ## 🗂️ Architecture 编译后的工作区可从两个方向理解: - `memorize_workspace()` 将文件夹写入持久的 memory 文件、skill 文件、resource 记录、segments、links 和 embeddings。 - `retrieve_workspace()` 直接读取这些层,优先对 segments 排序,再将结果汇总至 agent 应加载的文件与 resources。 记忆以三种表示层存储: | Layer | What it holds | Retrieval Role | |-------|---------------|----------------| | **File**(`RecallFile`) | 合成的 memory topic 或 skill 文档 | 返回给 agent 的单位 — 命中的 segments 汇总至其所属 file | | **Segment** | 文件的细粒度切片(段落行、skill 描述) | 嵌入搜索单位 — 查询优先对 segments 排序 | | **Resource** | 带来源说明的原始源工件 | 当合成摘要不足时,召回原始上下文 | `retrieve_workspace()` 将查询嵌入一次,按相似度对片段与资源排序,并返回紧凑上下文,全程零次对话 LLM(chat-LLM)调用。 运行时视角请参阅 [docs/architecture.md](docs/architecture.md)(了解 `MemoryService`、工作流流水线、存储后端与 LLM 路由),分层设计背后的决策记录请参阅 [docs/adr/](docs/adr/README.md)。 --- ## 🧰 Agent Skills 本仓库内置一个 [Agent Skill](https://docs.claude.com/en/docs/agents-and-tools/agent-skills) — [`.claude/skills/memu/SKILL.md`](.claude/skills/memu/SKILL.md) — 为 Claude Code(及任何兼容 Skills 的 agent)提供工作区配对能力。agent 自行决定何时使用各方向: - **memorize**(`memu memorize-workspace`)—「记住这个」「把这个文件夹同步到记忆」「完成值得持久化的工作」 - **retrieve**(`memu retrieve-workspace`)—「我们对……了解什么」「开始一项可能有既有上下文的任务」 在本仓库内开箱即用。若要在自己的项目中使用,将 skill 文件夹复制到该项目的 `.claude/skills/`(或 `~/.claude/skills/` 以全局启用): ```bash cp -r .claude/skills/memu /path/to/your-project/.claude/skills/ ``` 该 skill 会自动定位 CLI(`memu`、`uvx --from memu-py memu` 或 `npx memu-cli`),并将状态保存在项目本地的 `./data/memu.sqlite3` 中,因此一个会话中记忆的内容可在下一个会话中检索。对于 LangGraph agent,请参阅 [LangGraph integration](docs/langgraph_integration.md)。 --- ## 🚀 Quick Start ### Option 1: Cloud Version 👉 **[memu.so](https://memu.so)** — 托管式 API,提供托管摄取、结构化记忆与检索 企业部署请联系:**info@nevamind.ai** #### Cloud API (v3) | Base URL | `https://api.memu.so` | |----------|----------------------| | Auth | `Authorization: Bearer ` | | Method | Endpoint | Description | |--------|----------|-------------| | `POST` | `/api/v3/memory/memorize` | 摄取原始数据并构建结构化记忆 | | `GET` | `/api/v3/memory/memorize/status/{task_id}` | 检查处理状态 | | `POST` | `/api/v3/memory/categories` | 列出自动生成的类别 | | `POST` | `/api/v3/memory/retrieve` | 查询记忆以获取 agent 上下文 | 📚 **[Full API Documentation](https://memu.pro/docs#cloud-version)** --- ### Option 2: Self-Hosted #### Installation 从本仓库克隆安装: ```bash uv sync # or, for the full development setup: make install ``` 也可安装已发布的包: ```bash pip install memu-py # library + `memu` CLI # or from the JS ecosystem (thin launcher over memu-py, uses uvx/pipx automatically): npx memu-cli --help ``` > **Requirements**: Python 3.13+。默认示例使用 OpenAI,请设置 `OPENAI_API_KEY`,或通过 `llm_profiles` 传入其他提供商。 #### Command line `memu` 命令封装了与库相同的服务。状态持久化在本地 SQLite 数据库(默认 `./data/memu.sqlite3`)中,因此可在一次调用中记忆、在下次调用中检索: ```bash export OPENAI_API_KEY=your_key memu memorize-workspace ./workspace # diff-sync a folder (alias: memu sync) memu retrieve-workspace "deploy checklist" # LLM-free embedding retrieval (alias: memu search) memu export # rebuild the INDEX.md/MEMORY.md/SKILL.md tree ``` 每个标志都有对应的 `MEMU_*` 环境变量(`--provider`/`MEMU_LLM_PROVIDER`、`--model`/`MEMU_CHAT_MODEL`、`--db`/`MEMU_DB`,……)— 运行 `memu --help` 查看完整列表。`--db` 接受 SQLite 路径、`postgres://` DSN 或 `:memory:`。 **运行内存模式冒烟脚本:** ```bash export OPENAI_API_KEY=your_key cd tests uv run python test_inmemory.py ``` **使用 PostgreSQL + pgvector 运行:** ```bash uv sync --extra postgres docker run -d --name memu-postgres \ -e POSTGRES_USER=postgres \ -e POSTGRES_PASSWORD=postgres \ -e POSTGRES_DB=memu \ -p 5432:5432 \ pgvector/pgvector:pg16 export OPENAI_API_KEY=your_key export POSTGRES_DSN=postgresql+psycopg://postgres:postgres@127.0.0.1:5432/memu cd tests uv run python test_postgres.py ``` --- ### Custom LLM and Embedding Providers ```python from memu import MemoryService service = MemoryService( llm_profiles={ "default": { "base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1", "api_key": "your_key", "chat_model": "qwen3-max", "client_backend": "sdk" }, "embedding": { "base_url": "https://api.voyageai.com/v1", "api_key": "your_key", "embed_model": "voyage-3.5-lite" } }, ) ``` --- ### OpenRouter Integration ```python from memu import MemoryService service = MemoryService( llm_profiles={ "default": { "provider": "openrouter", "client_backend": "httpx", "base_url": "https://openrouter.ai", "api_key": "your_key", "chat_model": "anthropic/claude-3.5-sonnet", "embed_model": "openai/text-embedding-3-small", }, }, database_config={"metadata_store": {"provider": "inmemory"}}, ) ``` --- ## 📖 Core APIs 主要 API 配对为 `memorize_workspace()` / `retrieve_workspace()` — 文件夹输入,排序后的上下文输出。 ### `memorize_workspace()` — Sync a Folder memorize_workspace ```python result = await service.memorize_workspace( folder="./workspace", # scanned recursively; modality inferred per file user={"user_id": "123"}, # optional scope ) # Returns the diff plus what changed: # { "added": [...], "modified": [...], "deleted": [...], # "resources": [...], "entries": [...], "files": [...] } ``` - 将文件夹与旁路 `.memu_manifest.json` 进行 diff — 仅处理新增/修改的文件,已删除文件对应的记忆会级联移除 - 按顶层目录路由:`chat/` → 记忆文件,`agent/` → skill 文件,其余 → 已索引的工作区上下文 - 当 `memory_files_config.enabled=True` 时重建 markdown 记忆树(`INDEX.md` / `MEMORY.md` / `SKILL.md`) --- ### `retrieve_workspace()` — Fast, LLM-Free Retrieval retrieve_workspace ```python result = await service.retrieve_workspace( "deploy checklist", where={"user_id": "123"}, ) # Returns: # { "segments": [...], # embedded slices ranked by similarity # "files": [...], # the memory/skill files those segments roll up to # "resources": [...] } # workspace resources ranked by similarity ``` 查询仅嵌入一次,按向量相似度排序 — 无意图路由、无查询改写、无充分性检查、零次 LLM 调用。适用于高频查询场景,此时延迟与成本比深度推理更重要。 --- ## 💡 Example Workflows ### Always-Learning Assistant ```bash export OPENAI_API_KEY=your_key uv run python examples/example_1_conversation_memory.py ``` 自动提取偏好、构建关系模型,并在后续对话中呈现相关上下文。 ### Self-Improving Agent ```bash uv run python examples/example_2_skill_extraction.py ``` 监控 agent 行为,识别成功与失败中的模式,并从经验中自动生成 skill 指南。 ### Multimodal Context Builder ```bash uv run python examples/example_3_multimodal_memory.py ``` 自动将文本、图像与文档交叉引用,汇入统一的记忆层。 --- ## 📊 Performance memU 在所有推理任务上的 Locomo 基准测试中达到 **92.09% 平均准确率**。 benchmark 查看详细结果:[memU-experiment](https://github.com/NevaMind-AI/memU-experiment) --- ## 🧩 Ecosystem | Repository | Description | |------------|-------------| | **[memU](https://github.com/NevaMind-AI/memU)** | 个人记忆即文件 — 快速检索、更高准确率、更低成本 | | **[memU-server](https://github.com/NevaMind-AI/memU-server)** | 支持实时同步与 webhook 触发的后端 | | **[memU-ui](https://github.com/NevaMind-AI/memU-ui)** | 用于浏览与监控记忆的可视化仪表盘 | **快速链接:** - 🚀 [试用 MemU Cloud](https://app.memu.so/quick-start) - 📚 [API 文档](https://memu.pro/docs) - 💬 [Discord 社区](https://discord.com/invite/hQZntfGsbJ) --- ## 🤝 合作伙伴
Ten OpenAgents Milvus xRoute Jazz Buddie Bytebase LazyLLM Clawdchat
--- ## 🤝 参与贡献 ```bash # Fork and clone git clone https://github.com/YOUR_USERNAME/memU.git cd memU # Install dev dependencies make install # Run quality checks before submitting make check ``` 完整指南请参阅 [CONTRIBUTING.md](CONTRIBUTING.md)。 **前置要求:** Python 3.13+、[uv](https://github.com/astral-sh/uv), Git --- ## 📄 许可证 [Apache License 2.0](LICENSE.txt) --- ## 🌍 社区 - **GitHub Issues**: [报告 Bug 并提交功能请求](https://github.com/NevaMind-AI/memU/issues) - **Discord**: [加入社区](https://discord.com/invite/hQZntfGsbJ) - **X (Twitter)**: [关注 @memU_ai](https://x.com/memU_ai) - **联系方式**: info@nevamind.ai ---
⭐ **在 GitHub 上给我们 Star**,以便及时获知新版本发布!