# AI 代理投入生產:可觀測性與評估
[](https://youtu.be/l4TP6IyJxmQ?si=reGOyeqjxFevyDq9)
當 AI 代理從實驗性原型轉向現實世界的應用時,理解其行為、監控它們的效能並系統性地評估其輸出變得非常重要。
## Learning Goals
完成本課後,你將知道如何/理解:
- 代理可觀測性與評估的核心概念
- 改進代理效能、成本與效用的技術
- 如何系統性地評估你的 AI 代理以及應評估的項目
- 在將 AI 代理部署到生產環境時如何控制成本
- 如何對使用 Microsoft Agent Framework 構建的代理進行埋點(instrument)
目標是讓你具備將「黑盒」代理轉變為透明、可管理且可靠系統的知識。
_**注意:** 部署安全且值得信賴的 AI 代理非常重要。也可參考 [建立值得信賴的 AI 代理](./06-building-trustworthy-agents/README.md) 的課程。_
## Traces and Spans
Observability 工具如 [Langfuse](https://langfuse.com/) 或 [Microsoft Foundry](https://learn.microsoft.com/en-us/azure/ai-foundry/what-is-azure-ai-foundry) 通常將代理執行表示為 traces 和 spans。
- **Trace** 代表從開始到結束的完整代理任務(例如處理使用者查詢)。
- **Spans** 是 trace 中的個別步驟(例如呼叫語言模型或擷取資料)。
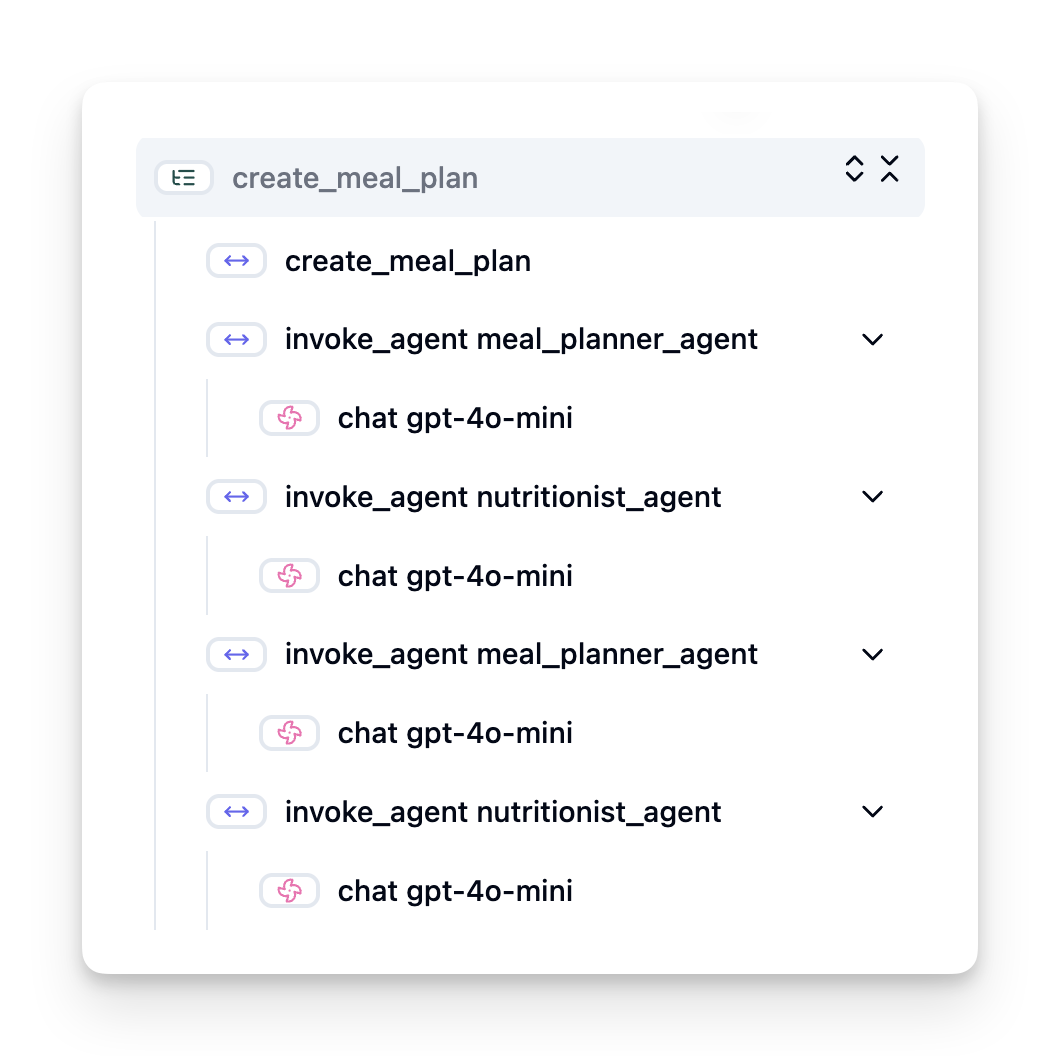
沒有可觀測性,AI 代理可能像一個「黑盒」——其內部狀態與推理不透明,難以診斷問題或優化效能。有了可觀測性後,代理變成「玻璃盒」,提供建構信任並確保其按預期運作所需的重要透明度。
## Why Observability Matters in Production Environments
將 AI 代理轉移到生產環境會帶來一系列新的挑戰與需求。可觀測性不再是「可有可無」,而是一項關鍵能力:
* **除錯與根本原因分析**:當代理失敗或產生意外輸出時,可觀測性工具會提供定位錯誤來源所需的 traces。這在可能涉及多次 LLM 呼叫、工具互動與條件邏輯的複雜代理中尤其重要。
* **延遲與成本管理**:AI 代理通常仰賴按 token 或按呼叫計費的 LLM 及其他外部 API。可觀測性可以精確追蹤這些呼叫,有助於識別過慢或過昂貴的操作。這使團隊能夠優化 prompts、選擇更高效率的模型或重新設計工作流程,以管理營運成本並確保良好使用者體驗。
* **信任、安全與合規**:在許多應用中,確保代理的行為安全且符合倫理相當重要。可觀測性提供代理行為與決策的稽核軌跡。這可用來偵測並緩解如提示注入(prompt injection)、有害內容產生或錯誤處理個人識別資訊(PII)等問題。例如,你可以檢視 traces 以了解代理為何給出特定回應或使用某個工具。
* **持續改進的迴圈**:可觀測性資料是反覆開發流程的基礎。透過監控代理在真實世界的表現,團隊可以識別改進空間、收集用於微調模型的資料,並驗證變更的影響。這建立了一個回饋迴圈,讓生產中的線上評估洞察回饋離線實驗與精進,逐步提升代理的效能。
## Key Metrics to Track
為了監控並理解代理行為,應追蹤一系列指標與訊號。雖然具體指標會依代理用途而異,但有些是普遍重要的。
以下是可觀測性工具通常會監控的一些常見指標:
**Latency:** 代理回應有多快?長時間等待會對使用者體驗造成負面影響。你應該透過追蹤代理執行來測量整體任務以及各個步驟的延遲。例如,一個對所有模型呼叫總共花費 20 秒的代理,可以透過使用更快的模型或並行執行模型呼叫來加速。
**Costs:** 每次代理執行的花費是多少?AI 代理依賴按 token 或外部 API 計費的 LLM 呼叫。頻繁使用工具或多次 prompt 會迅速增加成本。例如,如果代理為了邊際品質提升而呼叫 LLM 五次,你必須評估這樣的成本是否合理,或是否可以減少呼叫次數或改用較便宜的模型。即時監控也能幫助識別意外尖峰(例如程式錯誤導致過度的 API 迴圈)。
**Request Errors:** 代理失敗的請求有多少?這可以包含 API 錯誤或工具呼叫失敗。為了讓代理在生產環境中更穩健,你可以設定備援或重試。例如,如果 LLM 供應商 A 發生故障,你可以切換到供應商 B 作為備援。
**User Feedback:** 實作直接的使用者評估可提供寶貴見解。這可以包含明確評分(👍讚/👎倒讚、⭐1-5 顆星)或文字評論。持續的負面回饋應該引起你的注意,這是代理未按預期運作的警示。
**Implicit User Feedback:** 使用者行為即便沒有明確評分也能提供間接回饋。這可以包含立刻重新措辭問題、重複查詢或點擊重試按鈕。例如,如果你看到使用者反覆問同一個問題,這表示代理可能沒有按預期運作。
**Accuracy:** 代理產生正確或理想輸出的頻率如何?準確性的定義會依情境而異(例如問題解決的正確性、資訊檢索的準確性或使用者滿意度)。第一步是定義你的代理成功的樣貌。你可以透過自動檢查、評分或任務完成標籤來追蹤準確性。例如,將 traces 標註為「成功」或「失敗」。
**Automated Evaluation Metrics:** 你也可以設置自動化評量。例如,你可以使用 LLM 為代理的輸出打分,例如是否有幫助、是否準確等。也有幾個開源函式庫可協助你評分代理的不同面向。例如 [RAGAS](https://docs.ragas.io/) 用於 RAG 代理或 [LLM Guard](https://llm-guard.com/) 用於偵測有害語言或提示注入。
實務上,這些指標的組合可以對 AI 代理的健康狀態提供最佳覆蓋。在本章的 [範例筆記本](./code_samples/10-expense_claim-demo.ipynb),我們將示範這些指標在實例中的樣貌,但首先,我們會先了解典型的評估工作流程。
## Instrument your Agent
為了收集追蹤資料,你需要在程式碼中做埋點。目標是讓代理程式碼輸出可由可觀測性平台擷取、處理與視覺化的 traces 與指標。
**OpenTelemetry (OTel):** [OpenTelemetry](https://opentelemetry.io/) 已成為 LLM 可觀測性的業界標準之一。它提供一套用於產生、收集與匯出遙測資料的 API、SDK 與工具。
有許多埋點函式庫會封裝現有代理框架,並讓你容易將 OpenTelemetry spans 匯出到可觀測性工具。Microsoft Agent Framework 原生整合 OpenTelemetry。以下是對 MAF 代理進行埋點的示例:
```python
from agent_framework.observability import get_tracer, get_meter
tracer = get_tracer()
meter = get_meter()
with tracer.start_as_current_span("agent_run"):
# 代理程式的執行會自動被追蹤。
pass
```
本章的 [範例筆記本](./code_samples/10-expense_claim-demo.ipynb) 將示範如何對你的 MAF 代理進行埋點。
**手動建立 Span:** 雖然埋點函式庫提供良好的基線,但常會遇到需要更細節或自訂資訊的情況。你可以手動建立 spans 以加入自訂的應用程式邏輯。更重要的是,你可以用自訂屬性(也稱為標籤或 metadata)來豐富自動或手動建立的 spans。這些屬性可以包含特定業務資料、中間計算結果或任何對除錯或分析有用的上下文,例如 `user_id`, `session_id`, 或 `model_version`。
以下示範如何使用 [Langfuse Python SDK](https://langfuse.com/docs/sdk/python/sdk-v3) 手動建立 traces 與 spans:
```python
from langfuse import get_client
langfuse = get_client()
span = langfuse.start_span(name="my-span")
span.end()
```
## Agent Evaluation
可觀測性提供我們指標,但評估則是分析那些資料(並執行測試)以判斷 AI 代理表現如何以及如何改進。換句話說,一旦你擁有那些 traces 與指標,你該如何利用它們來評判代理並做出決策?
定期評估很重要,因為 AI 代理通常具備非決定性,且可能會隨著更新或模型行為漂移而演變——沒有評估,你無法知道你的「智慧代理」是否真的在做好它的工作,或是否出現了回歸。
代理的評估分為兩類:**線上評估**與**離線評估**。兩者皆有價值,且互補。我們通常從離線評估開始,因為這是在部署任何代理前的最低必要步驟。
### Offline Evaluation
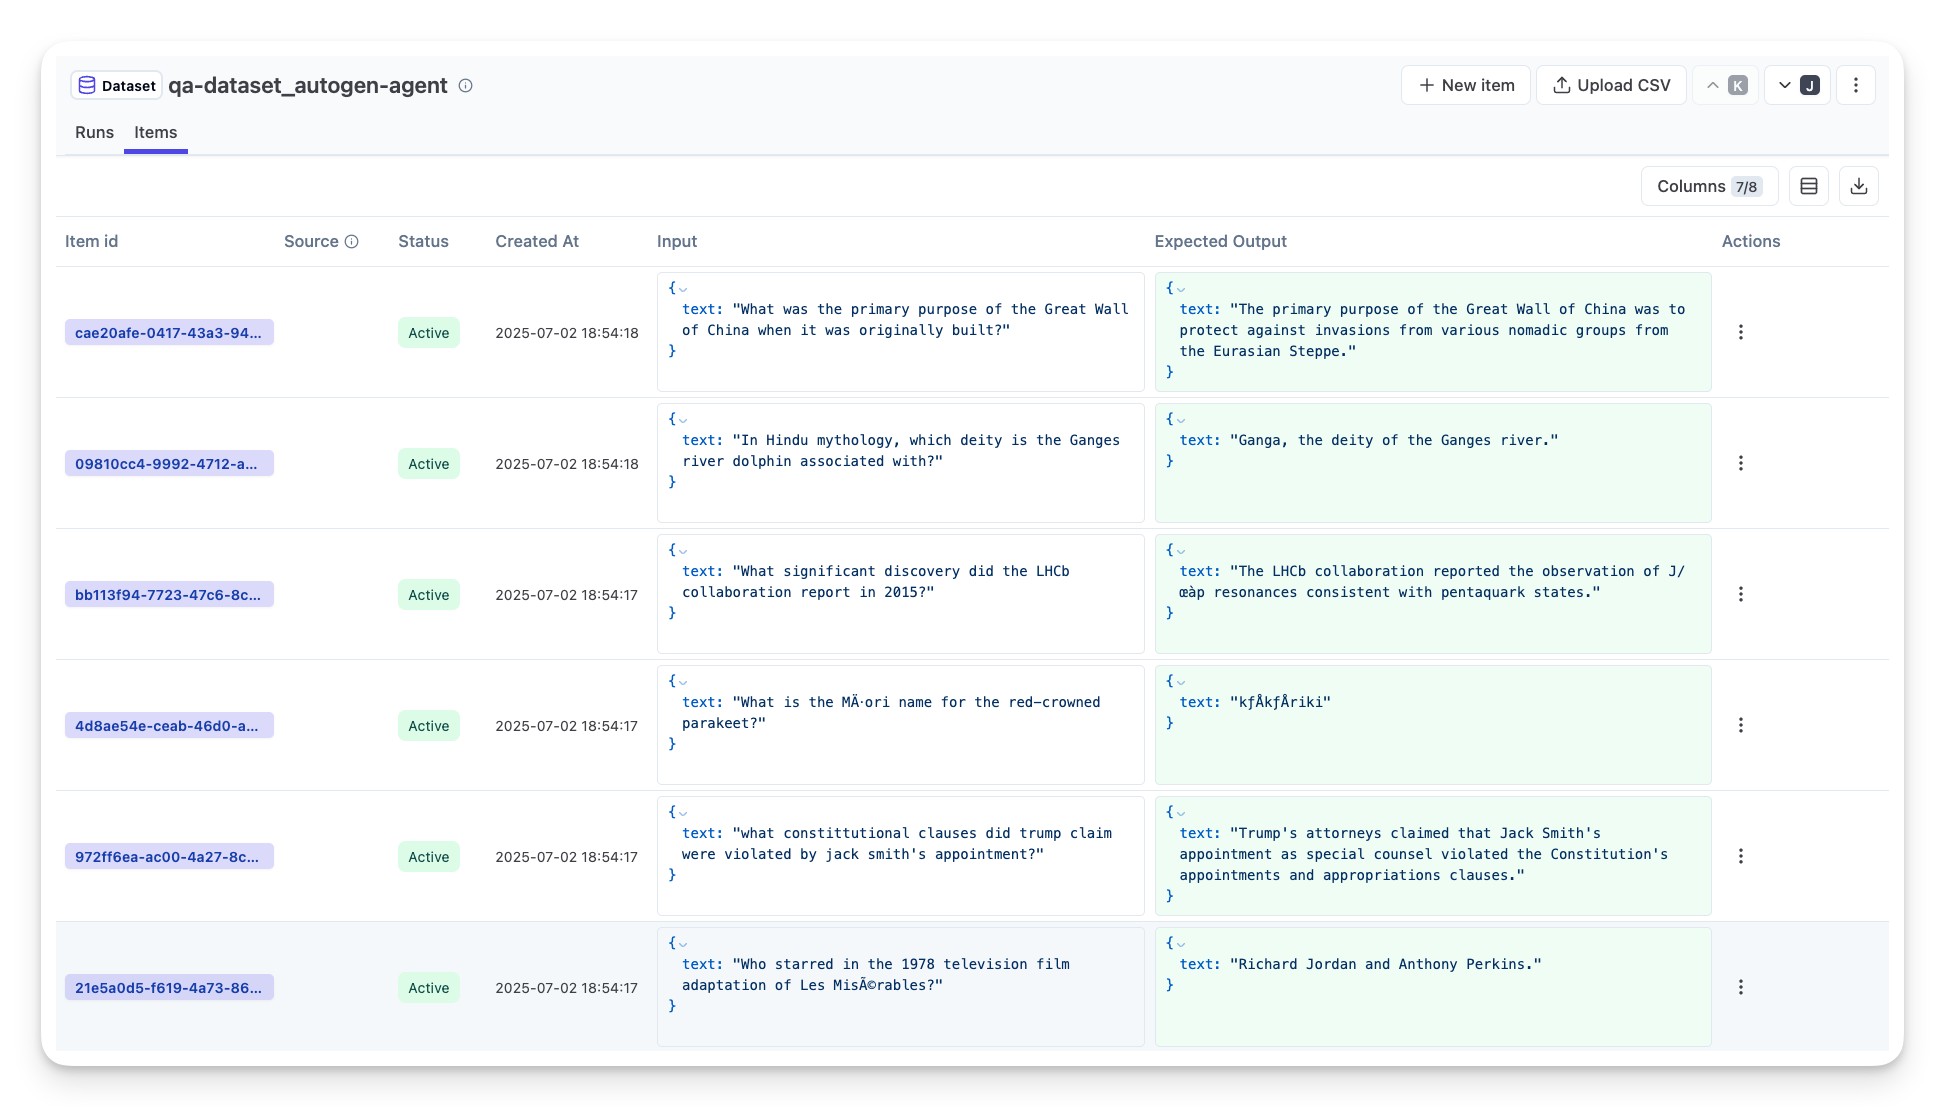
這涉及在受控環境中評估代理,通常使用測試資料集,而非即時的使用者查詢。你會使用已策劃的資料集,其中你知道預期輸出或正確行為,然後讓代理在其上執行。
例如,如果你建立一個數學文字題代理,你可能會有一個包含 100 個已知答案的 [測試資料集](https://huggingface.co/datasets/gsm8k)。離線評估通常在開發期間執行(也可以作為 CI/CD 流程的一部分)以檢查改進或防止回歸。其優點在於**可重複且由於有地面真相,你可以取得明確的準確性指標**。你也可以模擬使用者查詢,並將代理的回應與理想答案進行比對,或如前述使用自動化指標。
離線評估的主要挑戰在於確保你的測試資料集既全面又持續相關——代理可能在固定的測試集上表現良好,但在生產中遇到非常不同的查詢。因此,你應該持續更新測試集,加入能反映真實情境的新邊緣案例與範例。混合小型「冒煙測試」案例與較大型的評估集很有用:小型集合用於快速檢查,較大型集合可提供更廣泛的效能指標。
### Online Evaluation
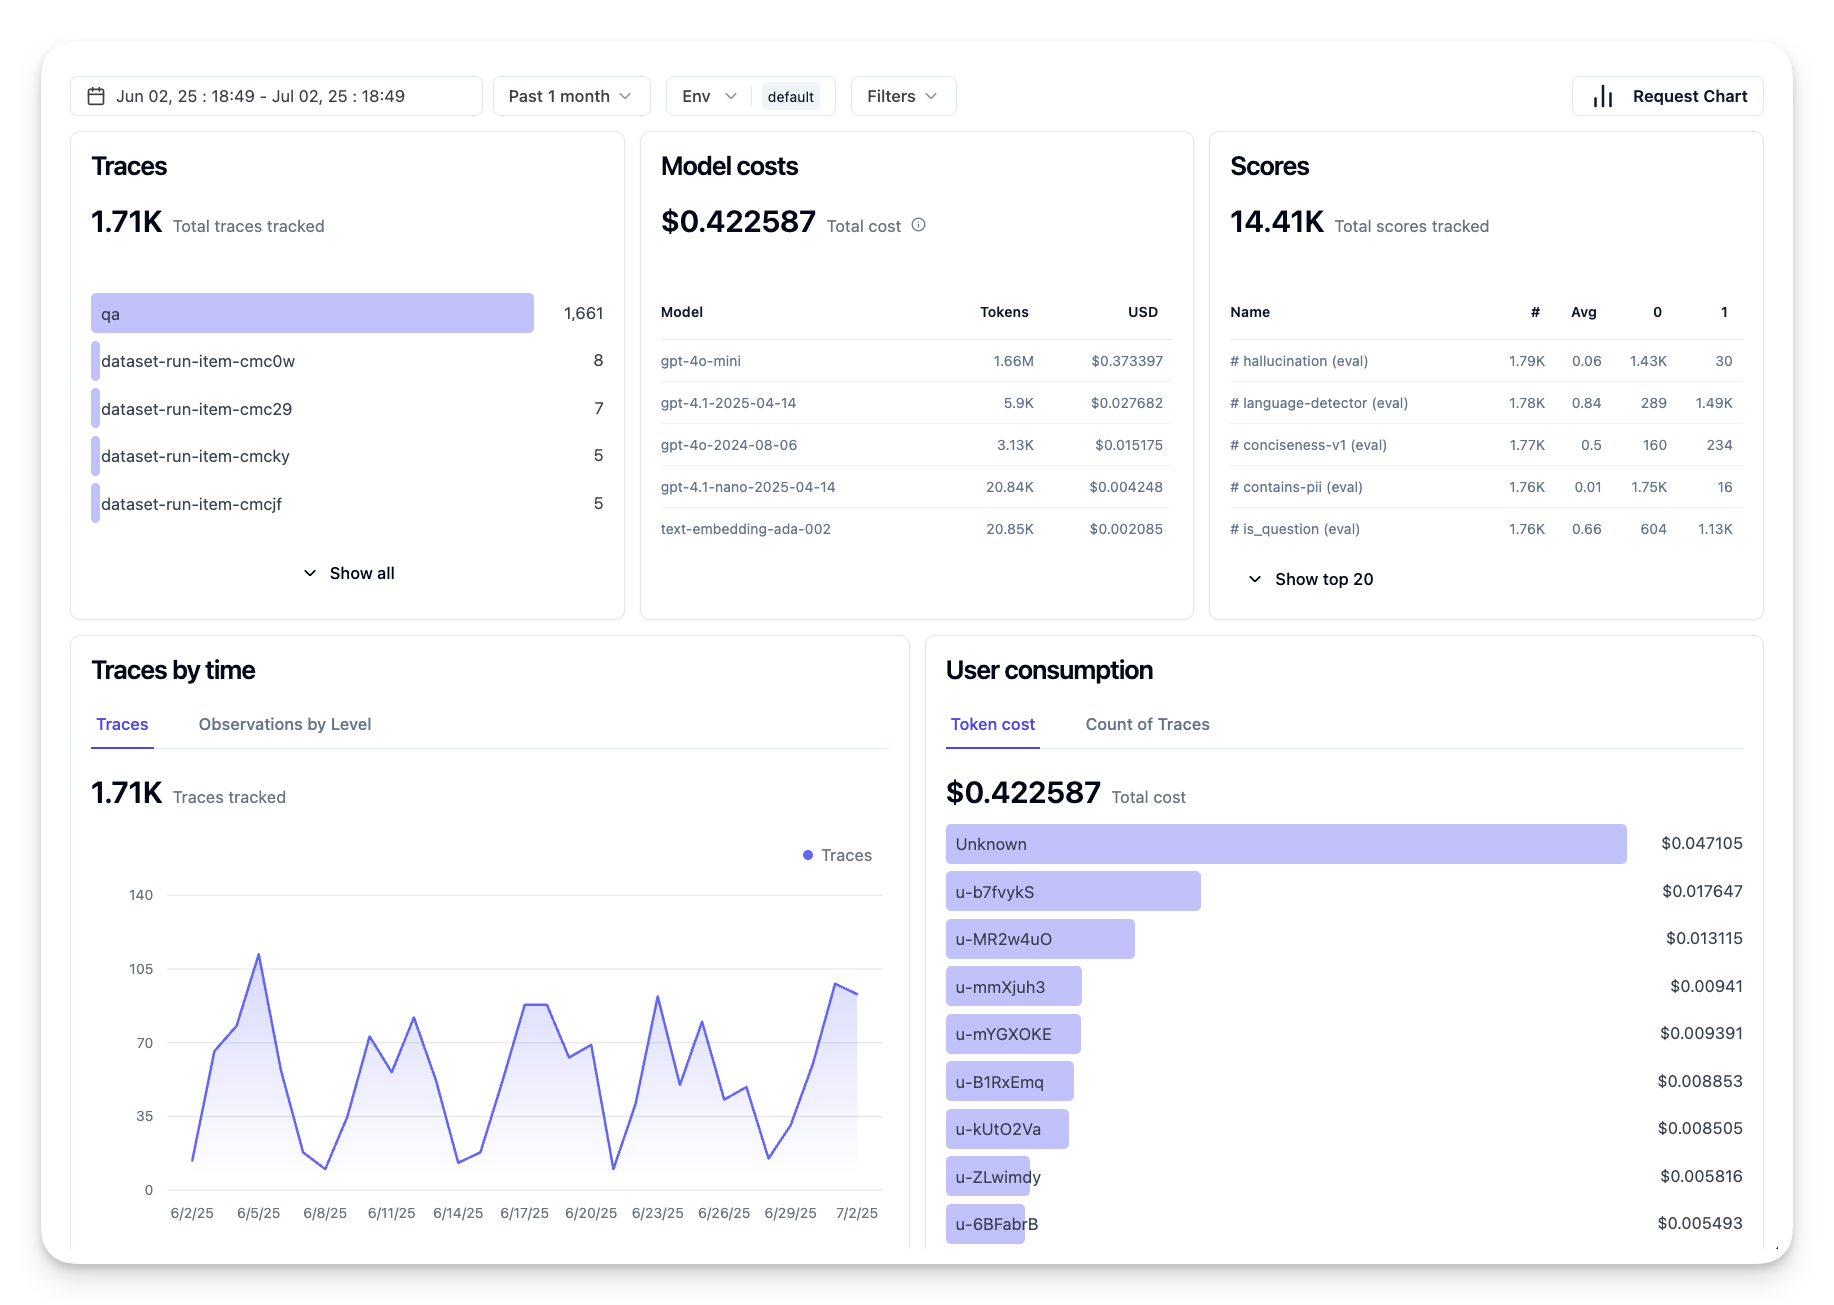
這指的是在實際的真實環境中,也就是在生產中實際使用時對代理進行評估。線上評估包含持續監控代理在真實使用者互動上的表現並分析結果。
例如,你可能會追蹤成功率、使用者滿意度分數或其他在實際流量上的指標。線上評估的優勢在於它**能捕捉你在實驗室環境中可能無法預見的情況**——你可以觀察到模型漂移(當輸入模式改變導致代理效能下降)並捕捉到未出現在測試資料中的意外查詢或情境。它提供了代理在真實環境中行為的真實圖景。
線上評估通常涉及收集隱性與顯性使用者回饋(如前所述),並可能執行 shadow 測試或 A/B 測試(在其中新版本代理與舊版本並行執行以便比較)。挑戰在於要為即時互動取得可靠的標籤或分數可能很困難——你可能得依賴使用者回饋或下游指標(例如使用者是否點擊了結果)。
### Combining the two
線上與離線評估並非互斥;它們高度互補。線上監控的洞察(例如代理在新型使用者查詢上的低效能)可以用來擴充並改良離線測試資料集。反過來,在離線測試中表現良好的代理可以更有信心地部署到生產並在線上監控。
事實上,許多團隊採用一個循環:
_離線評估 -> 部署 -> 線上監控 -> 收集新的失敗案例 -> 加入離線資料集 -> 優化代理 -> 重複_。
## Common Issues
當你將 AI 代理部署到生產環境時,可能會遇到各式挑戰。以下是一些常見問題與其潛在解法:
| **問題** | **可能的解決方案** |
| ------------- | ------------------ |
| AI 代理無法一致地完成任務 | - 精煉給 AI 代理的 prompt;明確設定目標。
- 確認是否可以將任務拆分成子任務,並由多個代理分別處理以改善表現。 |
| AI 代理陷入無限迴圈 | - 確保你有清楚的終止條件,讓代理知道何時停止該流程。
- 對於需要推理與規劃的複雜任務,使用較大且擅長推理的模型。 |
| AI 代理的工具呼叫表現不佳 | - 在代理系統外測試並驗證工具的輸出。
- 精煉所定義的參數、prompts 與工具命名。 |
| 多代理系統表現不穩定 | - 精煉給每個代理的 prompts,確保它們具體且彼此區隔。
- 建構一個階層式系統,使用「路由」或控制代理來決定哪個代理最適合處理該任務。 |
有了可觀測性,前面討論的 traces 與指標能夠精確指出代理工作流程中問題發生的位置,讓除錯與優化更為高效。
## 成本管理
以下是一些管理將 AI 代理部署到生產環境成本的策略:
**使用較小的模型:** 小型語言模型(SLMs)在某些具有代理性的使用案例中表現良好,並能顯著降低成本。正如前面提到的,建立一個評估系統來判定並比較與較大型模型的效能,是了解 SLM 在你的使用情境中表現如何的最佳方式。可考慮在較簡單的任務(例如意圖分類或參數抽取)上使用 SLM,而將較大型模型留給複雜推理。
**使用路由模型:** 類似的策略是使用各種不同型號與規模的模型。你可以使用 LLM/SLM 或無伺服器函式(serverless function)根據複雜度將請求路由到最合適的模型。這不僅能降低成本,還能確保在適當的任務上達到良好效能。例如,將簡單查詢路由到較小且較快的模型,只有在複雜推理任務時才使用昂貴的大型模型。
**快取回應:** 識別常見的請求與任務,並在它們通過你的代理系統之前提供回應,是減少類似請求數量的好方法。你甚至可以實作一個流程,使用較基礎的 AI 模型來判斷一個請求與快取請求的相似度。這個策略能顯著降低常見問題或常見工作流程的成本。
## 讓我們看看這在實務上如何運作
在 [本節的範例筆記本](./code_samples/10-expense_claim-demo.ipynb) 中,我們將會看到如何使用可觀察性工具來監控並評估我們的代理的範例。
### 對於 AI 代理部署到生產環境還有更多問題嗎?
加入 [Microsoft Foundry Discord](https://aka.ms/ai-agents/discord),與其他學習者交流、參加辦公時間並獲得 AI 代理相關問題的解答。
## 前一課
[後設認知設計模式](../09-metacognition/README.md)
## 下一課
[代理協議](../11-agentic-protocols/README.md)
---
免責聲明:
本文件係使用 AI 翻譯服務 [Co-op Translator](https://github.com/Azure/co-op-translator) 進行翻譯。雖然我們力求準確,但請注意自動翻譯可能包含錯誤或不精確之處。原始語言的文件應視為具權威性的版本。對於重要資訊,建議採用專業人工翻譯。我們不對因使用本翻譯而產生的任何誤解或誤譯負責。