 wehub-resource-sync
e06fe8e8c6
13 KiB
Vision Transformer (ViT) vision-transformer-vit
개요 overview
Vision Transformer (ViT) 모델은 Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, Matthias Minderer, Georg Heigold, Sylvain Gelly, Jakob Uszkoreit, Neil Houlsby가 제안한 논문 An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale에서 소개되었습니다. 이는 Transformer 인코더를 ImageNet에서 성공적으로 훈련시킨 첫 번째 논문으로, 기존의 잘 알려진 합성곱 신경망(CNN) 구조와 비교해 매우 우수한 결과를 달성했습니다.
논문의 초록은 다음과 같습니다:
Transformer 아키텍처는 자연어 처리 작업에서 사실상 표준으로 자리 잡았으나, 컴퓨터 비전 분야에서의 적용은 여전히 제한적입니다. 비전에서 어텐션 메커니즘은 종종 합성곱 신경망(CNN)과 결합하여 사용되거나, 전체 구조를 유지하면서 합성곱 신경망의 특정 구성 요소를 대체하는 데 사용됩니다. 우리는 이러한 CNN 의존성이 필요하지 않으며, 이미지 패치를 순차적으로 입력받는 순수한 Transformer가 이미지 분류 작업에서 매우 우수한 성능을 발휘할 수 있음을 보여줍니다. 대규모 데이터로 사전 학습된 후, ImageNet, CIFAR-100, VTAB 등 다양한 중소형 이미지 인식 벤치마크에 적용하면 Vision Transformer(ViT)는 최신 합성곱 신경망과 비교해 매우 우수한 성능을 발휘하면서도 훈련에 필요한 계산 자원을 상당히 줄일 수 있습니다.
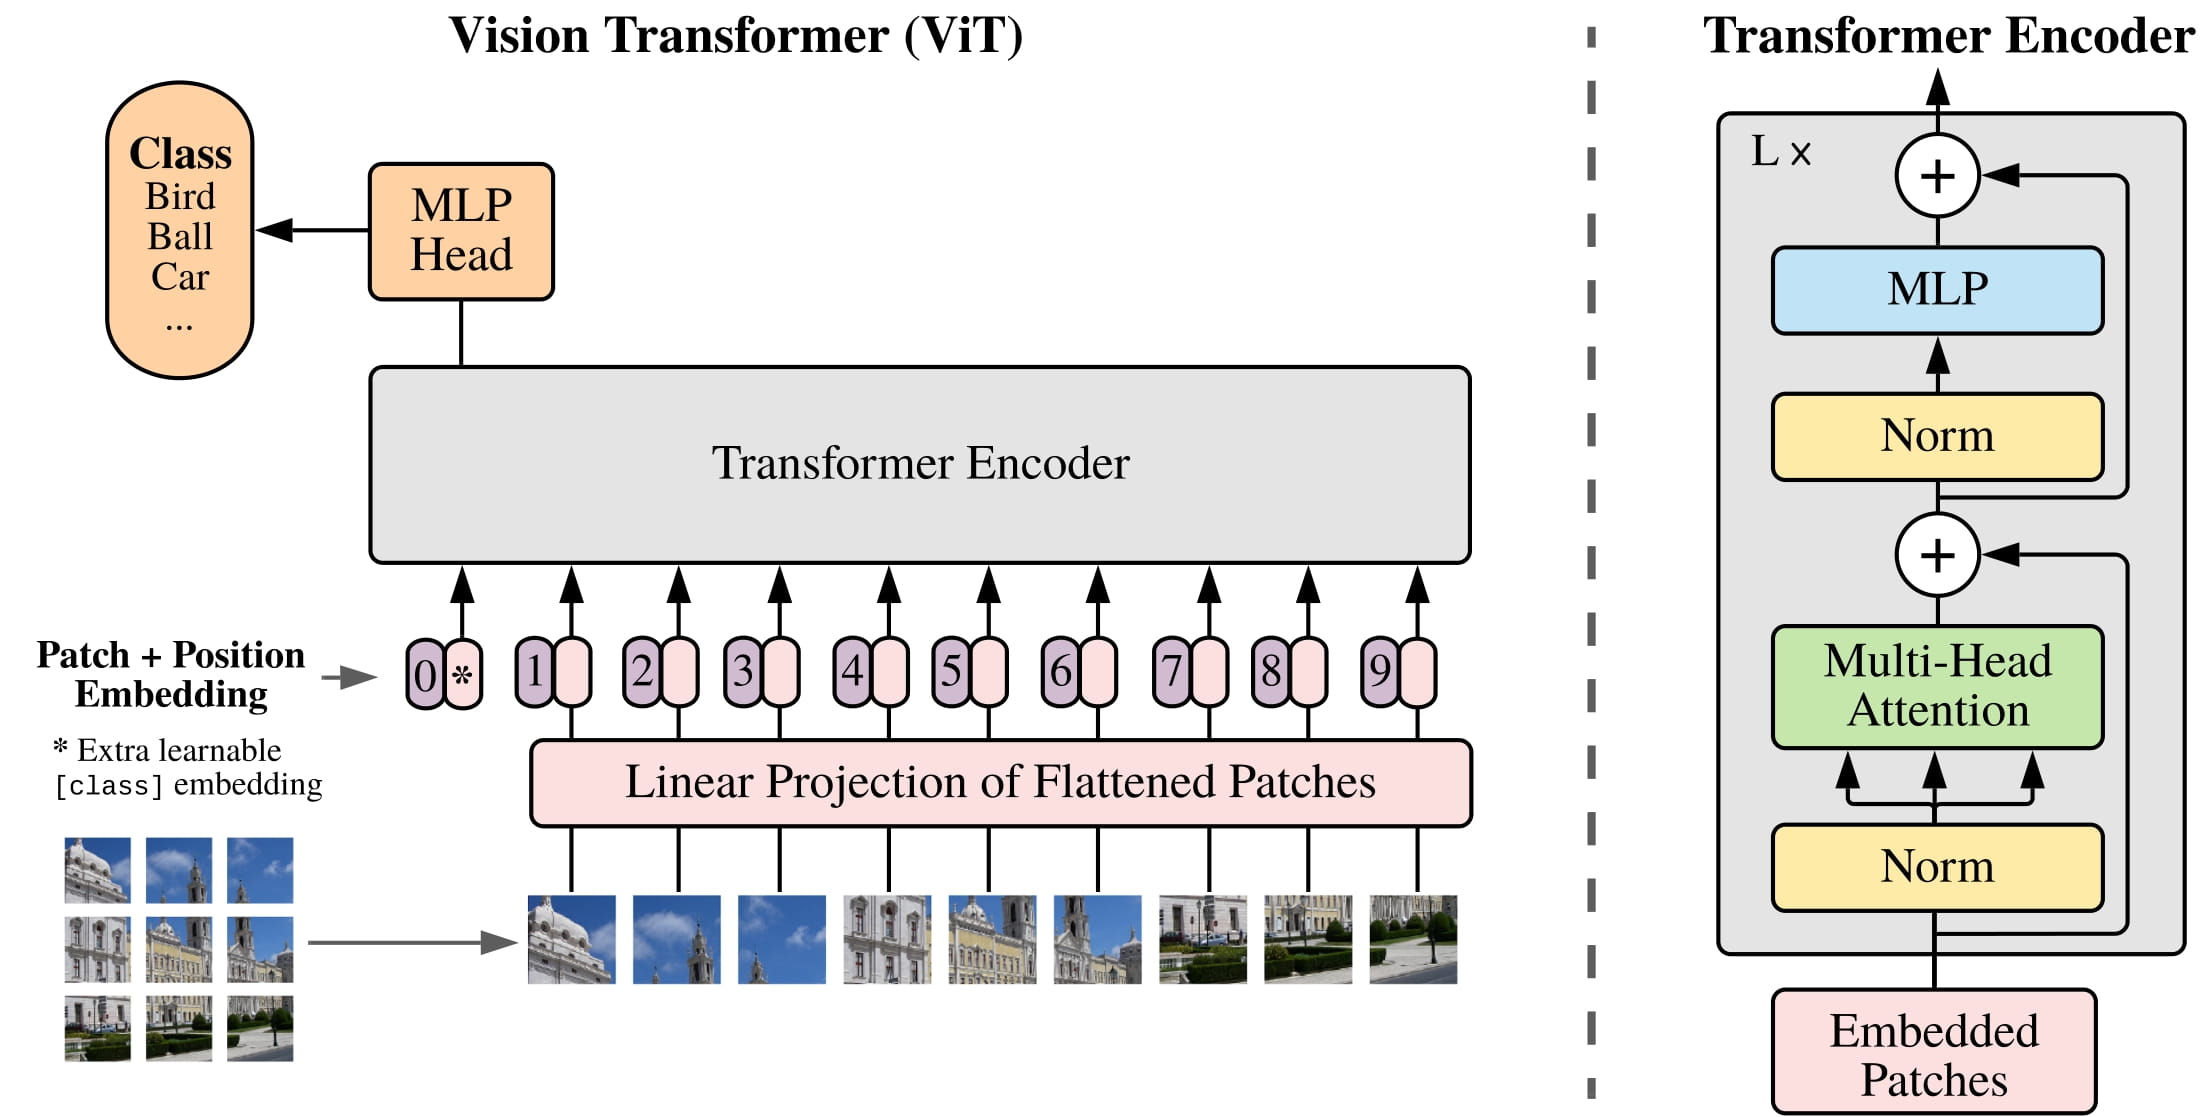
ViT 아키텍처. 원본 논문에서 발췌.
원래의 Vision Transformer에 이어, 여러 후속 연구들이 진행되었습니다:
-
DeiT (Data-efficient Image Transformers) (Facebook AI 개발). DeiT 모델은 distilled vision transformers입니다. DeiT의 저자들은 더 효율적으로 훈련된 ViT 모델도 공개했으며, 이는 [
ViTModel] 또는 [ViTForImageClassification]에 바로 사용할 수 있습니다. 여기에는 3가지 크기로 4개의 변형이 제공됩니다: facebook/deit-tiny-patch16-224, facebook/deit-small-patch16-224, facebook/deit-base-patch16-224 and facebook/deit-base-patch16-384. 그리고 모델에 이미지를 준비하려면 [DeiTImageProcessor]를 사용해야 한다는 점에 유의하십시오. -
BEiT (BERT pre-training of Image Transformers) (Microsoft Research 개발). BEiT 모델은 BERT (masked image modeling)에 영감을 받고 VQ-VAE에 기반한 self-supervised 방법을 이용하여 supervised pre-trained vision transformers보다 더 우수한 성능을 보입니다.
-
DINO (Vision Transformers의 self-supervised 훈련을 위한 방법) (Facebook AI 개발). DINO 방법으로 훈련된 Vision Transformer는 학습되지 않은 상태에서도 객체를 분할할 수 있는 합성곱 신경망에서는 볼 수 없는 매우 흥미로운 능력을 보여줍니다. DINO 체크포인트는 hub에서 찾을 수 있습니다.
-
MAE (Masked Autoencoders) (Facebook AI 개발). Vision Transformer를 비대칭 인코더-디코더 아키텍처를 사용하여 마스크된 패치의 높은 비율(75%)에서 픽셀 값을 재구성하도록 사전 학습함으로써, 저자들은 이 간단한 방법이 미세 조정 후 supervised 방식의 사전 학습을 능가한다는 것을 보여주었습니다.
이 모델은 nielsr에 의해 기여되었습니다. 원본 코드(JAX로 작성됨)은 여기에서 확인할 수 있습니다.
참고로, 우리는 Ross Wightman의 timm 라이브러리에서 JAX에서 PyTorch로 변환된 가중치를 다시 변환했습니다. 모든 공로는 그에게 돌립니다!
사용 팁 usage-tips
- Transformer 인코더에 이미지를 입력하기 위해, 각 이미지는 고정 크기의 겹치지 않는 패치들로 분할된 후 선형 임베딩됩니다. 전체 이미지를 대표하는 [CLS] 토큰이 추가되어, 분류에 사용할 수 있습니다. 저자들은 또한 절대 위치 임베딩을 추가하여, 결과적으로 생성된 벡터 시퀀스를 표준 Transformer 인코더에 입력합니다.
- Vision Transformer는 모든 이미지가 동일한 크기(해상도)여야 하므로, [ViTImageProcessor]를 사용하여 이미지를 모델에 맞게 리사이즈(또는 리스케일)하고 정규화할 수 있습니다.
- 사전 학습이나 미세 조정 시 사용된 패치 해상도와 이미지 해상도는 각 체크포인트의 이름에 반영됩니다. 예를 들어,
google/vit-base-patch16-224는 패치 해상도가 16x16이고 미세 조정 해상도가 224x224인 기본 크기 아키텍처를 나타냅니다. 모든 체크포인트는 hub에서 확인할 수 있습니다. - 사용할 수 있는 체크포인트는 (1) ImageNet-21k (1,400만 개의 이미지와 21,000개의 클래스)에서만 사전 학습되었거나, 또는 (2) ImageNet (ILSVRC 2012, 130만 개의 이미지와 1,000개의 클래스)에서 추가로 미세 조정된 경우입니다.
- Vision Transformer는 224x224 해상도로 사전 학습되었습니다. 미세 조정 시, 사전 학습보다 더 높은 해상도를 사용하는 것이 유리한 경우가 많습니다 ((Touvron et al., 2019), (Kolesnikovet al., 2020). 더 높은 해상도로 미세 조정하기 위해, 저자들은 원본 이미지에서의 위치에 따라 사전 학습된 위치 임베딩의 2D 보간(interpolation)을 수행합니다.
- 최고의 결과는 supervised 방식의 사전 학습에서 얻어졌으며, 이는 NLP에서는 해당되지 않는 경우가 많습니다. 저자들은 마스크된 패치 예측(마스크된 언어 모델링에서 영감을 받은 self-supervised 사전 학습 목표)을 사용한 실험도 수행했습니다. 이 접근 방식으로 더 작은 ViT-B/16 모델은 ImageNet에서 79.9%의 정확도를 달성하였으며, 이는 처음부터 학습한 것보다 2% 개선된 결과이지만, 여전히 supervised 사전 학습보다 4% 낮습니다.
Scaled Dot Product Attention (SDPA) 사용하기 using-scaled-dot-product-attention-sdpa
PyTorch는 torch.nn.functional의 일부로서 native scaled dot-product attention (SDPA) 연산자를 포함하고 있습니다. 이 함수는 입력 및 사용 중인 하드웨어에 따라 여러 구현 방식을 적용할 수 있습니다.자세한 내용은 공식 문서나 GPU 추론 페이지를 참조하십시오.
SDPA는 torch>=2.1.1에서 구현이 가능한 경우 기본적으로 사용되지만, from_pretrained()에서 attn_implementation="sdpa"로 설정하여 SDPA를 명시적으로 요청할 수도 있습니다.
from transformers import ViTForImageClassification
model = ViTForImageClassification.from_pretrained("google/vit-base-patch16-224", attn_implementation="sdpa", dtype=torch.float16)
...
최적의 속도 향상을 위해 모델을 반정밀도(예: torch.float16 또는 torch.bfloat16)로 로드하는 것을 권장합니다.
로컬 벤치마크(A100-40GB, PyTorch 2.3.0, OS Ubuntu 22.04)에서 float32와 google/vit-base-patch16-224 모델을 사용한 추론 시, 다음과 같은 속도 향상을 확인했습니다.
| Batch size | Average inference time (ms), eager mode | Average inference time (ms), sdpa model | Speed up, Sdpa / Eager (x) |
|---|---|---|---|
| 1 | 7 | 6 | 1.17 |
| 2 | 8 | 6 | 1.33 |
| 4 | 8 | 6 | 1.33 |
| 8 | 8 | 6 | 1.33 |
리소스 resources
ViT의 추론 및 커스텀 데이터에 대한 미세 조정과 관련된 데모 노트북은 여기에서 확인할 수 있습니다. Hugging Face에서 공식적으로 제공하는 자료와 커뮤니티(🌎로 표시된) 자료 목록은 ViT를 시작하는 데 도움이 될 것입니다. 이 목록에 포함될 자료를 제출하고 싶다면 Pull Request를 열어 주시면 검토하겠습니다. 새로운 내용을 설명하는 자료가 가장 이상적이며, 기존 자료를 중복하지 않도록 해주십시오.
ViTForImageClassification 은 다음에서 지원됩니다:
- Hugging Face Transformers로 ViT를 이미지 분류에 맞게 미세 조정하는 방법에 대한 블로그 포스트
- Hugging Face Transformers와
Keras를 사용한 이미지 분류에 대한 블로그 포스트 - Hugging Face Transformers를 사용한 이미지 분류 미세 조정에 대한 노트북
- Hugging Face Trainer로 CIFAR-10에서 Vision Transformer 미세 조정에 대한 노트북
- PyTorch Lightning으로 CIFAR-10에서 Vision Transformer 미세 조정에 대한 노트북
⚗️ 최적화
- Optimum을 사용한 양자화를 통해 Vision Transformer(ViT) 가속에 대한 블로그 포스트
⚡️ 추론
🚀 배포
- TF Serving으로 Hugging Face에서 Tensorflow Vision 모델 배포에 대한 블로그 포스트
- Vertex AI에서 Hugging Face ViT 배포에 대한 블로그 포스트
- TF Serving을 사용하여 Kubernetes에서 Hugging Face ViT 배포에 대한 블로그 포스트
ViTConfig transformers.ViTConfig
autodoc ViTConfig
ViTImageProcessor transformers.ViTImageProcessor
autodoc ViTImageProcessor - preprocess
ViTImageProcessorFast transformers.ViTImageProcessorFast
autodoc ViTImageProcessorFast - preprocess
ViTModel transformers.ViTModel
autodoc ViTModel - forward
ViTForMaskedImageModeling transformers.ViTForMaskedImageModeling
autodoc ViTForMaskedImageModeling - forward
ViTForImageClassification transformers.ViTForImageClassification
autodoc ViTForImageClassification - forward