# SuperOffload: 释放超级芯片上大规模LLM训练的潜力
**在单个英伟达GH200超级芯片上高效完成GPT-OSS-20B和Qwen3-14B模型的全参数微调,并在四块英伟达GH200超级芯片上实现Llama3-70B模型的训练,同时提供高达600TFLOPS的训练吞吐量。**
**作者**
[Xinyu Lian](https://xinyulian.tech/)1, [Masahiro Tanaka](https://tohtana.github.io/)2, [Olatunji Ruwase](https://www.snowflake.com/en/blog/authors/olatunji--tunji--ruwase/)3, [Minjia Zhang](https://minjiazhang.github.io/)1
1SSAIL Lab, University of Illinois Urbana-Champaign · 2Anyscale · 3Snowflake
---
## 目录
- [SuperOffload:释放超级芯片上大规模LLM训练的潜力](#superoffload释放超级芯片上大规模llm训练的潜力)
- [SuperOffload的亮点](#superoffload的亮点)
- [介绍](#介绍)
- [SuperOffload的工作原理](#superoffload的工作原理)
- [1. 推测验证机制(STV)](#1-推测验证机制stv)
- [2. 异构优化器计算](#2-异构优化器计算)
- [3. 超级芯片感知的类型转换](#3-超级芯片感知的类型转换)
- [4. GraceAdam:提升优化器效率](#4-graceadam提升优化器效率)
- [经验与洞察](#经验与洞察)
- [快速使用指南](#快速使用指南)
- [致谢](#致谢)
---
## SuperOffload的亮点
- 在**一块GH200**上能够对GPT-OSS-20B和Qwen3-14B进行全参数微调,达到600TFLOPS的运算速度(Seqlen=4K,BS=4)。
- **多卡训练**:在两块英伟达GH200上训练Qwen3-30B-A3B和Seed-OSS-36B,在四块英伟达GH200上训练Llama-70B。
- **训练速度**:在合理的设置下,比ZeRO-Offload快四倍的训练吞吐量。
- **提高显卡利用率**:将显卡利用率从约50%提高到大于80%。
- **灵活组合性**:支持ZeRO-3和Ulysses;一些操作技巧如NUMA绑定和MPAM等已在教程中详细说明。
---
## 介绍
紧密耦合的异构GPU/CPU架构(又称超级芯片)的出现,例如NVIDIA GH200、GB200和AMD MI300A,为大规模AI提供了新的优化机遇。然而,如何充分利用这些新硬件进行大规模LLM训练仍处于探索不足的状态。现有的offloading解决方案是为传统松散耦合架构设计的,在超级芯片上表现欠佳,存在高开销和低GPU利用率的问题。为弥补这一空白并充分利用超级芯片实现高效LLM训练,我们开发并开源了**SuperOffload**。
SuperOffload引入了一系列创新技术,可同时充分利用Hopper GPU、Grace CPU和NVLink-C2C进行LLM训练。与先前假设GPU-CPU互连速度较慢(如PCIe-Gen4的64GB/秒)的offloading解决方案不同,SuperOffload利用更高速的互连技术(如NVLink-C2C的900GB/秒)来提升GPU和CPU利用率及训练吞吐量。借助SuperOffload,诸如**GPT-OSS-20B**、**Qwen3-14B**和**Phi-4**等模型可在单台GH200上完成全参数微调,在常规设置下(序列长度4k,批次大小4)实现高达**600 TFLOPS**的训练吞吐量。与ZeRO-Offload等先前工作相比,此举可实现高达**4倍**的吞吐量提升。SuperOffload还能支持扩展至更大模型,包括在两台GH200上运行Qwen3-30B-A3B和Seed-OSS-36B,以及在四台GH200上运行Llama-70B。
SuperOffload构建于DeepSpeed ZeRO Stage 3之上,并在DeepSpeed [0.18.0]((https://github.com/deepspeedai/DeepSpeed/releases/tag/v0.18.0)及以上版本中提供。为便于集成到LLM微调流程中,SuperOffload与Hugging Face Transformers兼容,且无需对模型代码进行任何修改。

图1:在不同序列长度和批次大小的大型模型微调中,SuperOffload相比ZeRO-Offload可实现高达4倍的吞吐量提升,最高达到600 TFLOPS的吞吐量。
---
## SuperOffload的工作原理
SuperOffload包含四项可组合的offloading优化技术:(1) 推测验证机制,(2) GPU/CPU优化器计算,(3) 超级芯片感知的类型转换,以及(4) GraceAdam优化器。以下我们将简要介绍这些技术。
### 1. 推测验证机制(STV)
在大多数offloading解决方案中,优化器步骤需要CPU和GPU之间的同步以确保数值鲁棒性。例如,梯度norm裁剪需要计算全局梯度norm,混合精度训练需要全局检查NaN和INF值。这些操作要求CPU等待直到收到所有梯度后才能执行优化器步骤和权重更新。STV通过打破这种依赖性来避免此瓶颈,同时通过将CPU上的推测性优化器计算与GPU上的反向传播重叠来保持训练语义。当梯度后处理最终完成时,推测性优化器计算会根据情况被提交、丢弃或正确重放。STV对训练稳定性的后验证使其能够相比先前的前验证方法安全地缩短关键路径。下图展示了SuperOffload如何以不同于传统方法(如ZeRO-Offload)的方式调度反向传播和优化器计算。

图2:以往的offloading方法受限于全局梯度范数计算及全局NaN/INF值检查,导致优化器步骤暴露在关键路径中且无法实现计算重叠。SuperOffload通过引入推测验证调度机制来解决这一问题。
我们通过测量BLOOM-176B模型预训练过程中推测性优化器计算被撤销的频率来评估STV的有效性。如下图所示,这类回滚(例如由于梯度裁剪等原因引起)在预热阶段后很少发生,使得相关开销在整个训练过程中可忽略不计。这使得STV在加速大规模训练方面具有实用性。
图3:红色数据点表示BLOOM预训练过程中触发梯度裁剪的时刻——在预热阶段后极少出现,这表明SuperOffload的STV机制有效消除了由梯度裁剪和NaN/INF检查引起的同步停顿。
---
### 2. 异构优化器计算
SuperOffload通过将优化器计算分区到GPU和CPU上来提升STV之外的优化器效率。GPU用于处理反向传播后期阶段产生的梯度对应的优化器计算,而CPU则负责其余部分。这种分区方案具有多重优势:首先,GPU无需闲置等待CPU完成优化器计算;其次,通过同时利用GPU和CPU的计算资源减少了优化器计算时间;第三,避免了与GPU优化器计算对应的参数和梯度在GPU-CPU间的传输。
---
### 3. 超级芯片感知的类型转换
在采用offloading的混合精度训练中,GPU与CPU之间的张量传输需要在GPU低精度格式(如BF16、FP16等)与CPU高精度格式(即FP32)间进行类型转换。为应对PCIe互连的带宽限制,先前的offloading解决方案采用低精度传输张量,并在GPU和CPU上适时进行类型转换。然而这在超级芯片架构中并非最优策略,因为GPU计算吞吐量约为CPU的100倍,而高带宽互连(如NVLink-C2C)使得传输成本可忽略不计。如图4所示,GH200上的最优策略是在GPU上进行张量类型转换并采用高精度格式传输。
图4:GH200:在超级芯片上,通过GPU进行张量高低精度转换并以高精度格式传输更为高效。
---
### 4. GraceAdam:提升优化器效率
现有用于LLM训练的offloading解决方案需要流行Adam优化器(如PyTorch Adam和DeepSpeed CPU-Adam)的CPU实现版本。然而这些实现并不适用于超级芯片,因为它们未针对Grace CPU架构进行优化。为解决此问题,我们创建了GraceAdam——专为Grace CPU设计的高效Adam优化器实现。GraceAdam通过利用底层ARM架构特性(如可扩展向量扩展SVE、显式内存层次管理和指令级并行)实现高性能。图5显示在GH200超级芯片上,GraceAdam比PyTorch Adam快3倍,比CPU-Adam快1.3倍。据我们所知,GraceAdam是首个面向Grace CPU开源的Adam优化器实现。
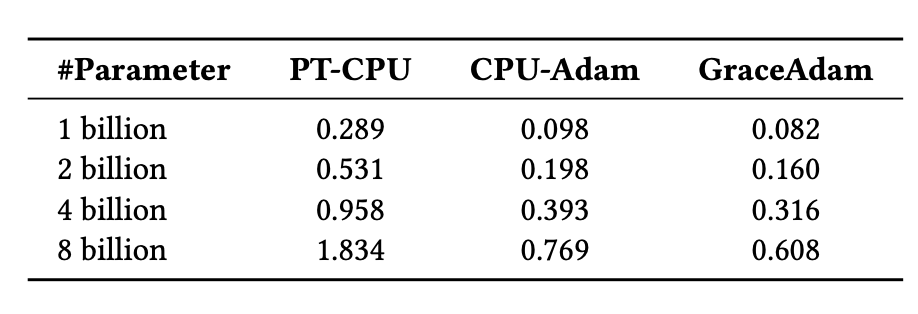
图5:使用GraceAdam在GH200上实现高效Adam优化器计算。
## 经验与洞察
- **NUMA绑定:**
将每个GPU与其直接关联的CPU进行配对以最大化带宽。在DeepSpeed中:
```bash
--bind_cores_to_rank
```
- **MPAM(内存系统资源分区与监控):**
减少CPU与GPU任务间的相互干扰。
**如何在NVIDIA超级芯片上启用MPAM**
1. 安装[NVIDIA NV-Kernels](https://github.com/NVIDIA/NV-Kernels/tree/24.04_linux-nvidia-adv-6.11)提供的内核。
2. 检查MPAM支持情况:
```bash
grep MPAM /boot/config-$(uname -r)
```
预期输出:
```
CONFIG_ARM64_MPAM=y
CONFIG_ACPI_MPAM=y
CONFIG_ARM64_MPAM_DRIVER=y
CONFIG_ARM64_MPAM_RESCTRL_FS=y
```
检查resctrl文件系统:
```bash
ls -ld /sys/fs/resctrl
```
3. 挂载resctrl:
```bash
mount -t resctrl resctrl /sys/fs/resctrl
```
4. 建立分区:
```bash
mkdir /sys/fs/resctrl/p1 /sys/fs/resctrl/p2
```
5. 设定CPU内核与内存配置:
```bash
/sys/fs/resctrl/p1/cpus_list:
0-6
/sys/fs/resctrl/p2/cpus_list:
7-71
/sys/fs/resctrl/p1/schemata:
MB:1=100
L3:1=ff0
/sys/fs/resctrl/p2/schemata:
MB:1=20
L3:1=f
```
---
## 快速使用指南
我们已在教程/说明文档[DeepSpeedExamples: SuperOffload](https://github.com/deepspeedai/DeepSpeedExamples/tree/master/training/DeepSpeed-SuperOffload#readme)中提供了SuperOffload的端到端微调示例。请在DeepSpeed配置中添加以下开关(完整上下文请参阅教程):
图6:通过在DeepSpeed配置中添加单行代码即可启用SuperOffload。
提示:在超级芯片平台(如GH200/GB200/MI300A)上,结合"经验与洞察"章节中的NUMA绑定与MPAM设置,可稳定带宽并提升端到端性能。
---
## 致谢
本成果由[University of Illinois Urbana-Champaign (UIUC)](https://supercomputing-system-ai-lab.github.io/), [Anyscale](https://www.anyscale.com/)与[Snowflake](https://www.snowflake.com/en/blog/authors/snowflake-ai-research/)紧密协作完成。
我们同时衷心感谢美国国家超级计算应用中心的William Gropp、Brett Bode和Gregory H. Bauer,以及NVIDIA的Dan Ernst、Ian Karlin、Giridhar Chukkapalli、Kurt Rago等专家就Grace CPU的MPAM支持提供的宝贵讨论与指导。
欢迎社区反馈与贡献。具体启用方法与示例请参阅前文「快速开始」章节。
---
## BibTeX
```bibtex
@inproceedings{superoffload,
author = {Xinyu Lian and Masahiro Tanaka and Olatunji Ruwase and Minjia Zhang},
title = "{SuperOffload: Unleashing the Power of Large-Scale LLM Training on Superchips}",
year = {2026},
booktitle = {Proceedings of the 31st ACM International Conference on Architectural Support for Programming Languages and Operating System (ASPLOS'26)}
}
```